高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能.
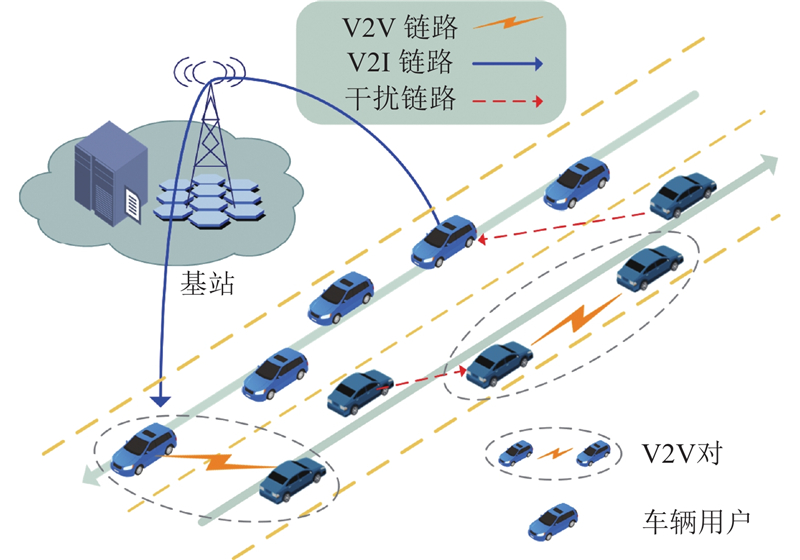
如图1 所示,考虑由基站BS、车辆用户VUE组成的密集城市场景下的车辆网络模型. 车辆通信网络由VL组成,定义 $ v\in \{1,2,\cdots,V\} $ $ v $ $ m\in \{1,2,\cdots,M\} $ $ m $ $ K $ $ \{1,2,\cdots ,K\} $ . VUE 通过 V2I 链路与 BS 交互,以便将收集到的信息传送到云服务器进行处理,并接收云服务器计算出的 RB 分配决定. 在所考虑的二维高速公路场景中,信道随机分布在模拟的二维区域中,第$ m $ $ n $
(20) $ \left.\begin{split}& \underset{d_{m,k}^{t}}{\max }\;{\omega }_{1}{R}^{t}-{\omega }_{2}{Q}^{t}.\\& \text{s.t. }{C}_{1}\colon R_{m}^{t}\geqslant R_{m}^{\text{min}},\\&\quad\;\; {C}_{2}\colon {\overline{Q}}_{k}=\underset{T\rightarrow \mathrm{\infty }}{\lim }\frac{1}{T}\sum \limits_{t=1}^{T}{E}[Q_{k}^{t}]\leqslant {p}_{0}\cdot {Q}_{{\mathrm{max}}},\\&\quad\;\; {C}_{3}\colon Q_{k}^{t}\leqslant {Q}_{\max },\\&\quad\;\; {C}_{4}\colon R_{k}^{{m}}\in \{0,1\}.\end{split}\right\} $
[1]
ZHANG X, LI J, ZHOU J, et al Vehicle-to-everything communication in intelligent connected vehicles: a survey and taxonomy
[J]. Automotive Innovation , 2025 , 8 (1 ): 13 - 45
DOI:10.1007/s42154-024-00310-2
[本文引用: 1]
[2]
MEI R, WANG Z Multi-agent deep reinforcement learning-based resource allocation for cognitive radio networks
[J]. IEEE Transactions on Vehicular Technology , 2025 , 74 (3 ): 4744 - 4757
DOI:10.1109/TVT.2024.3486156
[本文引用: 1]
[3]
MEI J, ZHENG K, ZHAO L, et al Joint radio resource allocation and control for vehicle platooning in LTE-V2V network
[J]. IEEE Transactions on Vehicular Technology , 2018 , 67 (12 ): 12218 - 12230
DOI:10.1109/TVT.2018.2874722
[本文引用: 1]
[4]
WU Q, ZHENG J. Performance modeling of IEEE 802.11 DCF based fair channel access for vehicular-to-roadside communication in a non-saturated state [C]// Proceedings of the IEEE International Conference on Communications . Sydney: IEEE, 2014: 2575–2580.
[本文引用: 1]
[5]
TIAN J, LIU Q, ZHANG H, et al Multiagent deep-reinforcement-learning-based resource allocation for heterogeneous QoS guarantees for vehicular networks
[J]. IEEE Internet of Things Journal , 2022 , 9 (3 ): 1683 - 1695
DOI:10.1109/JIOT.2021.3089823
[本文引用: 1]
[6]
HUANG J, ZHANG S, YANG F, et al Hypergraph-based interference avoidance resource management in customer-centric communication for intelligent cyber-physical transportation systems
[J]. IEEE Transactions on Consumer Electronics , 2024 , 70 (1 ): 1775 - 1786
DOI:10.1109/TCE.2023.3324680
[本文引用: 1]
[7]
YE H, LI G Y, JUANG B F Deep reinforcement learning based resource allocation for V2V communications
[J]. IEEE Transactions on Vehicular Technology , 2019 , 68 (4 ): 3163 - 3173
DOI:10.1109/TVT.2019.2897134
[本文引用: 1]
[8]
HUANG J, LAI X, YANG F, et al Ellipsoid-based learning for robust resource allocation with differentiated QoS in massive Internet of vehicles networks
[J]. IEEE Transactions on Vehicular Technology , 2025 , 74 (7 ): 11425 - 11435
DOI:10.1109/TVT.2025.3546243
[9]
ERNEST T Z H, MADHUKUMAR A S Computation offloading in MEC-enabled IoV networks: average energy efficiency analysis and learning-based maximization
[J]. IEEE Transactions on Mobile Computing , 2024 , 23 (5 ): 6074 - 6087
DOI:10.1109/TMC.2023.3315275
[10]
崔亚平, 石宏吉, 吴大鹏, 等 内容新鲜度保障的车联网多智能体缓存分发策略
[J]. 通信学报 , 2025 , 46 (1 ): 52 - 66
DOI:10.11959/j.issn.1000-436x.2025013
[本文引用: 2]
CUI Yaping, SHI Hongji, WU Dapeng, et al Multi-agent caching distribution strategy for content freshness guarantee in IoV
[J]. Journal on Communications , 2025 , 46 (1 ): 52 - 66
DOI:10.11959/j.issn.1000-436x.2025013
[本文引用: 2]
[11]
GAO A, ZHU Z, ZHANG J, et al Matching combined heterogeneous multi-agent reinforcement learning for resource allocation in NOMA-V2X networks
[J]. IEEE Transactions on Vehicular Technology , 2024 , 73 (10 ): 15109 - 15124
[本文引用: 1]
[12]
PARVINI M, JAVAN M R, MOKARI N, et al AoI-aware resource allocation for platoon-based C-V2X networks via multi-agent multi-task reinforcement learning
[J]. IEEE Transactions on Vehicular Technology , 2023 , 72 (8 ): 9880 - 9896
DOI:10.1109/TVT.2023.3259688
[本文引用: 1]
[13]
宋晓勤, 张文静, 雷磊, 等 多目标联合优化的车联网动态资源分配算法
[J]. 东南大学学报: 自然科学版 , 2025 , 55 (1 ): 266 - 274
[本文引用: 1]
SONG Xiaoqin, ZHANG Wenjing, LEI Lei, et al Dynamic resource allocation algorithm for multi-objective joint optimization in Internet of vehicle
[J]. Journal of Southeast University: Natural Science Edition , 2025 , 55 (1 ): 266 - 274
[本文引用: 1]
[14]
JI Y, WANG Y, ZHAO H, et al Multi-agent reinforcement learning resources allocation method using dueling double deep Q-network in vehicular networks
[J]. IEEE Transactions on Vehicular Technology , 2023 , 72 (10 ): 13447 - 13460
DOI:10.1109/TVT.2023.3275546
[本文引用: 1]
[15]
ZHANG X, ZHANG H, TANG H, et al A scalable mean-field MARL framework for multi-objective V2X resource allocation
[J]. IEEE Transactions on Intelligent Vehicles , 2025 , 10 (2 ): 1071 - 1086
DOI:10.1109/TIV.2024.3422506
[本文引用: 1]
[16]
CHEN C, WANG W, LIU Z, et al RLFN-VRA: reinforcement learning-based flexible numerology V2V resource allocation for 5G NR V2X networks
[J]. IEEE Transactions on Intelligent Vehicles , 2025 , 10 (2 ): 1379 - 1390
DOI:10.1109/TIV.2024.3427399
[本文引用: 2]
[17]
HUANG J, YANG C, ZHANG S, et al Reinforcement learning based resource management for 6G-enabled mIoT with hypergraph interference model
[J]. IEEE Transactions on Communications , 2024 , 72 (7 ): 4179 - 4192
DOI:10.1109/TCOMM.2024.3372892
[本文引用: 1]
[18]
YANG J, MA Y, XIAO Z, et al Joint access selection, computation offloading, and resource allocation in LEO ubiquitous edge computing networks
[J]. IEEE Internet of Things Journal , 2025 , 12 (23 ): 51746 - 51760
DOI:10.1109/JIOT.2025.3616653
[本文引用: 1]
[19]
MEI J, ZHENG K, ZHAO L, et al A latency and reliability guaranteed resource allocation scheme for LTE V2V communication systems
[J]. IEEE Transactions on Wireless Communications , 2018 , 17 (6 ): 3850 - 3860
DOI:10.1109/TWC.2018.2816942
[本文引用: 1]
[20]
HUANG Q, YI X, QI F, et al Enhancing 5G V2X URLLC broadcast/multicast services with FL-based wireless resource allocation
[J]. IEEE Transactions on Broadcasting , 2025 , 71 (2 ): 384 - 396
DOI:10.1109/TBC.2025.3541887
[本文引用: 1]
[21]
ALWARAFY A, ABDALLAH M, ÇIFTLER B S, et al The frontiers of deep reinforcement learning for resource management in future wireless HetNets: techniques, challenges, and research directions
[J]. IEEE Open Journal of the Communications Society , 2022 , 3 : 322 - 365
DOI:10.1109/OJCOMS.2022.3153226
[22]
RUAN Z, YU C. Causality-guided exploration for multi-agent reinforcement learning [C]// Proceedings of the IEEE International Conference on Agents . Wollongong: IEEE, 2024: 56–59.
[23]
ARANA-CATANIA M, SONEE A, KHAN A M, et al Explainable reinforcement and causal learning for improving trust to 6G stakeholders
[J]. IEEE Open Journal of the Communications Society , 2025 , 6 : 4101 - 4125
DOI:10.1109/OJCOMS.2025.3563415
[本文引用: 1]
[24]
LIANG L, YE H, LI G Y Spectrum sharing in vehicular networks based on multi-agent reinforcement learning
[J]. IEEE Journal on Selected Areas in Communications , 2019 , 37 (10 ): 2282 - 2292
DOI:10.1109/JSAC.2019.2933962
[本文引用: 1]
[25]
ZENG J, KUANG Z, CHEN R, et al Delay-sensitive dependent tasks offloading and resource allocation in VEC: a deep-reinforcement learning approach
[J]. IEEE Internet of Things Journal , 2025 , 12 (16 ): 34190 - 34203
DOI:10.1109/JIOT.2025.3577449
[本文引用: 1]
[26]
VU H V, FARZANULLAH M, LIU Z, et al. Multi-agent reinforcement learning for channel assignment and power allocation in platoon-based C-V2X systems [C]// Proceedings of the IEEE 95th Vehicular Technology Conference . Helsinki: IEEE, 2022: 1–5.
[本文引用: 1]
[27]
LIU X, LIU J, LI W Truthful mechanism for resource allocation and pricing in vehicle-assisted mobile edge computing
[J]. IEEE Transactions on Vehicular Technology , 2025 , 74 (5 ): 8171 - 8186
DOI:10.1109/TVT.2025.3526935
[本文引用: 1]
[28]
3GPP. Study on LTE-based V2X services: TR 36.885 [S]. Valbonne: 3GPP, 2016.
[本文引用: 1]
[30]
LI Y, WANG N, BAI N, et al. Resource allocation for V2V-enabled vehicular communications based on hypergraph partition [C]// Proceedings of the International Conference on Microwave and Millimeter Wave Technology . Qingdao: IEEE, 2023: 1–3.
[本文引用: 1]
[31]
BAI B, DENG J, JIN X, et al Hypergraph based resource allocation algorithms for VLC network with heterogeneous LEDs and varied users
[J]. IEEE Photonics Journal , 2021 , 13 (4 ): 7300810
DOI:10.1109/jphot.2021.3103660
[本文引用: 1]
Vehicle-to-everything communication in intelligent connected vehicles: a survey and taxonomy
1
2025
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
Multi-agent deep reinforcement learning-based resource allocation for cognitive radio networks
1
2025
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
Joint radio resource allocation and control for vehicle platooning in LTE-V2V network
1
2018
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
1
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
Multiagent deep-reinforcement-learning-based resource allocation for heterogeneous QoS guarantees for vehicular networks
1
2022
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
Hypergraph-based interference avoidance resource management in customer-centric communication for intelligent cyber-physical transportation systems
1
2024
... 联网车辆和安全关键型应用的迅速增长,使车联网面临更为严格的时延与可靠性目标[1 -2 ] . 根据C-V2X和IEEE 802.11p标准,周期性安全信标与事件触发的警报必须在100 ms内完成传输,以确保在高速公路场景下的防碰撞效果[3 ] . 在高速公路场景中,车辆间的高相对速度使信道呈现出显著的快速时变特性,导致无线链路条件快速且不可预测地波动[4 ] . 这种快速时变性会引发非平稳衰落,使在频谱复用条件下同时满足低时延与高吞吐需求变得极具挑战[5 -6 ] . ...
Deep reinforcement learning based resource allocation for V2V communications
1
2019
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
Ellipsoid-based learning for robust resource allocation with differentiated QoS in massive Internet of vehicles networks
0
2025
Computation offloading in MEC-enabled IoV networks: average energy efficiency analysis and learning-based maximization
0
2024
内容新鲜度保障的车联网多智能体缓存分发策略
2
2025
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
... [10 -16 ]. 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
Matching combined heterogeneous multi-agent reinforcement learning for resource allocation in NOMA-V2X networks
1
2024
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
AoI-aware resource allocation for platoon-based C-V2X networks via multi-agent multi-task reinforcement learning
1
2023
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
多目标联合优化的车联网动态资源分配算法
1
2025
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
Multi-agent reinforcement learning resources allocation method using dueling double deep Q-network in vehicular networks
1
2023
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
A scalable mean-field MARL framework for multi-objective V2X resource allocation
1
2025
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
RLFN-VRA: reinforcement learning-based flexible numerology V2V resource allocation for 5G NR V2X networks
2
2025
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
... [16 ]采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
Reinforcement learning based resource management for 6G-enabled mIoT with hypergraph interference model
1
2024
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
Joint access selection, computation offloading, and resource allocation in LEO ubiquitous edge computing networks
1
2025
... 高效的资源分配机制能够缓解高速环境下非平稳衰落带来的干扰问题. 传统的设备到设备(device-to-device, D2D)优化方法通常要求解NP难问题,当高速条件下信道时变性强、服务质量(quality of service, QoS)需求异构、环境不确定性显著时,这类方法难以实用. 此外,传统方法往往忽略在高速移动条件下链路间动态的协作与竞争的关系. 在此背景下,多智能体强化学习(multi-agent reinforcement learning, MARL)将每条高速车对车通信(vehicle-to-vehicle, V2V) 链路(vehicular link, VL)建模为智能体,该智能体能够从快速变化的局部观测中学习策略并与相邻智能体协作,为高速公路场景下的 V2V 资源分配提供创新且有效的思路[7 -10 ] . 已有多种 MARL 技术被用于支持低时延车联网通信,研究重点包括吞吐量最大化、排队时延最小化、能效优化以及车辆协作编队等[10 -16 ] . 例如,Gao等[11 ] 将一对多匹配博弈与异构多智能体深度确定性策略梯度算法(multi-agent deep deterministic policy gradient, MADDPG)相结合,实现分布式优化,不仅显著提升了车对基础设施通信(vehicle-to-infrastructure, V2I) 上行总吞吐量,还缩短了收敛时间. 在编队场景中,Parvini等[12 ] 改进了MADDPG,引入双重评论家以及任务分解机制,以平衡协作与个体奖励,使平均信息新鲜度保持在毫秒级,改进的算法优于基线方法. 为了解决多用户干扰导致的通信传输性能下降问题,宋晓勤等[13 ] 提出基于多智能体增强型双深度Q网络(enhanced double deep Q-network,EDDQN)的多目标联合优化资源分配算法,有效提高了通信传输性能. Ji等[14 ] 提出引入低维“指纹”特征和软更新机制的Dueling Double深度Q网络(deep Q network, DQN),在高流量条件下依然能保持可靠的 V2V 通信,并提升 V2I 链路容量. 为了提升车联万物(vehicle-to-everything, V2X)网络中的频谱与功率协同效率,Zhang等[15 ] 在MARL框架下引入参数共享机制,使单一共享策略模型能够适配不同车辆密度,在低训练开销下保持接近最优的资源分配性能. Chen等[16 ] 采用深度强化学习动态配置子载波间隔,在车端分布式选择频谱资源,提高了传输可靠性. 当单一集中式控制器为所有智能体统一决策时,策略往往缺乏多样性. 为此,Huang等[17 -18 ] 采用集中训练、分布执行(centralized training with decentralized execution,CTDE)范式,提出基于效用最大化的资源分配算法,实现了更快的收敛和更优的系统性能. ...
A latency and reliability guaranteed resource allocation scheme for LTE V2V communication systems
1
2018
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
Enhancing 5G V2X URLLC broadcast/multicast services with FL-based wireless resource allocation
1
2025
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
The frontiers of deep reinforcement learning for resource management in future wireless HetNets: techniques, challenges, and research directions
0
2022
Explainable reinforcement and causal learning for improving trust to 6G stakeholders
1
2025
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
Spectrum sharing in vehicular networks based on multi-agent reinforcement learning
1
2019
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
Delay-sensitive dependent tasks offloading and resource allocation in VEC: a deep-reinforcement learning approach
1
2025
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
1
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
Truthful mechanism for resource allocation and pricing in vehicle-assisted mobile edge computing
1
2025
... MARL在高速场景下的应用仍面临挑战. 高速移动导致信道快速时变、相干时间显著缩短,引发信道状态信息(channel state information,CSI)获取开销增加与 CSI 时效性退化[19 ] ,使得传统强化学习算法的状态输入存在滞后和偏差. 车联网中链路间的干扰在频谱复用条件下表现出时变、非平稳的特征:多个链路可能同时占用同一频谱资源,干扰叠加关系随时间演化而变化[20 -23 ] . 现有方法主要依赖浅层的相关性建模,忽略了这种高阶结构的存在. 例如,Liang等[24 -25 ] 采用DQN实现联合信道与功率分配,以最大化城市道路网络中 V2V 传输成功率与车对网络(vehicle-to-network, V2N)总速率;Vu等[26 ] 在排队场景下将该方法扩展为 Double DQN,用于同一目标;针对时变CSI场景,Liu等[27 ] 采用分布式 MARL进行子信道选择与功率控制,提升了V2V 与 V2I 链路的数据包传输成功率. 虽然这些工作在高速、动态网络拓扑下场景取得了一定效果,但较少考虑链路间的多对多干扰模式. 在快时变场景下,大量链路间的干扰对性能波动的响应往往滞后,策略更新缺乏结构一致性,甚至在高干扰时隙中发生不稳定收敛. 因此,如何在高速非平稳的车联网环境中准确建模多链路同时参与并产生联合叠加效应的干扰结构(高阶干扰结构),并在此基础上实现稳定高效的联合资源分配,是亟待解决的问题. 本研究提出基于因果超图神经网络(hypergraph neural network,HGNN)的多智能体近端策略优化算法(multi-agent proximal policy optimization,MAPPO),利用超图结构融合车联网中的网络拓扑、频谱资源与功率信息来刻画多链路间的联合干扰特征,结合多智能体强化学习框架以提高车联网网络吞吐量并降低时延. ...
1
... 式中:$ P_{m}^{k} $ $ P_{n}^{k} $ $ n\in {M} $ $ m $ $ n $ $ G_{m}^{k} $ $ m $ $ G_{n,m}^{k} $ $ n $ $ {C}_{m} $ $ m $ $ z_{m}^{k}\sim {{\mathrm{CN}}}(0,\; {\sigma }^{2}) $ $ {\sigma }^{2} $ $ {\sigma }^{2} $ [28 ] 来建立系统模型. 根据该模型,车辆之间的V2V链路主要视为视距(line-of-sight, LoS)传输. 当发射车与接收车距离小于一定的断点距离$ {d}_{{\mathrm{bp}}} $ [29 ] ;超过断点距离后,路径损耗采用双径段模型计算,综合考虑发射端和接收端天线高度以及载波频率等因素,路径损耗表达式为 ...
A note on a simple transmission formula
1
1946
... 式中:$ P_{m}^{k} $ $ P_{n}^{k} $ $ n\in {M} $ $ m $ $ n $ $ G_{m}^{k} $ $ m $ $ G_{n,m}^{k} $ $ n $ $ {C}_{m} $ $ m $ $ z_{m}^{k}\sim {{\mathrm{CN}}}(0,\; {\sigma }^{2}) $ $ {\sigma }^{2} $ $ {\sigma }^{2} $ [28 ] 来建立系统模型. 根据该模型,车辆之间的V2V链路主要视为视距(line-of-sight, LoS)传输. 当发射车与接收车距离小于一定的断点距离$ {d}_{{\mathrm{bp}}} $ [29 ] ;超过断点距离后,路径损耗采用双径段模型计算,综合考虑发射端和接收端天线高度以及载波频率等因素,路径损耗表达式为 ...
1
... 在 V2V 网络中,多链路共享同一频谱会形成复杂的高阶干扰结构,而传统图模型难以表征此类多对多关系[30 -31 ] . 为了使超图具备因果可解释性,在构建过程中引入必要的前置假设. 车辆位置、发射功率、RB 占用情况和局部 SINR 等关键链路状态在短时间窗口内可观测;环境扰动在该时间窗口内相对平稳,不存在显著的未观测混杂因素;资源分配动作可视为可干预变量,链路级反馈可用于对超边的方向和强度进行弱监督验证. 在此基础上,构建因果超图$ G=\{V,E\} $
Hypergraph based resource allocation algorithms for VLC network with heterogeneous LEDs and varied users
1
2021
... 在 V2V 网络中,多链路共享同一频谱会形成复杂的高阶干扰结构,而传统图模型难以表征此类多对多关系[30 -31 ] . 为了使超图具备因果可解释性,在构建过程中引入必要的前置假设. 车辆位置、发射功率、RB 占用情况和局部 SINR 等关键链路状态在短时间窗口内可观测;环境扰动在该时间窗口内相对平稳,不存在显著的未观测混杂因素;资源分配动作可视为可干预变量,链路级反馈可用于对超边的方向和强度进行弱监督验证. 在此基础上,构建因果超图$ G=\{V,E\} $