[1]
陈江浩, 杨军 结合深度可分离卷积的多源遥感融合影像目标检测
[J]. 浙江大学学报: 工学版 , 2025 , 59 (12 ): 2545 - 2555
[本文引用: 1]
CHEN Jianghao, YANG Jun Object detection for multi-source remote sensing fused images based on depthwise separable convolution
[J]. Journal of Zhejiang University: Engineering Science , 2025 , 59 (12 ): 2545 - 2555
[本文引用: 1]
[2]
AHMED W, KOMMINENI V K, KÖNIG-RIES B, et al Evaluating the method reproducibility of deep learning models in biodiversity research
[J]. PeerJ Computer Science , 2025 , 11 : e2618
[本文引用: 1]
[3]
BHARATHI V, RANJITHA M An optimized deep learning method for automatic translator for ancient hieroglyphic language from scanned images to English text
[J]. SN Computer Science , 2025 , 6 (6 ): 639
DOI:10.1007/s42979-025-04165-0
[本文引用: 1]
[4]
EL-TAHER A, AZAB S, MOHAMMED A. From artifact to text: a novel deep learning approach for ancient Egyptian language processing [C]// Proceedings of the Intelligent Methods, Systems, and Applications . Giza: IEEE, 2025: 434–441.
[本文引用: 1]
[5]
JHA K, JAIN A, SRIVASTAVA S A challenge-response based authentication approach for multimodal biometric system using deep learning techniques
[J]. Scalable Computing: Practice and Experience , 2025 , 26 (5 ): 2118 - 2129
[本文引用: 1]
[6]
CHANDRABANSHI V, DOMNIC S Leveraging 3D-CNN and graph neural network with attention mechanism for visual speech recognition
[J]. Signal, Image and Video Processing , 2025 , 19 (10 ): 844
DOI:10.1007/s11760-025-04438-4
[本文引用: 1]
[7]
NAGEL M, FOURNARAKIS M, AMJAD R, et al. A white paper on neural network quantization [EB/OL]. (2021–06–15) [2025–11–10]. https://arxiv.org/pdf/2106.08295.
[本文引用: 1]
[8]
HAN S, MAO H, DALLY W J. Deep compression: compressing deep neural networks with pruning, trained quantization and Huffman coding [EB/OL]. (2016–02–15) [2025–11–10]. https://arxiv.org/pdf/1510.00149.
[本文引用: 1]
[9]
SAHA R, SAGAN N, SRIVASTAVA V, et al. Compressing large language models using low rank and low precision decomposition [C]// Proceedings of the 38th International Conference on Neural Information Processing Systems . [S.l.]: Curran Associates Inc. , 2024: 88981–89018.
[本文引用: 1]
[10]
WANG S, KANG Y Gradient distribution-aware INT8 training for neural networks
[J]. Neurocomputing , 2023 , 541 : 126269
[本文引用: 1]
[11]
DONG Z, YAO Z, GHOLAMI A, et al. HAWQ: Hessian aware quantization of neural networks with mixed-precision [C]// Proceedings of the IEEE/CVF International Conference on Computer Vision . Seoul: IEEE, 2020: 293–302.
[本文引用: 1]
[12]
DONG Z, YAO Z, CAI Y, et al. HAWQ-V2: Hessian aware trace-weighted quantization of neural networks [C]// 34th Conference on Neural Information Processing Systems . Vancouver: [s.n.], 2020: 1–12.
[本文引用: 1]
[13]
KLOBERDANZ E, LE W. MixQuant: mixed precision quantization with a bit-width optimization search [EB/OL]. (2023–09–29)[2025–11–10]. https://arxiv.org/pdf/2309.17341.
[本文引用: 1]
[14]
TANG C, OUYANG K, WANG Z, et al. Mixed-precision neural network quantization via learned layer-wise importance [C]// Computer Vision – ECCV 2022 . Cham: Springer, 2022: 259–275.
[本文引用: 1]
[15]
MA Y, JIN T, ZHENG X, et al OMPQ: orthogonal mixed precision quantization
[J]. Proceedings of the AAAI Conference on Artificial Intelligence , 2023 , 37 (7 ): 9029 - 9037
[本文引用: 1]
[16]
SHANNON C E A mathematical theory of communication
[J]. The Bell System Technical Journal , 1948 , 27 (3 ): 379 - 423
[本文引用: 1]
[17]
BOUDJADAR J, ISLAM S U, BUYYA R Dynamic FPGA reconfiguration for scalable embedded artificial intelligence (AI): a co-design methodology for convolutional neural networks (CNN) acceleration
[J]. Future Generation Computer Systems , 2025 , 169 : 107777
[本文引用: 1]
[18]
ZHANG C, PRASANNA V. Frequency domain acceleration of convolutional neural networks on CPU-FPGA shared memory system [C]// Proceedings of the 2017 ACM/SIGDA International Symposium on Field-Programmable Gate Arrays . Monterey: ACM, 2017: 35–44.
[本文引用: 1]
[19]
ZENG H, CHEN R, ZHANG C, et al. A framework for generating high throughput CNN implementations on FPGAs [C]// Proceedings of the 2018 ACM/SIGDA International Symposium on Field-Programmable Gate Arrays . Monterey: ACM, 2018: 117–126.
[本文引用: 1]
[20]
WINOGRAD S. Arithmetic complexity of computations [M]. Philadelphia: Society for Industrial and Applied Mathematics, 1980.
[本文引用: 1]
[21]
PODILI A, ZHANG C, PRASANNA V. Fast and efficient implementation of convolutional neural networks on FPGA [C]// Proceedings of the IEEE 28th International Conference on Application-specific Systems, Architectures and Processors . Seattle: IEEE, 2017: 11–18.
[本文引用: 1]
[22]
LU L, LIANG Y, XIAO Q, et al. Evaluating fast algorithms for convolutional neural networks on FPGAs [C]// Proceedings of the IEEE 25th Annual International Symposium on Field-Programmable Custom Computing Machines . [S.l.]: IEEE, 2017: 101–108.
[本文引用: 1]
[23]
ZHANG X, SONG X, LIU S, et al MRSA: a multi-mode reconfigurable systolic array architecture based on channel-wise stationary dataflow for CNNs
[J]. Microelectronics Journal , 2026 , 168 : 106983
[本文引用: 1]
[24]
JOSE A, JACOB J. Novel FPGA based systolic array design for dynamic workflows [C]// Proceedings of the 2nd International Conference on Trends in Engineering Systems and Technologies . Ernakulam: IEEE, 2025: 1–5.
[25]
YE H, ZHENG X, HUA S, et al. Systolic array-based CNN accelerator for gesture recognition [EB/OL]. [2025–11–10]. https://www.cs.columbia.edu/~sedwards/classes/2025/4840-spring/proposals/Systolic.pdf.
[本文引用: 1]
[26]
XU H, LI Z, JIN Z, et al. Effective and efficient mixed precision quantization of speech foundation models [C]// Proceedings of the ICASSP 2025 - 2025 IEEE International Conference on Acoustics, Speech and Signal Processing . Hyderabad: IEEE, 2025: 1–5.
[本文引用: 1]
[27]
KUMAR N, NARANG A, LALL B Kullback–Leibler divergence-based regularized normalization for low-resource tasks
[J]. IEEE Transactions on Artificial Intelligence , 2024 , 5 (6 ): 2638 - 2650
[本文引用: 1]
[28]
CHOI J, WANG Z, VENKATARAMANI S, et al. PACT: parameterized clipping activation for quantized neural networks [EB/OL]. (2018–07–17) [2025–11–10]. https://arxiv.org/pdf/1805.06085.
[本文引用: 1]
[29]
ESSER S K, MCKINSTRY J L, BABLANI D, et al. Learned step size quantization: US11423054 [P]. 2023–11–21.
[本文引用: 1]
[30]
ISIK M, INADAGBO K, AKTAS H. Design optimization for high-performance computing using FPGA [C]// Information Management and Big Data . Cham: Springer, 2024: 142–156.
[本文引用: 2]
[31]
HE Y, LIU W, TAHIR M, et al Research on efficient CNN acceleration through mixed precision quantization: a comprehensive methodology
[J]. International Journal of Advanced Computer Science and Applications , 2023 , 14 (12 ): 806 - 817
[本文引用: 2]
[32]
ABTAHI T, SHEA C, KULKARNI A, et al Accelerating convolutional neural network with FFT on embedded hardware
[J]. IEEE Transactions on Very Large Scale Integration (VLSI) Systems , 2018 , 26 (9 ): 1737 - 1749
[本文引用: 2]
[33]
画芊昊, 李博, 杜宸罡 基于FPGA的深度可分离卷积加速器研究
[J]. 计算机测量与控制 , 2024 , 32 (5 ): 267 - 273
[本文引用: 2]
HUA Qianhao, LI Bo, DU Chengang Research on deep separable convolution accelerator based on FPGA
[J]. Computer Measurement and Control , 2024 , 32 (5 ): 267 - 273
[本文引用: 2]
[34]
李珍琪, 王强, 齐星云, 等 轻量化卷积神经网络硬件加速设计及FPGA实现
[J]. 计算机工程与科学 , 2025 , 47 (4 ): 582 - 591
[本文引用: 2]
LI Zhenqi, WANG Qiang, QI Xingyun, et al Design and FPGA implementation of lightweight convolutional neural network hardware acceleration
[J]. Computer Engineering and Science , 2025 , 47 (4 ): 582 - 591
[本文引用: 2]
结合深度可分离卷积的多源遥感融合影像目标检测
1
2025
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
Evaluating the method reproducibility of deep learning models in biodiversity research
1
2025
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
An optimized deep learning method for automatic translator for ancient hieroglyphic language from scanned images to English text
1
2025
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
1
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
A challenge-response based authentication approach for multimodal biometric system using deep learning techniques
1
2025
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
Leveraging 3D-CNN and graph neural network with attention mechanism for visual speech recognition
1
2025
... 卷积神经网络(CNN)在目标检测[1 -2 ] 、自然语言处理[3 -4 ] 和语音识别[5 -6 ] 等领域的应用取得显著进展,但模型深度与复杂度持续提升,使推理阶段的算力、功耗与存储需求快速增长,CPU平台已难以满足要求. GPU与专用集成电路(application-specific integrated circuit, ASIC)平台受到关注. GPU并行能力强、训练效率高,但高功耗与体积限制了其在边缘端部署. ASIC能效突出,却因成本高、周期长且灵活性不足,难以适应算法快速迭代. 相比之下,现场可编程门阵列(field-programmable gate array, FPGA)具备可编程、低功耗与数据流并行优势,逐渐成为CNN加速的重要选择. ...
1
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
Gradient distribution-aware INT8 training for neural networks
1
2023
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
1
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
OMPQ: orthogonal mixed precision quantization
1
2023
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
A mathematical theory of communication
1
1948
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
Dynamic FPGA reconfiguration for scalable embedded artificial intelligence (AI): a co-design methodology for convolutional neural networks (CNN) acceleration
1
2025
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
1
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
MRSA: a multi-mode reconfigurable systolic array architecture based on channel-wise stationary dataflow for CNNs
1
2026
... 面向资源受限环境下的CNN模型部署,通常进行软件与硬件的协同优化. 在软件端,常用量化[7 ] 、剪枝[8 ] 与低秩分解[9 ] 降低复杂度,其中量化通过缩减权重与激活位宽显著减少存储与计算开销. 统一精度量化[10 ] 对网络各层使用相同位宽,忽视层间对量化噪声敏感性差异,容易导致关键层精度不足或非关键层资源浪费. 为了实现混合精度位宽分配,有研究者提出多种敏感度度量. HAWQ[11 ] 与HAWQ-V2[12 ] 基于平均Hessian轨迹评估层重要性并自动分配位宽,但主要反映损失函数的局部二阶性质;基于舍入误差的方法可与多种量化策略结合,未充分考虑激活的分层量化影响[13 ] ;比例因子学习方法能够区分层间敏感性,但对训练过程与数据依赖较强,泛化能力受限[14 ] ;基于网络正交性的度量[15 ] 对特定结构依赖较大,难以普适迁移. 本研究从信息表达角度出发,引入信息熵[16 ] 作为位宽分配准则. 通过度量各层输出特征分布的不确定性,从全局刻画信息表达与传递能力,协同衡量权重与激活的重要性,以更直接的方式完成位宽决策,减少复杂迭代搜索. 在硬件端,卷积算法优化是提升吞吐的关键[17 ] . 快速傅里叶变换(fast Fourier transform, FFT)结合重叠相加法(overlap-and-add)可降低计算复杂度[18 ] ,但分块重叠易带来冗余计算与边界误差;拼接填充法(concatenate-and-pad)通过消除重叠并改进频域处理提升效率[19 ] ,但FFT转换开销较大且更适合大卷积核. Winograd[20 ] 通过减少乘法次数实现加速,有数据重排[21 ] 与性能建模研究,但参数增大时转换代价上升. Lu等[22 ] 提出Winograd卷积的性能模型,用于预测硬件设计的资源利用率. 脉动阵列凭借局部互连与深流水复用成为主流架构[23 -25 ] ,但多数采用固定精度,难以按层动态匹配. ...
1
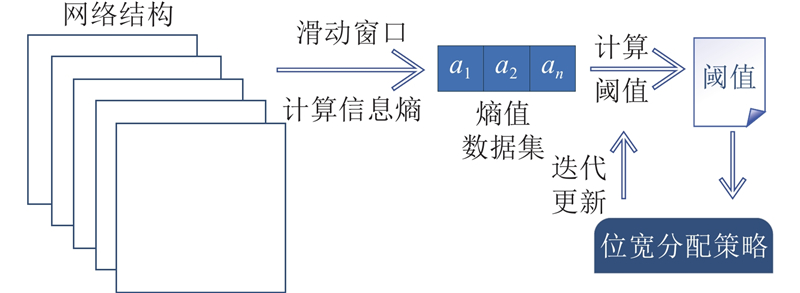
... 混合精度量化旨在通过降低模型中参数的位宽来显著减少系统的计算和内存需求[26 ] . 相较于固定精度量化,混合精度量化允许在单一模型中采用不同的精度级别,在实现计算和存储资源优化利用的同时保持模型精度. 在实际应用中,不当的位宽分配策略不但无法充分利用量化的优势,还会导致计算资源的浪费和模型性能下降. 本研究采用信息熵作为位宽分配的标准. 信息熵能够衡量每个层输出的整体不确定性和信息含量,反映该层在整个网络中传输和表示信息的能力. 与仅依赖局部参数的方法不同,信息熵捕获每个层的全局敏感度特性. 通过分析信息熵,可以同时考虑权重和激活的量化需求,实现更平衡的位宽分配. 基于熵的位宽分配无需复杂的探索策略就能有效反应神经网络各层输出的复杂性,不仅能够量化每层输出的分布复杂性,捕捉局部特征,还能通过整合所有层的熵值来评估每层在整个网络中的全局重要性. 信息熵的计算公式为 ...
Kullback–Leibler divergence-based regularized normalization for low-resource tasks
1
2024
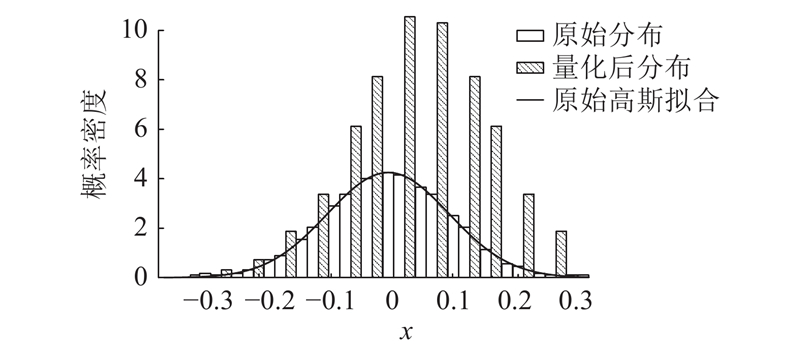
... 为了进一步优化量化误差,减少有量化导致的精度损失,KL散度被引入损失函数. KL散度能够衡量量化后信号分布与原始信号分布之间的差异[27 ] ,通过最小化KL散度,可以有效减少量化引入的误差. KL散度的表达式为 ...
1
... 如表3 所示,PACT[28 ] 和LSQ[29 ] 均采用固定4-bit量化,这2种方法在2个模型上的准确率均低于本研究所提方法,其中PACT的准确率下降幅度更大,下降了约2个百分点. 该结果反映出固定位宽策略未区分不同层的量化敏感度差异,在部分层(尤其是对精度更敏感的层)可能引入更大的量化误差,进而影响整体性能. 相比之下,所提方法依据层敏感度进行位宽分配,对敏感层采用较高位宽,对相对不敏感层采用较低位宽,在精度与压缩之间形成差异化配置. 与同样采用可变位宽策略的LIMPQ相比,所提方法的位宽配置更低,在实验中准确率更高. LIMPQ通过学习缩放因子估计层敏感度并将位宽量化至4位混合精度量化,在ResNet20上准确率下降较为明显,且在所测试模型上的准确率均低于所提方法. 上述结果表明,采用信息熵对层敏感度进行度量可以得到不同的位宽分配方案,并在本实验设置下对应更高的准确率表现. ...
2
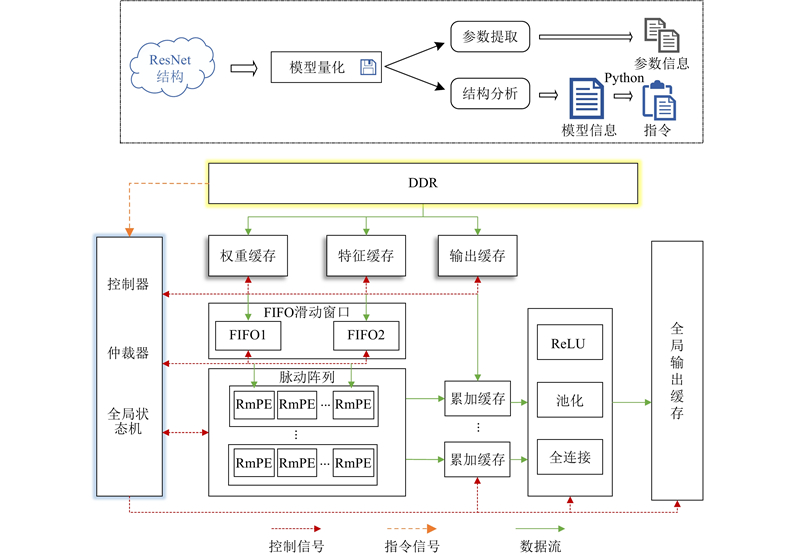
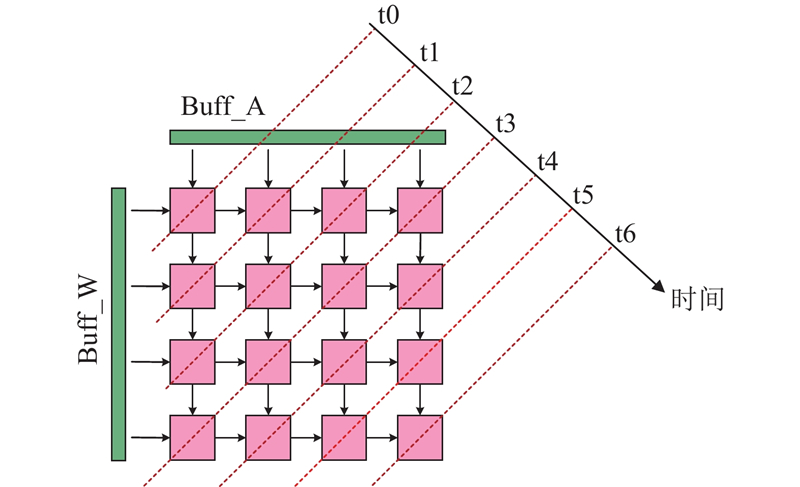
... 式中:$ T $ $ P $ $ P $ 表8 所示. 在计算精度与复杂度权衡方面,文献[30 ]采用32位浮点数进行计算,虽然维持了原始模型精度,但是硬件资源需求与计算开销相对较高. 本研究通过基于信息熵的混合精度量化策略将位宽压缩至INT4/8,在ResNet20准确率仅损失0.72%的前提下,显著降低了模型的存储空间与计算复杂度. 在算力产出层面,虽然文献[31 ]与本研究均基于Kintex-7平台实现,但其采用的INT6-8量化位宽分配策略未充分挖掘底层硬件在低比特下的计算潜力. 本研究通过RmPE处理单元的双乘法架构创新,利用单个DSP实现两路并行乘加运算,在相同资源规模下提升了算力密度. 与采用FFT算法的文献[32 ]相比,本研究所提架构减少了频域转换带来的额外计算代价与转换开销,利用参数化FIFO缓存机制配合输出固定式脉动阵列,提升了单次访存的数据重用率,缓解了片外访存压力. 尽管文献[33 ]受益于16 nm先进工艺及更高工作频率在绝对吞吐量上表现占优,但本研究在28 nm成熟工艺下实现的7.09 GOP/W能效水平,验证了指令驱动架构在资源利用与能效优化方面的可行性. 此外,文献[34 ]主要针对轻量化网络设计,在处理具有残差结构的深层ResNet网络时,单位能效表现低于本研究所提方案. 本研究所提加速器在实现0.56 ms推理延时的同时,针对ResNet56复杂的计算任务仍能保持7.10 GOPs/W的稳定能效产出,证明了该架构在应对不同深度网络任务时的通用适配性与硬件一致性. ...
... Experimental results on accelerator performance comparison
Tab.8 方案 实验平台 量化精度 f /MHzt /msT /(GOP·s−1 )EER/(GOP·W−1 ) 文献[30 ] Zynq ZU7EV FP32 100 2.91 61.46 11.80 文献[31 ] Kintex 7 INT6-8 100 0.47 179.00 13.44 文献[32 ] Zynq 7020 FP16 154 42.00 — — 文献[33 ] Zynq MpSoC INT8 300 1.53 130.00 31.71 文献[34 ] ZYNQ-7020 FP16 100 — — 7.39 本研究 Kintex-7(ResNet20) INT4/8 100 0.56 96.00 7.09 本研究 Kintex-7(ResNet56) INT4/8 100 1.23 96.00 7.10
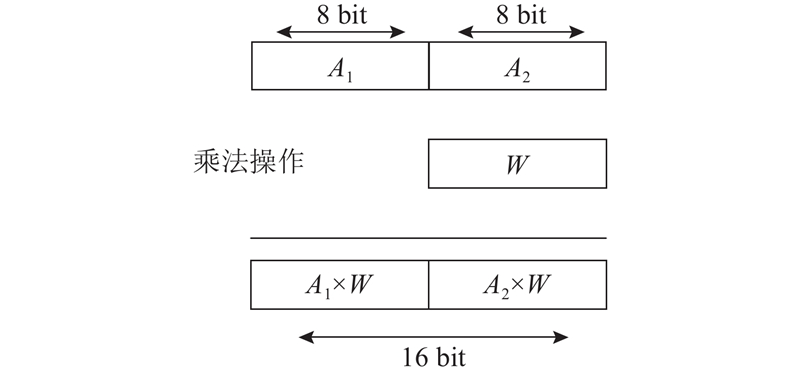
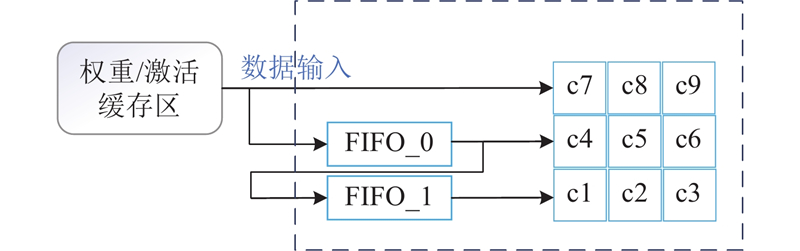
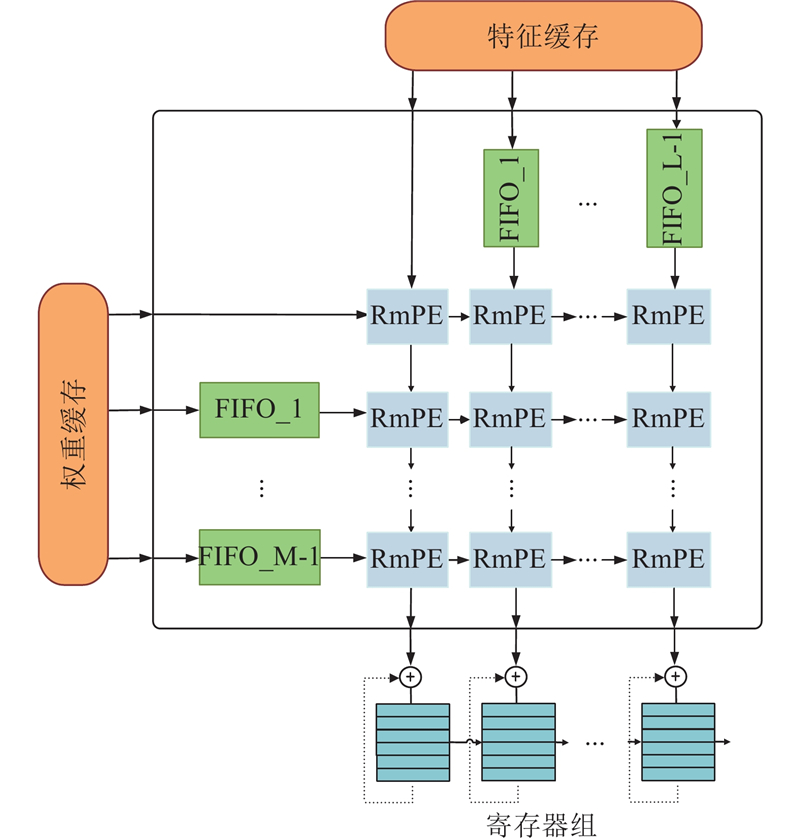
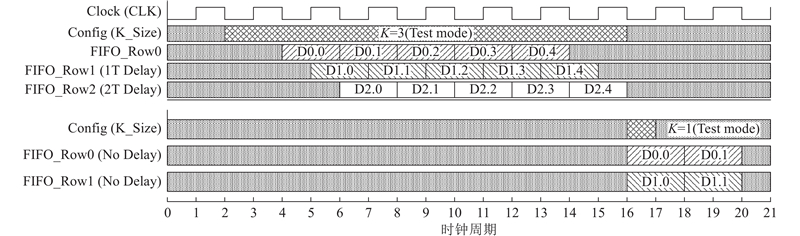
4. 结 语 本研究1)设计并实现了面向边缘计算应用的CNN硬件加速器,通过软硬件协同设计,该加速器在计算性能、功耗与资源利用之间取得了良好的平衡. 2)以输出固定式脉动阵列为核心,设计支持INT4/INT8的可变精度处理单元,该单元利用单个DSP硬核实现了高效的双乘法并行计算. 3)结合FIFO滑动窗口缓存机制,优化片上数据流转与复用,显著降低了对外部存储的依赖. 基于可变精度脉动阵列结构的卷积神经网络加速器共同确保了硬件资源的高效利用. 实验结果表明,所设计加速器在Xilinx Kintex-7平台上表现出色,单张图片的推理延时低至0.56 ms,满足边缘端的实时性需求;整体功耗控制在13.54 W,展现了低功耗优势,适配资源受限的边缘设备部署场景. 本研究采用的混合精度量化策略使ResNet20模型的压缩倍率相较于原始FP32模型得到提升,降低了存储空间. 本研究主要针对CNN推理场景开展优化,当前设计仍依赖离线确定的量化配置,对于不同网络结构和任务场景下的动态适配能力仍有提升空间. 未来将进一步研究面向多类型神经网络的自适应混合精度配置方法,结合可重构硬件架构实现算法参数与计算资源的动态协同优化. ...
Research on efficient CNN acceleration through mixed precision quantization: a comprehensive methodology
2
2023
... 式中:$ T $ $ P $ $ P $ 表8 所示. 在计算精度与复杂度权衡方面,文献[30 ]采用32位浮点数进行计算,虽然维持了原始模型精度,但是硬件资源需求与计算开销相对较高. 本研究通过基于信息熵的混合精度量化策略将位宽压缩至INT4/8,在ResNet20准确率仅损失0.72%的前提下,显著降低了模型的存储空间与计算复杂度. 在算力产出层面,虽然文献[31 ]与本研究均基于Kintex-7平台实现,但其采用的INT6-8量化位宽分配策略未充分挖掘底层硬件在低比特下的计算潜力. 本研究通过RmPE处理单元的双乘法架构创新,利用单个DSP实现两路并行乘加运算,在相同资源规模下提升了算力密度. 与采用FFT算法的文献[32 ]相比,本研究所提架构减少了频域转换带来的额外计算代价与转换开销,利用参数化FIFO缓存机制配合输出固定式脉动阵列,提升了单次访存的数据重用率,缓解了片外访存压力. 尽管文献[33 ]受益于16 nm先进工艺及更高工作频率在绝对吞吐量上表现占优,但本研究在28 nm成熟工艺下实现的7.09 GOP/W能效水平,验证了指令驱动架构在资源利用与能效优化方面的可行性. 此外,文献[34 ]主要针对轻量化网络设计,在处理具有残差结构的深层ResNet网络时,单位能效表现低于本研究所提方案. 本研究所提加速器在实现0.56 ms推理延时的同时,针对ResNet56复杂的计算任务仍能保持7.10 GOPs/W的稳定能效产出,证明了该架构在应对不同深度网络任务时的通用适配性与硬件一致性. ...
... Experimental results on accelerator performance comparison
Tab.8 方案 实验平台 量化精度 f /MHzt /msT /(GOP·s−1 )EER/(GOP·W−1 ) 文献[30 ] Zynq ZU7EV FP32 100 2.91 61.46 11.80 文献[31 ] Kintex 7 INT6-8 100 0.47 179.00 13.44 文献[32 ] Zynq 7020 FP16 154 42.00 — — 文献[33 ] Zynq MpSoC INT8 300 1.53 130.00 31.71 文献[34 ] ZYNQ-7020 FP16 100 — — 7.39 本研究 Kintex-7(ResNet20) INT4/8 100 0.56 96.00 7.09 本研究 Kintex-7(ResNet56) INT4/8 100 1.23 96.00 7.10
4. 结 语 本研究1)设计并实现了面向边缘计算应用的CNN硬件加速器,通过软硬件协同设计,该加速器在计算性能、功耗与资源利用之间取得了良好的平衡. 2)以输出固定式脉动阵列为核心,设计支持INT4/INT8的可变精度处理单元,该单元利用单个DSP硬核实现了高效的双乘法并行计算. 3)结合FIFO滑动窗口缓存机制,优化片上数据流转与复用,显著降低了对外部存储的依赖. 基于可变精度脉动阵列结构的卷积神经网络加速器共同确保了硬件资源的高效利用. 实验结果表明,所设计加速器在Xilinx Kintex-7平台上表现出色,单张图片的推理延时低至0.56 ms,满足边缘端的实时性需求;整体功耗控制在13.54 W,展现了低功耗优势,适配资源受限的边缘设备部署场景. 本研究采用的混合精度量化策略使ResNet20模型的压缩倍率相较于原始FP32模型得到提升,降低了存储空间. 本研究主要针对CNN推理场景开展优化,当前设计仍依赖离线确定的量化配置,对于不同网络结构和任务场景下的动态适配能力仍有提升空间. 未来将进一步研究面向多类型神经网络的自适应混合精度配置方法,结合可重构硬件架构实现算法参数与计算资源的动态协同优化. ...
Accelerating convolutional neural network with FFT on embedded hardware
2
2018
... 式中:$ T $ $ P $ $ P $ 表8 所示. 在计算精度与复杂度权衡方面,文献[30 ]采用32位浮点数进行计算,虽然维持了原始模型精度,但是硬件资源需求与计算开销相对较高. 本研究通过基于信息熵的混合精度量化策略将位宽压缩至INT4/8,在ResNet20准确率仅损失0.72%的前提下,显著降低了模型的存储空间与计算复杂度. 在算力产出层面,虽然文献[31 ]与本研究均基于Kintex-7平台实现,但其采用的INT6-8量化位宽分配策略未充分挖掘底层硬件在低比特下的计算潜力. 本研究通过RmPE处理单元的双乘法架构创新,利用单个DSP实现两路并行乘加运算,在相同资源规模下提升了算力密度. 与采用FFT算法的文献[32 ]相比,本研究所提架构减少了频域转换带来的额外计算代价与转换开销,利用参数化FIFO缓存机制配合输出固定式脉动阵列,提升了单次访存的数据重用率,缓解了片外访存压力. 尽管文献[33 ]受益于16 nm先进工艺及更高工作频率在绝对吞吐量上表现占优,但本研究在28 nm成熟工艺下实现的7.09 GOP/W能效水平,验证了指令驱动架构在资源利用与能效优化方面的可行性. 此外,文献[34 ]主要针对轻量化网络设计,在处理具有残差结构的深层ResNet网络时,单位能效表现低于本研究所提方案. 本研究所提加速器在实现0.56 ms推理延时的同时,针对ResNet56复杂的计算任务仍能保持7.10 GOPs/W的稳定能效产出,证明了该架构在应对不同深度网络任务时的通用适配性与硬件一致性. ...
... Experimental results on accelerator performance comparison
Tab.8 方案 实验平台 量化精度 f /MHzt /msT /(GOP·s−1 )EER/(GOP·W−1 ) 文献[30 ] Zynq ZU7EV FP32 100 2.91 61.46 11.80 文献[31 ] Kintex 7 INT6-8 100 0.47 179.00 13.44 文献[32 ] Zynq 7020 FP16 154 42.00 — — 文献[33 ] Zynq MpSoC INT8 300 1.53 130.00 31.71 文献[34 ] ZYNQ-7020 FP16 100 — — 7.39 本研究 Kintex-7(ResNet20) INT4/8 100 0.56 96.00 7.09 本研究 Kintex-7(ResNet56) INT4/8 100 1.23 96.00 7.10
4. 结 语 本研究1)设计并实现了面向边缘计算应用的CNN硬件加速器,通过软硬件协同设计,该加速器在计算性能、功耗与资源利用之间取得了良好的平衡. 2)以输出固定式脉动阵列为核心,设计支持INT4/INT8的可变精度处理单元,该单元利用单个DSP硬核实现了高效的双乘法并行计算. 3)结合FIFO滑动窗口缓存机制,优化片上数据流转与复用,显著降低了对外部存储的依赖. 基于可变精度脉动阵列结构的卷积神经网络加速器共同确保了硬件资源的高效利用. 实验结果表明,所设计加速器在Xilinx Kintex-7平台上表现出色,单张图片的推理延时低至0.56 ms,满足边缘端的实时性需求;整体功耗控制在13.54 W,展现了低功耗优势,适配资源受限的边缘设备部署场景. 本研究采用的混合精度量化策略使ResNet20模型的压缩倍率相较于原始FP32模型得到提升,降低了存储空间. 本研究主要针对CNN推理场景开展优化,当前设计仍依赖离线确定的量化配置,对于不同网络结构和任务场景下的动态适配能力仍有提升空间. 未来将进一步研究面向多类型神经网络的自适应混合精度配置方法,结合可重构硬件架构实现算法参数与计算资源的动态协同优化. ...
基于FPGA的深度可分离卷积加速器研究
2
2024
... 式中:$ T $ $ P $ $ P $ 表8 所示. 在计算精度与复杂度权衡方面,文献[30 ]采用32位浮点数进行计算,虽然维持了原始模型精度,但是硬件资源需求与计算开销相对较高. 本研究通过基于信息熵的混合精度量化策略将位宽压缩至INT4/8,在ResNet20准确率仅损失0.72%的前提下,显著降低了模型的存储空间与计算复杂度. 在算力产出层面,虽然文献[31 ]与本研究均基于Kintex-7平台实现,但其采用的INT6-8量化位宽分配策略未充分挖掘底层硬件在低比特下的计算潜力. 本研究通过RmPE处理单元的双乘法架构创新,利用单个DSP实现两路并行乘加运算,在相同资源规模下提升了算力密度. 与采用FFT算法的文献[32 ]相比,本研究所提架构减少了频域转换带来的额外计算代价与转换开销,利用参数化FIFO缓存机制配合输出固定式脉动阵列,提升了单次访存的数据重用率,缓解了片外访存压力. 尽管文献[33 ]受益于16 nm先进工艺及更高工作频率在绝对吞吐量上表现占优,但本研究在28 nm成熟工艺下实现的7.09 GOP/W能效水平,验证了指令驱动架构在资源利用与能效优化方面的可行性. 此外,文献[34 ]主要针对轻量化网络设计,在处理具有残差结构的深层ResNet网络时,单位能效表现低于本研究所提方案. 本研究所提加速器在实现0.56 ms推理延时的同时,针对ResNet56复杂的计算任务仍能保持7.10 GOPs/W的稳定能效产出,证明了该架构在应对不同深度网络任务时的通用适配性与硬件一致性. ...
... Experimental results on accelerator performance comparison
Tab.8 方案 实验平台 量化精度 f /MHzt /msT /(GOP·s−1 )EER/(GOP·W−1 ) 文献[30 ] Zynq ZU7EV FP32 100 2.91 61.46 11.80 文献[31 ] Kintex 7 INT6-8 100 0.47 179.00 13.44 文献[32 ] Zynq 7020 FP16 154 42.00 — — 文献[33 ] Zynq MpSoC INT8 300 1.53 130.00 31.71 文献[34 ] ZYNQ-7020 FP16 100 — — 7.39 本研究 Kintex-7(ResNet20) INT4/8 100 0.56 96.00 7.09 本研究 Kintex-7(ResNet56) INT4/8 100 1.23 96.00 7.10
4. 结 语 本研究1)设计并实现了面向边缘计算应用的CNN硬件加速器,通过软硬件协同设计,该加速器在计算性能、功耗与资源利用之间取得了良好的平衡. 2)以输出固定式脉动阵列为核心,设计支持INT4/INT8的可变精度处理单元,该单元利用单个DSP硬核实现了高效的双乘法并行计算. 3)结合FIFO滑动窗口缓存机制,优化片上数据流转与复用,显著降低了对外部存储的依赖. 基于可变精度脉动阵列结构的卷积神经网络加速器共同确保了硬件资源的高效利用. 实验结果表明,所设计加速器在Xilinx Kintex-7平台上表现出色,单张图片的推理延时低至0.56 ms,满足边缘端的实时性需求;整体功耗控制在13.54 W,展现了低功耗优势,适配资源受限的边缘设备部署场景. 本研究采用的混合精度量化策略使ResNet20模型的压缩倍率相较于原始FP32模型得到提升,降低了存储空间. 本研究主要针对CNN推理场景开展优化,当前设计仍依赖离线确定的量化配置,对于不同网络结构和任务场景下的动态适配能力仍有提升空间. 未来将进一步研究面向多类型神经网络的自适应混合精度配置方法,结合可重构硬件架构实现算法参数与计算资源的动态协同优化. ...
轻量化卷积神经网络硬件加速设计及FPGA实现
2
2025
... 式中:$ T $ $ P $ $ P $ 表8 所示. 在计算精度与复杂度权衡方面,文献[30 ]采用32位浮点数进行计算,虽然维持了原始模型精度,但是硬件资源需求与计算开销相对较高. 本研究通过基于信息熵的混合精度量化策略将位宽压缩至INT4/8,在ResNet20准确率仅损失0.72%的前提下,显著降低了模型的存储空间与计算复杂度. 在算力产出层面,虽然文献[31 ]与本研究均基于Kintex-7平台实现,但其采用的INT6-8量化位宽分配策略未充分挖掘底层硬件在低比特下的计算潜力. 本研究通过RmPE处理单元的双乘法架构创新,利用单个DSP实现两路并行乘加运算,在相同资源规模下提升了算力密度. 与采用FFT算法的文献[32 ]相比,本研究所提架构减少了频域转换带来的额外计算代价与转换开销,利用参数化FIFO缓存机制配合输出固定式脉动阵列,提升了单次访存的数据重用率,缓解了片外访存压力. 尽管文献[33 ]受益于16 nm先进工艺及更高工作频率在绝对吞吐量上表现占优,但本研究在28 nm成熟工艺下实现的7.09 GOP/W能效水平,验证了指令驱动架构在资源利用与能效优化方面的可行性. 此外,文献[34 ]主要针对轻量化网络设计,在处理具有残差结构的深层ResNet网络时,单位能效表现低于本研究所提方案. 本研究所提加速器在实现0.56 ms推理延时的同时,针对ResNet56复杂的计算任务仍能保持7.10 GOPs/W的稳定能效产出,证明了该架构在应对不同深度网络任务时的通用适配性与硬件一致性. ...
... Experimental results on accelerator performance comparison
Tab.8 方案 实验平台 量化精度 f /MHzt /msT /(GOP·s−1 )EER/(GOP·W−1 ) 文献[30 ] Zynq ZU7EV FP32 100 2.91 61.46 11.80 文献[31 ] Kintex 7 INT6-8 100 0.47 179.00 13.44 文献[32 ] Zynq 7020 FP16 154 42.00 — — 文献[33 ] Zynq MpSoC INT8 300 1.53 130.00 31.71 文献[34 ] ZYNQ-7020 FP16 100 — — 7.39 本研究 Kintex-7(ResNet20) INT4/8 100 0.56 96.00 7.09 本研究 Kintex-7(ResNet56) INT4/8 100 1.23 96.00 7.10
4. 结 语 本研究1)设计并实现了面向边缘计算应用的CNN硬件加速器,通过软硬件协同设计,该加速器在计算性能、功耗与资源利用之间取得了良好的平衡. 2)以输出固定式脉动阵列为核心,设计支持INT4/INT8的可变精度处理单元,该单元利用单个DSP硬核实现了高效的双乘法并行计算. 3)结合FIFO滑动窗口缓存机制,优化片上数据流转与复用,显著降低了对外部存储的依赖. 基于可变精度脉动阵列结构的卷积神经网络加速器共同确保了硬件资源的高效利用. 实验结果表明,所设计加速器在Xilinx Kintex-7平台上表现出色,单张图片的推理延时低至0.56 ms,满足边缘端的实时性需求;整体功耗控制在13.54 W,展现了低功耗优势,适配资源受限的边缘设备部署场景. 本研究采用的混合精度量化策略使ResNet20模型的压缩倍率相较于原始FP32模型得到提升,降低了存储空间. 本研究主要针对CNN推理场景开展优化,当前设计仍依赖离线确定的量化配置,对于不同网络结构和任务场景下的动态适配能力仍有提升空间. 未来将进一步研究面向多类型神经网络的自适应混合精度配置方法,结合可重构硬件架构实现算法参数与计算资源的动态协同优化. ...