[1]
Tong W, Zhu P. 6G: the next horizon [M]. Cambridge: Cambridge University Press, 2021.
[本文引用: 1]
[2]
Letaief K B, Chen Wei, Shi Yuanming, et al The roadmap to 6G: AI empowered wireless networks
[J]. IEEE Communications Magazine , 2019 , 57 (8 ): 84 - 90
DOI:10.1109/MCOM.2019.1900271
[本文引用: 1]
[3]
Wang Y, Han H, Feng Y, et al Semantic communication empowered 6g networks: techniques, applications, and challenges
[J]. IEEE Access , 2025 , 13 : 28293 - 28314
DOI:10.1109/ACCESS.2025.3532797
[本文引用: 1]
[4]
栾宏之, 李书才, 李屹, 等 5G-A车联网确定性网络中的语义通信系统
[J]. 浙江大学学报(工学版) , 2025 , 59 (5 ): 964 - 972
[本文引用: 1]
Luan Hongzhi, Li Shucai, Li Yi, et al Semantic communication system in deterministic networking for5G-advanced vehicular network
[J]. Journal of Zhejiang University (Engineering Science) , 2025 , 59 (5 ): 964 - 972
[本文引用: 1]
[6]
Zhang P, Xu W, Gao H, et al Toward wisdom-evolutionary and primitive-concise 6G: a new paradigm of semantic communication networks
[J]. Engineering , 2022 , 8 : 60 - 73
DOI:10.1016/j.eng.2021.11.003
[本文引用: 1]
[7]
Fang Y, He Q, Ding D, et al. Deep-learning based gaussian mixture likelihoods joint source-channel coding for image transmission [C]//2023 International Conference on Wireless Communications and Signal Processing . Hangzhou: IEEE, 2023: 19-24.
[本文引用: 1]
[8]
Gündüz D, Qin Z, Aguerri I E, et al Beyond transmitting bits: context, semantics, and task-oriented communications
[J]. IEEE Journal on Selected Areas in Communications , 2023 , 41 (1 ): 5 - 41
DOI:10.1109/JSAC.2022.3223408
[本文引用: 1]
[9]
Bourtsoulatze E, Kurka D B, Gündüz D Deep joint source-channel coding for wireless image transmission
[J]. IEEE Transactions on Cognitive Communications and Networking , 2019 , 5 (3 ): 567 - 579
DOI:10.1109/TCCN.2019.2919300
[本文引用: 3]
[10]
Dai J, Wang S, Tan K, et al Nonlinear transform source-channel coding for semantic communications
[J]. IEEE Journal on Selected Areas in Communications , 2022 , 40 (8 ): 2300 - 2316
DOI:10.1109/JSAC.2022.3180802
[本文引用: 1]
[11]
Park T, Hong E, Jeon Y, et al. Robust deep joint source channel coding for task-oriented semantic communications [PP/OL]. arXiv (2025-03-17)[2025-11-15]. https://arxiv.org/abs/2503.12907.
[本文引用: 1]
[12]
Hu Q, Zhang G, Qin Z, et al Robust semantic communications with masked VQ-VAE enabled codebook
[J]. IEEE Transactions on Communications , 2023 , 22 (12 ): 8707 - 8722
[本文引用: 1]
[13]
Kurka D B, Gündüz D DeepJSCC-f: deep joint source-channel coding of images with feedback
[J]. IEEE Journal on Selected Areas in Information Theory , 2020 , 1 (1 ): 178 - 193
DOI:10.1109/JSAIT.2020.2987203
[本文引用: 1]
[14]
Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16×16 words: Transformers for image recognition at scale [PP/OL]. arXiv (2020-10-22)[2025-11-15]. https://arxiv.org/abs/2010.11929.
[本文引用: 1]
[15]
Liu Z, Lin Y, Cao Y, et al. Swin transformer: hierarchical vision transformer using shifted windows [C]// IEEE/CVF International Conference on Computer Vision . Montreal: IEEE, 2021: 10012-10022.
[本文引用: 1]
[16]
张振利, 胡新凯, 李凡, 等 基于 CNN 和 Efficient Transformer 的多尺度遥感图像语义分割算法
[J]. 浙江大学学报(工学版) , 2025 , 59 (4 ): 778 - 786
[本文引用: 1]
Zhang Zhenli, Hu Xinkai, Li Fan, et al Semantic segmentation algorithm for multiscale remote sensing images based on CNN and Efficient Transformer
[J]. Journal of Zhejiang University (Engineering Science) , 2025 , 59 (4 ): 778 - 786
[本文引用: 1]
[17]
刘春娟, 乔泽, 闫浩文, 等 基于多尺度互注意力的遥感图像语义分割网络
[J]. 浙江大学学报(工学版) , 2023 , 57 (07 ): 1335 - 1344
Liu Chunjuan, Qiao Ze, Yan Haowen, et al Semantic segmentation network for remote sensing image based on multi-scale mutual attention
[J]. Journal of Zhejiang University (Engineering Science) , 2023 , 57 (07 ): 1335 - 1344
[18]
梁龙学, 贺成龙, 吴小所, 等 全局信息提取与重建的遥感图像语义分割网络
[J]. 浙江大学学报(工学版) , 2024 , 58 (11 ): 2270 - 2279
[本文引用: 1]
Liang Longxue, He Chenglong, Wu Xiaosuo, et al Remote sensing image semantic segmentation network based on global information extraction and reconstruction
[J]. Journal of Zhejiang University (Engineering Science) , 2024 , 58 (11 ): 2270 - 2279
[本文引用: 1]
[19]
Yang K, Wang S, Dai J, et al. WITT: a wireless image transmission transformer for semantic communications [C]// 2023 IEEE International Conference on Acoustics, Speech and Signal Processing . Rhodes: IEEE, 2023: 1-5.
[本文引用: 2]
[20]
Nguyen L X, Tun Y L, Tun Y K, et al Swin transformer-based dynamic semantic communication for multi-user with different computing capacity
[J]. IEEE Transactions on Vehicular Technology , 2024 , 73 (6 ): 8957 - 8972
DOI:10.1109/TVT.2024.3362328
[本文引用: 1]
[21]
Blau Y, Michaeli T. The perception-distortion tradeoff [C]// Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition . Salt Lake City: IEEE, 2018: 6228-6237.
[本文引用: 1]
[22]
Ledig C, Theis L, Huszár F, et al. Photo-realistic single image super-resolution using a generative adversarial network [C]// Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition . Honolulu: IEEE, 2017: 4681–4690.
[本文引用: 1]
[23]
Agustsson E, Minnen D, Toderici G, et al Generative adversarial networks for extreme learned image compression
[J]. IEEE Transactions on Image Processing , 2020 , 29 : 2752 - 2763
[本文引用: 1]
[24]
Zhang G, Hu Q, Cai Y, et al. Adaptive CSI feedback for deep learning-enabled image transmission [C]// IEEE International Conference on Communications . Rome: IEEE, 2023: 4163-4168.
[本文引用: 1]
[25]
Song M, Ma N, Dong C, et al Deep joint source-channel coding for wireless image transmission with adaptive models
[J]. Electronics , 2023 , 12 (22 ): 4637
DOI:10.3390/electronics12224637
[本文引用: 1]
[26]
Liang C, Du H, Sun Y, et al Generative AI-driven semantic communication networks: architecture, technologies and applications
[J]. IEEE Transactions on Cognitive Communications and Networking , 2024 , 11 (1 ): 27 - 47
DOI:10.1109/tccn.2024.3435524
[本文引用: 1]
[27]
Grassucci E, Barbarossa S, Comminiello D. Generative semantic communication: diffusion models beyond bit recovery [PP/OL]. arXiv (2023-06-07)[2025-11-15]. https://arxiv.org/abs/2306.04321.
[本文引用: 1]
[28]
Erdem E, Gündüz D, Dragotti P L, et al Generative joint source-channel coding for semantic image transmission
[J]. IEEE Journal on Selected Areas in Communications , 2023 , 41 (8 ): 2645 - 2657
DOI:10.1109/JSAC.2023.3288243
[本文引用: 1]
[29]
杨冰, 周家辉, 姚金良, 等 基于多模态语义信息的文本生成图像方法
[J]. 浙江大学学报(工学版) , 2026 , 60 (2 ): 1 - 10
[本文引用: 1]
Yang Bing, Zhou Jiahui, Yao Jinliang, et al Text-to-image generation method based on multimodal semantic information
[J]. Journal of Zhejiang University (Engineering Science) , 2026 , 60 (2 ): 1 - 10
[本文引用: 1]
[30]
Liang W, Ma N, Shen L, et al. An image semantic communication system based on Swin Transformer and generative adversarial networks [C]// 2024 IEEE Globecom Workshops . Cape Town: IEEE, 2024: 1-6.
[本文引用: 2]
[31]
Richardson T, Kudekar S Design of low-density parity check codes for 5G new radio
[J]. IEEE Communications Magazine , 2018 , 56 (3 ): 28 - 34
DOI:10.1109/MCOM.2018.1700839
[本文引用: 1]
[32]
Wang Z, Simoncelli E P, Bovik A C. Multiscale structural similarity for image quality assessment [C]// Conference Record of the 37th Asilomar Conference on Signals, Systems and Computers . Pacific Grove: IEEE, 2003: 1398–1402.
[本文引用: 1]
1
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
The roadmap to 6G: AI empowered wireless networks
1
2019
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
Semantic communication empowered 6g networks: techniques, applications, and challenges
1
2025
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
5G-A车联网确定性网络中的语义通信系统
1
2025
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
A mathematical theory of communication
1
1948
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
Toward wisdom-evolutionary and primitive-concise 6G: a new paradigm of semantic communication networks
1
2022
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
1
... 6G网络下的海量非结构化数据对通信系统的带宽效率、传输时延及复杂环境下的鲁棒性提出了更高的要求[1 -2 ] . Wang等[3 ] 指出,6G网络预计将实现无处不在的无线智能,须支持大规模接入设备与高流量数据. 栾宏之等[4 ] 指出,现有语义通信系统编码时间较长,无法直接应用于5G-Advanced技术框架以处理大量高实时性、低延迟数据. 传统的无线通信系统严格遵循香农分离定理[5 ] ,将信源与信道编码独立设计. 在短包传输及信道剧烈波动场景下,该架构带来显著时延,且当信道质量低于阈值时易引发“悬崖效应”,难以满足6G网络高实时、高可靠的通信需求[6 -7 ] . ...
Beyond transmitting bits: context, semantics, and task-oriented communications
1
2023
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
Deep joint source-channel coding for wireless image transmission
3
2019
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
... [9 ,13 ]. CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
... 将提出的CAG-ST与以下3种代表性方案进行对比. 第1种是“BPG+LDPC”,代表传统分离式编码方案,信源编码采用BPG(better portable graphics)格式,信道编码采用标准的低密度奇偶校验(low-density parity-check, LDPC)码[31 ] ,正交幅度调制(quadrature amplitude modulation, QAM)的块长度为6144. 第2种是经典的基于CNN的Deep JSCC方案[9 ] ,在给定CBR的条件下,信道输入符号维度由CBR控制,无须额外冗余. 第3种是基于Swin Transformer的经典图像语义通信方案WITT. 为了保证对比公平性,所有的JSCC方案采用相同的信道符号维度,传统数字方案通过调整信源压缩率与信道编码码率匹配目标CBR. ...
Nonlinear transform source-channel coding for semantic communications
1
2022
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
1
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
Robust semantic communications with masked VQ-VAE enabled codebook
1
2023
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
DeepJSCC-f: deep joint source-channel coding of images with feedback
1
2020
... 关注数据“含义”而非“比特”的语义通信为突破物理极限提供了新范式[8 ] . 在该框架下,基于深度学习的信源信道联合编码(deep joint source-channel coding, Deep JSCC)技术通过端到端的神经网络优化,将图像直接映射为模拟信道符号[9 ] . Dai等[10 ] 提出非线性变换信源信道编码,验证了该类方法在信源压缩与信道纠错深度融合方面的优势. 相较于传统数字传输,Deep JSCC在低信噪比(signal-to-noise ratio, SNR)下表现出更稳健的性能退化特性[11 ] ,且通过掩码矢量量化技术可以显著增强传输鲁棒性[12 ] . 早期的Deep JSCC研究主要基于卷积神经网络(convolutional neural networks, CNN)架构[9 ,13 ] . CNN在提取局部纹理特征方面表现较优,但受限于固定感受野,难以捕捉图像的长距离依赖关系,而全局信息对于理解图像整体语义至关重要. ...
1
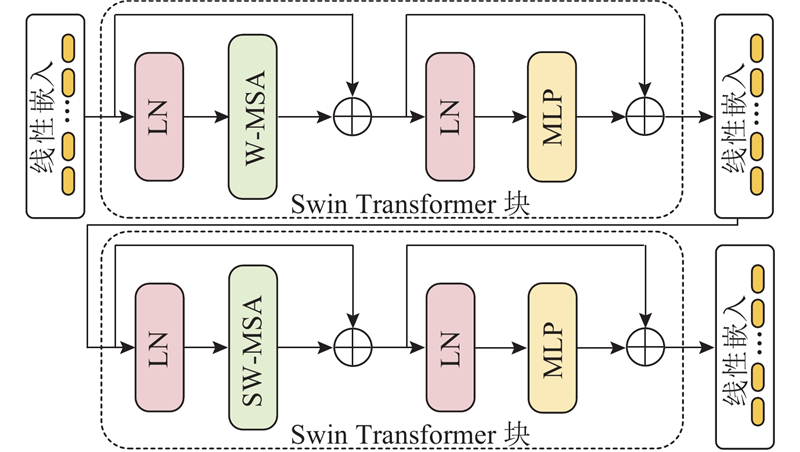
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
基于 CNN 和 Efficient Transformer 的多尺度遥感图像语义分割算法
1
2025
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
基于多尺度互注意力的遥感图像语义分割网络
0
2023
基于多尺度互注意力的遥感图像语义分割网络
0
2023
全局信息提取与重建的遥感图像语义分割网络
1
2024
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
2
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
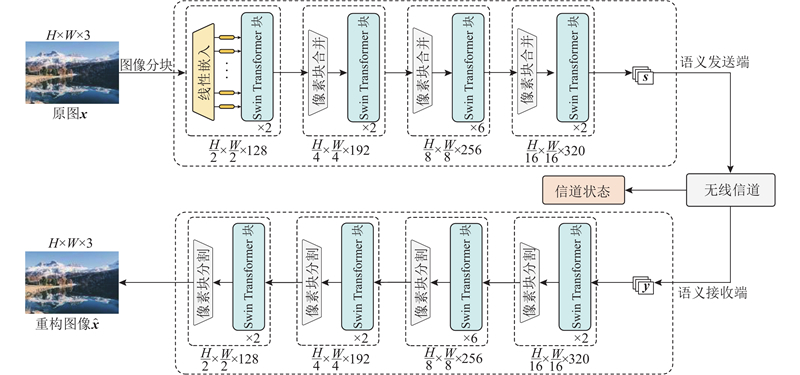
... 实验基于PyTorch框架实现,GPU为NVIDIA GeForce RTX 4090 ,使用Adam优化器,批大小设为128,训练2 000个轮次. 2个训练阶段的初始学习率均设为1.0×10⁻⁴ ,采用余弦退火策略衰减至1.0×10⁻⁵ . 将SNR设为2~12 dB作为主要评估区间,是因为该范围涵盖了图像语义通信从强干扰向高保真过渡的核心性能变化区[19 ,30 ] ,测试结果足以体现本研究方案在不同信道条件下的自适应调节能力与边界鲁棒性. 对于低分辨率图像,仅使用图1 中Swin Transformer编码器的前2个阶段,高分辨率图像使用完整的4个阶段. ...
Swin transformer-based dynamic semantic communication for multi-user with different computing capacity
1
2024
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
1
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
Generative adversarial networks for extreme learned image compression
1
2020
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
1
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
Deep joint source-channel coding for wireless image transmission with adaptive models
1
2023
... Vision Transformer(ViT)利用自注意力机制有效建模了全局语义关联[14 ] . 为了兼顾计算效率与建模能力,Liu等[15 ] 提出Swin Transformer,引入基于移动窗口的层级式注意力机制,在遥感图像语义分割任务中展现出较优性能[16 -18 ] . WITT架构[19 ] 和Nguyen等[20 ] 提出的动态语义通信方案在多项重建指标上超越基于CNN的传统方案. 现有基于Transformer的传输方案在处理低SNR场景时存在局限. 多数方案以最小化均方误差(mean squared error, MSE)为训练目标,Blau等[21 ] 在“感知-失真权衡”理论中指出,仅优化MSE易导致解码器倾向输出过度平滑、边缘模糊的图像,造成感知质量损失[22 -23 ] . 现有的信道状态信息(channel state information, CSI)反馈机制通常仅被动用于功率缩放[24 -25 ] ,缺乏根据信道状态动态调整特征提取拓扑的主动适应能力. ...
Generative AI-driven semantic communication networks: architecture, technologies and applications
1
2024
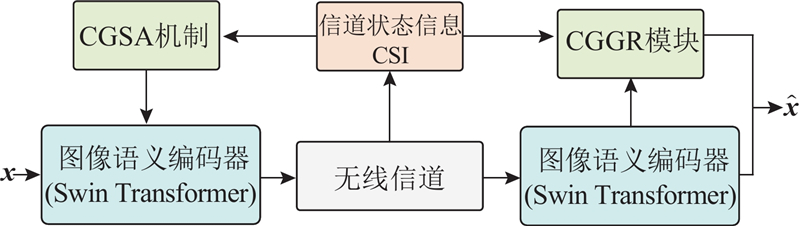
... 针对上述问题,生成式人工智能技术被引入语义通信领域[26 ] . Grassucci等[27 ] 探索基于扩散模型的超可靠图像传输,Erdem等[28 ] 研究生成式JSCC方案,杨冰等[29 ] 将多模态语义信息用于文本生成图像任务,通过增强生成器表达能力提升细节表现. Liang等[30 ] 提出基于Swin Transformer与GAN的语义通信系统,通过引入对抗损失显著提升图像的视觉质量. 该方法在推理阶段采用静态生成策略,即无论CSI如何波动,解码器均以固定强度进行生成式重建,未考虑直接引入GAN面临的感知-失真权衡问题:GAN生成的纹理在低SNR环境下可以提升图像清晰度,但在高SNR环境下易破坏原始图像的高保真度,导致客观指标下降. ...
1
... 针对上述问题,生成式人工智能技术被引入语义通信领域[26 ] . Grassucci等[27 ] 探索基于扩散模型的超可靠图像传输,Erdem等[28 ] 研究生成式JSCC方案,杨冰等[29 ] 将多模态语义信息用于文本生成图像任务,通过增强生成器表达能力提升细节表现. Liang等[30 ] 提出基于Swin Transformer与GAN的语义通信系统,通过引入对抗损失显著提升图像的视觉质量. 该方法在推理阶段采用静态生成策略,即无论CSI如何波动,解码器均以固定强度进行生成式重建,未考虑直接引入GAN面临的感知-失真权衡问题:GAN生成的纹理在低SNR环境下可以提升图像清晰度,但在高SNR环境下易破坏原始图像的高保真度,导致客观指标下降. ...
Generative joint source-channel coding for semantic image transmission
1
2023
... 针对上述问题,生成式人工智能技术被引入语义通信领域[26 ] . Grassucci等[27 ] 探索基于扩散模型的超可靠图像传输,Erdem等[28 ] 研究生成式JSCC方案,杨冰等[29 ] 将多模态语义信息用于文本生成图像任务,通过增强生成器表达能力提升细节表现. Liang等[30 ] 提出基于Swin Transformer与GAN的语义通信系统,通过引入对抗损失显著提升图像的视觉质量. 该方法在推理阶段采用静态生成策略,即无论CSI如何波动,解码器均以固定强度进行生成式重建,未考虑直接引入GAN面临的感知-失真权衡问题:GAN生成的纹理在低SNR环境下可以提升图像清晰度,但在高SNR环境下易破坏原始图像的高保真度,导致客观指标下降. ...
基于多模态语义信息的文本生成图像方法
1
2026
... 针对上述问题,生成式人工智能技术被引入语义通信领域[26 ] . Grassucci等[27 ] 探索基于扩散模型的超可靠图像传输,Erdem等[28 ] 研究生成式JSCC方案,杨冰等[29 ] 将多模态语义信息用于文本生成图像任务,通过增强生成器表达能力提升细节表现. Liang等[30 ] 提出基于Swin Transformer与GAN的语义通信系统,通过引入对抗损失显著提升图像的视觉质量. 该方法在推理阶段采用静态生成策略,即无论CSI如何波动,解码器均以固定强度进行生成式重建,未考虑直接引入GAN面临的感知-失真权衡问题:GAN生成的纹理在低SNR环境下可以提升图像清晰度,但在高SNR环境下易破坏原始图像的高保真度,导致客观指标下降. ...
2
... 针对上述问题,生成式人工智能技术被引入语义通信领域[26 ] . Grassucci等[27 ] 探索基于扩散模型的超可靠图像传输,Erdem等[28 ] 研究生成式JSCC方案,杨冰等[29 ] 将多模态语义信息用于文本生成图像任务,通过增强生成器表达能力提升细节表现. Liang等[30 ] 提出基于Swin Transformer与GAN的语义通信系统,通过引入对抗损失显著提升图像的视觉质量. 该方法在推理阶段采用静态生成策略,即无论CSI如何波动,解码器均以固定强度进行生成式重建,未考虑直接引入GAN面临的感知-失真权衡问题:GAN生成的纹理在低SNR环境下可以提升图像清晰度,但在高SNR环境下易破坏原始图像的高保真度,导致客观指标下降. ...
... 实验基于PyTorch框架实现,GPU为NVIDIA GeForce RTX 4090 ,使用Adam优化器,批大小设为128,训练2 000个轮次. 2个训练阶段的初始学习率均设为1.0×10⁻⁴ ,采用余弦退火策略衰减至1.0×10⁻⁵ . 将SNR设为2~12 dB作为主要评估区间,是因为该范围涵盖了图像语义通信从强干扰向高保真过渡的核心性能变化区[19 ,30 ] ,测试结果足以体现本研究方案在不同信道条件下的自适应调节能力与边界鲁棒性. 对于低分辨率图像,仅使用图1 中Swin Transformer编码器的前2个阶段,高分辨率图像使用完整的4个阶段. ...
Design of low-density parity check codes for 5G new radio
1
2018
... 将提出的CAG-ST与以下3种代表性方案进行对比. 第1种是“BPG+LDPC”,代表传统分离式编码方案,信源编码采用BPG(better portable graphics)格式,信道编码采用标准的低密度奇偶校验(low-density parity-check, LDPC)码[31 ] ,正交幅度调制(quadrature amplitude modulation, QAM)的块长度为6144. 第2种是经典的基于CNN的Deep JSCC方案[9 ] ,在给定CBR的条件下,信道输入符号维度由CBR控制,无须额外冗余. 第3种是基于Swin Transformer的经典图像语义通信方案WITT. 为了保证对比公平性,所有的JSCC方案采用相同的信道符号维度,传统数字方案通过调整信源压缩率与信道编码码率匹配目标CBR. ...
1
... 为了综合衡量图像重建的保真度和感知质量,采用PSNR和多尺度结构相似性[32 ] (multi scale structural similarity index measure, MS-SSIM)作为主要的客观评价指标. PSNR是衡量图像像素级保真度的标准指标,计算公式为 ...