



深度强化学习(deep reinforcement learning, DRL)因在复杂环境中具有强决策能力,成为MEC资源优化的重要手段. Yang等[9]针对多用户、多服务器MEC环境的资源与延迟约束,提出基于改进深度Q网络(deep Q-network, DQN)的联合任务卸载与资源分配方法,有效降低了完成时间与终端能耗. Li等[10]面向5G边缘计算,提出基于DRL的任务映射与图序列算法,将任务建模为马尔可夫决策过程(markov decision process, MDP)以优化综合收益. 现有DRL方案虽成效显著,但在应对车联网高动态及复杂状态空间时,决策稳定性与探索能力仍显不足,难以满足严格实时要求.
本文针对自动驾驶中任务波动大、链路不稳定及资源受限等问题,提出基于RSU主动感知的任务预测与优化方法. 构建卫星-RSU-车辆协同模型,实现卸载与资源一体化优化. 引入融合环境不确定性的增强型单变量霍克斯模型(enhanced univariate Hawkes, EU-Hawkes),以提升预测精度. 将优化问题建模为0-1规划并转化为MDP,在近端策略优化(proximal policy optimization, PPO)框架下结合不确定性感知探索、自适应裁剪与L2正则化,提出不确定性感知增强型近端策略优化算法(enhanced univariate proximal policy optimization, EUPPO),从而有效提升训练稳定性与动态适应性,降低系统延迟并提高资源利用率.
1. 系统模型
所提的模型由
图 1
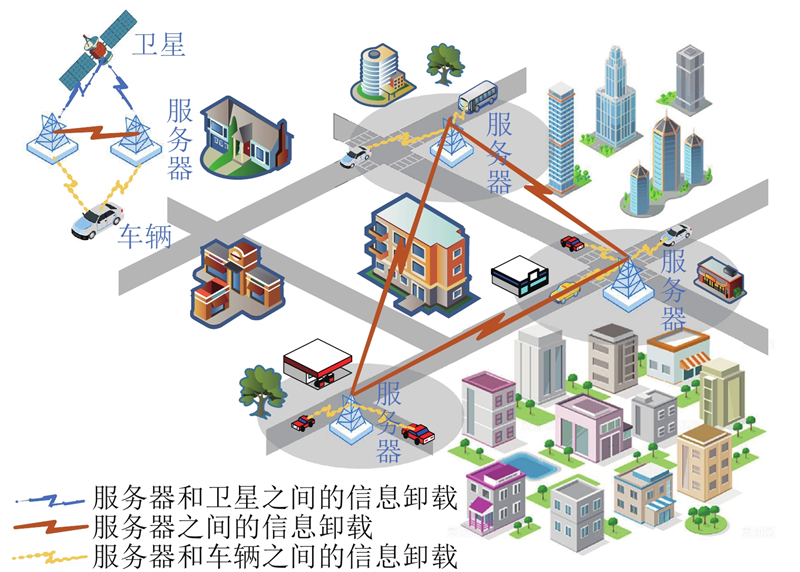
图 1 面向路侧单元辅助车载网络的移动边缘计算系统
Fig.1 Mobile edge computing system for roadside unit-assisted vehicular network
在接收到任务请求后,MEC系统综合考虑网络状态、任务复杂度及各节点资源,评估计算与传输开销并作出卸载决策:优先将任务分配至邻近RSU,若其资源不足,则转发至卫星节点执行,处理结果最终回传至车辆.
基于任务规模、类型及时延约束等信息,系统联合优化计算资源与缓存策略,并在EUPPO算法驱动下动态选择最优卸载节点. 利用EU-Hawkes模型预测缓存需求,以提升缓存命中率与响应效率. 假设采用单跳通信,不涉及车对车(vehicle to vehicle, V2V)交互.
1.1. 任务缓存模型
在RSU辅助的MEC系统中,缓存管理对提升任务处理效率至关重要. 针对车辆动态环境下任务需求难以准确预测的问题,为了有效提升缓存命中率与系统处理效率,提出基于EU-Hawkes模型的任务预测与缓存管理机制. Hawkes模型能够刻画事件的自激特性,通过建模历史任务对未来需求的影响,实现对任务流行度及时间分布的有效预测.
在建模过程中,为了反映高度动态车联网环境中任务需求的异构性,将环境划分为
式中:
传统Hawkes模型仅关注历史任务对未来事件的影响,未能充分考虑外部环境的动态变化及系统不确定性. 在RSU辅助的自动驾驶场景中,任务需求分布常受到交通流量、天气条件、突发事件等外部环境波动的影响. 在传统Hawkes模型框架的基础上,引入环境不确定性因素,提出EU-Hawkes模型,以提高任务需求预测的准确性和适应性. 该EU-Hawkes模型的预测公式如下:
式中:
其中,
在MEC系统中,假设每个RSU的缓存容量相同,记为
式中:
在设定的缓存更新机制中,当缓存占用达到容量
式中:
在每个时隙
式中:
在缓存模型中,采用缓存命中率作为衡量缓存操作效果的指标,该指标反映系统对所有车辆请求的响应能力. 任务类别
式中:
在缓存决策过程中,定义未来命中次数为
式中:
式中:
1.2. 节点计算模型
在MEC系统中,缓存感知任务的处理须经由计算节点执行. 计算节点包括卫星、RSU和AV,它们在计算能力、通信带宽及处理延迟上均有差异,任务传输至不同节点产生的延迟也不同. MEC系统在任务分配时,综合考虑任务延迟要求、数据规模、计算复杂性与各节点的实时资源负载,动态选择最佳计算节点.
1)当任务卸载到卫星时,由于算力强大,计算延迟可以忽略不计. 总延迟由初始任务数据的上传延迟
式中:
卫星的总延迟
2)当任务卸载到RSU时,总延迟由任务上传延迟、结果下载延迟、排队延迟及处理延迟构成,记为
式中:
式中:
基于以上分析,第
3)当任务卸载到AV时,总延迟记为
式中:
综上,第
基于3类计算节点的延迟,任务
式中:
1.3. 问题描述
在RSU辅助的MEC系统中,任务缓存与计算节点选择是影响系统性能的关键. 对EUPPO算法进行优化,综合任务特性、预测结果及网络状态,实现任务卸载与缓存的动态协同调度,从而降低延迟并提升缓存命中率与资源利用效率.将该问题建模为以系统整体效用最大化为目标的0-1优化模型,在资源约束下动态优化卸载决策与缓存策略,以增强系统的适应性与响应性能.
该优化模型包含1个目标函数和一系列约束条件,共同定义了系统决策的边界和优化目标.
目标函数
在定义目标函数之后,须引入一系列约束,确保任务缓存和卸载决策在实际场景中的可行性,同时考虑任务的及时性、执行效率及系统资源的最佳利用. 具体约束定义如下.
C1(延迟约束):系统总延迟
C2(缓存状态约束):缓存状态
C3(卸载决策约束):
C4(缓存策略唯一性约束):在每个时隙
2. 基于EUPPO算法的边缘计算与缓存卸载
2.1. MDP问题
基于MDP对复杂决策问题进行建模. 将RSU在任务卸载与缓存管理中的动态资源分配问题建模为0-1优化模型,并将离散决策变量融入MDP的状态与动作空间中进行求解,从而在动态环境下实现实时性与资源利用率的平衡. MDP的基本要素包括状态空间、动作空间、转移函数、奖励函数及折扣因子.
在MDP框架下,MEC系统中的RSU在每个时隙
状态空间
式中:
动作空间
状态-动作映射关系:状态-动作映射由策略网络实现,用于将系统状态映射为具体决策动作. 智能体基于任务属性、资源状态及环境信息提取特征,评估各动作的预期效用并输出动作概率分布.训练阶段通过采样或
奖励函数
式中:N为系统的惩罚值.
转移函数
折扣因子
式中:当
2.2. 基于EUPPO算法的边缘计算与缓存优化方法
在高度动态且不确定性强的车联网环境中,传统PPO算法由于裁剪参数固定且缺乏对环境不确定性的感知,难以在不同阶段有效平衡探索与利用. 提出EUPPO算法,通过综合网络带宽、任务复杂度及时延等因素动态调整探索强度,实现任务卸载与资源分配优化,从而提升资源利用率并降低系统延迟.
EUPPO网络以MEC系统主动感知的环境信息作为输入,通过策略网络
图 2
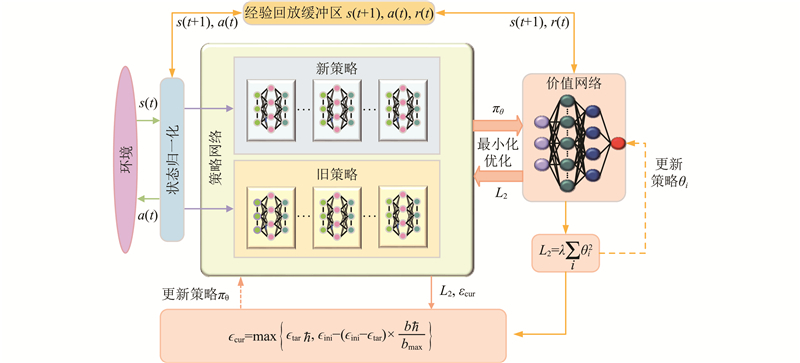
图 2 策略网络与价值网络的结构及优化流程图
Fig.2 Structural and optimization flowchart of actor network and critic network
通过价值网络
EUPPO通过PPO-Clip机制对策略更新进行裁剪,限制新旧策略的偏离幅度,从而提高训练稳定性并避免收敛不良的问题.
式中:
EUPPO算法用于提升算法在动态车联网环境中的性能,核心机制如下.
1)不确定性感知探索. 针对传统PPO预设探索策略难以适应车联网高度动态性的问题,EUPPO引入基于熵的感知机制. 该机制通过计算动作概率分布的熵值量化当前状态的决策不确定性,并据此动态调整探索强度:在高熵值(低确定性)状态下自动增强探索以跳出局部最优,在低熵值状态下侧重利用现有的策略,使算法在复杂环境中兼顾决策的寻优能力与稳定性
2)自适应衰减裁剪参数
式中:
3)L2正则化项的应用. 在复杂的车联网环境中,高维状态空间及动态数据易导致模型在训练过程中出现过拟合,从而影响泛化性能. L2正则化通过在损失函数中增加模型参数平方和的加权项
式中:
3. 仿真结果与分析
构建并模拟RSU辅助的MEC系统,基于Python开发仿真环境. 为了更真实地模拟车联网的动态性,在仿真开始前,系统会执行预热阶段,使各类任务的流行度稳定至非零的初始状态.在仿真过程中,综合考虑传输延迟、计算负载及网络状况等关键参数. 具体的参数配置详见表1.
表 1 车联网MEC系统的仿真参数配置
Tab.1
| 参数 | 数值 | 参数 | 数值 | |
| 低轨卫星数量 | 1 | 0.9 | ||
| u | 3 | 0.9 | ||
| RSU计算速度/( MB·s−1) | [5,10] | 0.1 | ||
| 车辆计算速度/( MB·s−1) | [3,6] | 200 | ||
| RSU内置缓存容量/MB | 4 | 0.99 | ||
| 0.1 | 价值网络学习率 | 0.000 3 | ||
| 0.067 | 策略网络学习率 | 0.000 3 | ||
| 1 | 裁剪参数 | 0.2 | ||
| 目标权重因子 | 0.99 | GAE参数 | 0.95 |
3.1. EUPPO算法模块的性能评估
为了评估引入的各个模块对整体性能的影响,开展模块分析实验. 其中,算法①为在PPO基础上仅引入不确定性感知探索机制,②在①的基础上引入自适应裁剪参数,③在②上引入L2正则化项,④为传统PPO算法. 实验结果如表2所示,随着模块的逐步引入,模型的各项指标均稳步提升. 仅引入不确定性感知探索机制的配置相较于传统PPO在缓存命中数上提升了6.5%. 在引入自适应clip参数后,缓存命中率提升至0.72,奖励值达到1 739,显示出clip参数对改善训练过程的积极作用. 在此基础上加入L2正则项,虽然在最终性能指标上的提升相对有限,但在训练过程中表现出更快的收敛速度.
表 2 EUPPO算法模块的性能对比
Tab.2
| 算法 | 缓存命中数 | 缓存命中率 | 奖励值 | 奖励收敛速度 |
| ① | 1 686 | 0.67 | 280 | |
| ② | 1 721 | 0.72 | 280 | |
| ③ | 1 722 | 0.72 | 1 740 | 210 |
| ④ | 1 583 | 0.58 | 300 |
3.2. 性能收敛性评估
图 3
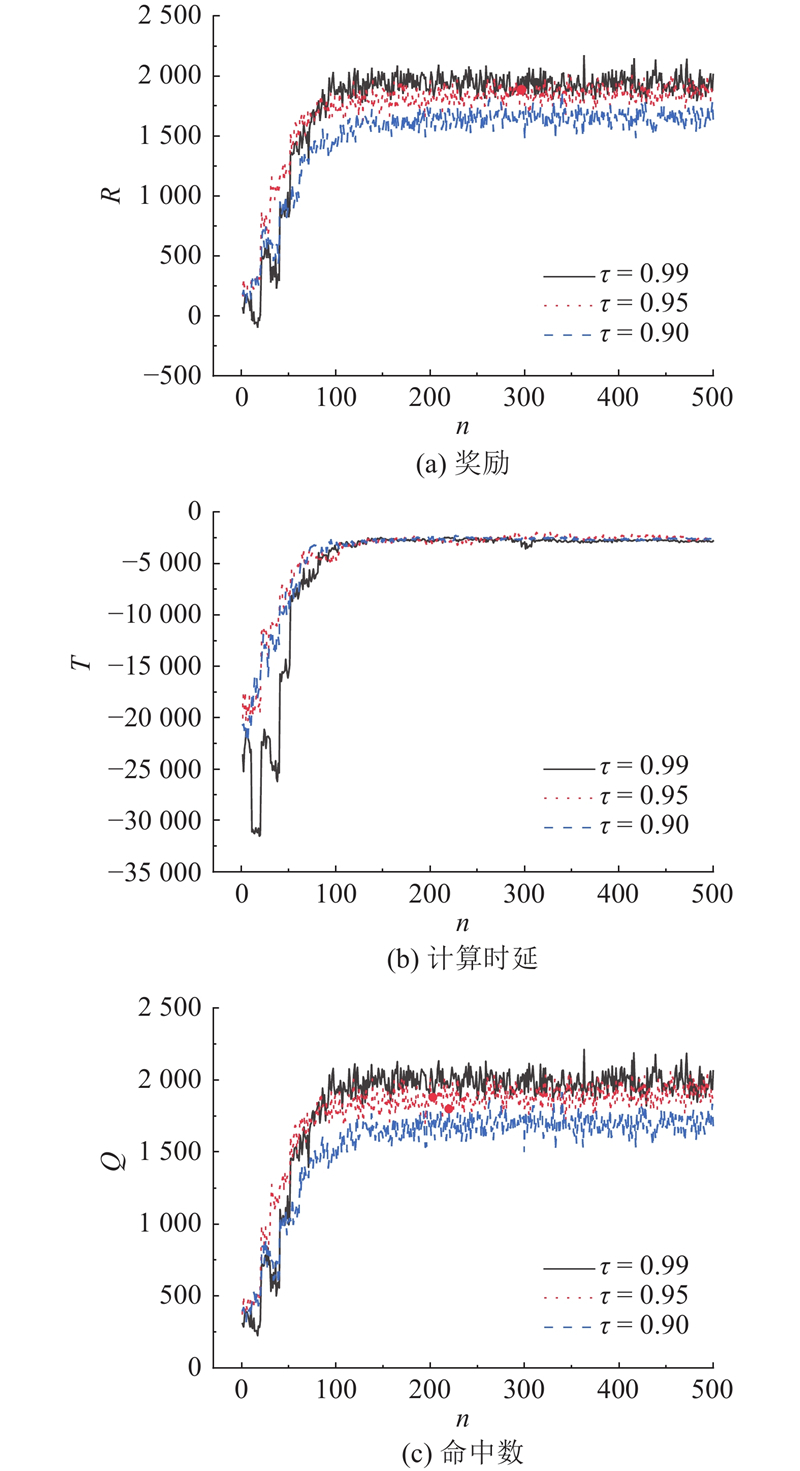
图3(b)中,
如图3(c)所示为
由于计算延迟与缓存命中数在数值上存在差异,在后续实验中,将
3.3. 不同参数下的车辆请求响应率分析
图 4
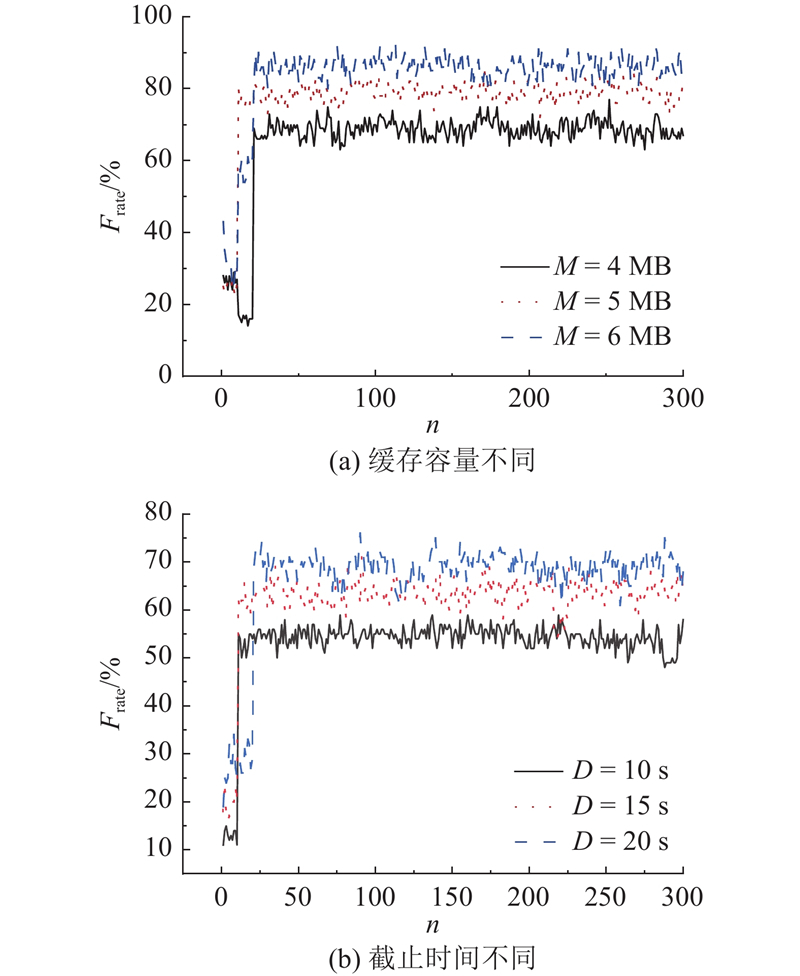
图 4 不同环境参数对响应率的影响
Fig.4 Impact of different environment parameters on response rate
为了对比不同缓存策略的性能,默认缓存容量为4 MB. 在此容量下,每个RSU可以同时缓存约8个任务,同时系统仍能维持约70%的车辆请求响应率.
3.4. 不同缓存策略的性能比较
在分析缓存容量和任务截止时间对响应率作用的基础上,进一步对比了多种缓存策略的性能差异. 如图5所示,在不同缓存大小下,对EU-Hawkes、Hawkes、LFU和LRU 4种缓存策略的缓存命中率进行评估. 其中,
图 5
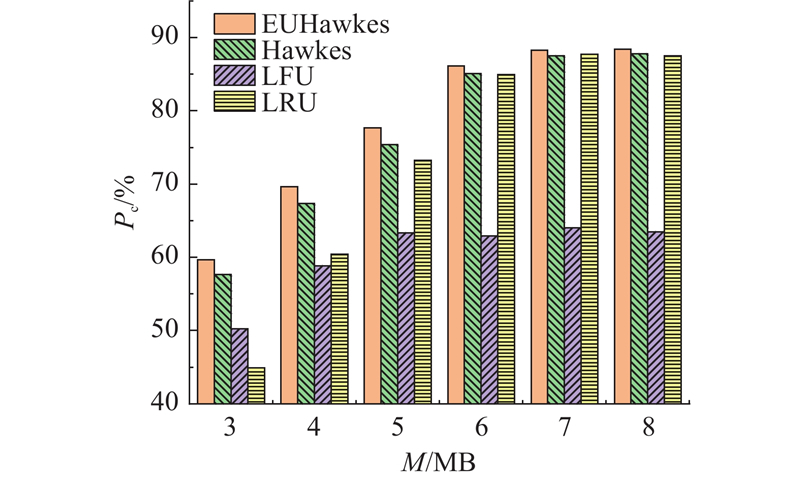
图 5 不同缓存容量下的缓存命中率对比
Fig.5 Comparison of cache hit rate under different cache capacities
这一优势源于EU-Hawkes融合了任务需求预测与自激特性,能够更好地刻画动态环境. Hawkes在处理不确定性因素方面存在不足,LFU和LRU未能反映需求的动态变化,因而性能较低.
3.5. DRL算法的对比实验
对改进型缓存模型EU-Hawkes及改进算法EUPPO在MEC环境下的性能进行评估,分析学习率对平均回合奖励的影响. 如图6所示,平均奖励随着学习率的增大而提高. 其中,
图 6
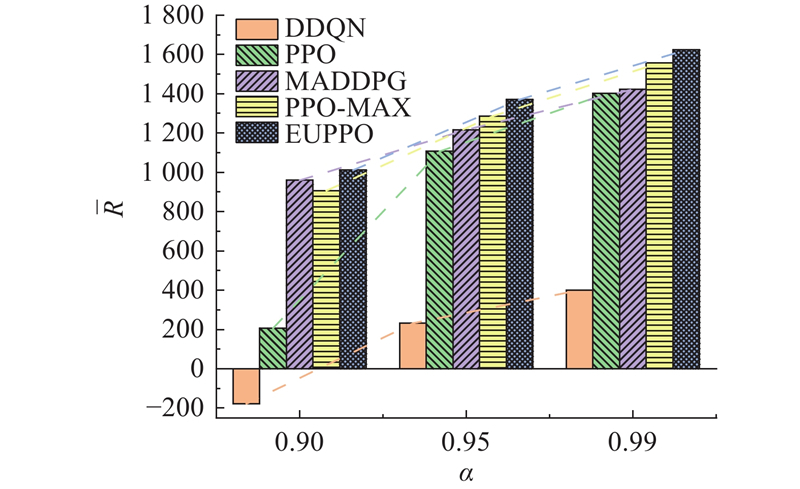
图 6 不同学习率与奖励的对比实验
Fig.6 Comparison experiment of different learning rates and rewards
EUPPO表现最优,当学习率为0.99时获得最高平均奖励. EUPPO算法的性能提升源于不确定性感知探索与自适应参数调节机制,使其在动态环境中具备更好的稳定性与适应性.与 MADDPG、PPO及当前最优的PPO-MAX相比,EUPPO在各项指标上均表现更优,因此后续实验将学习率固定为0.99.
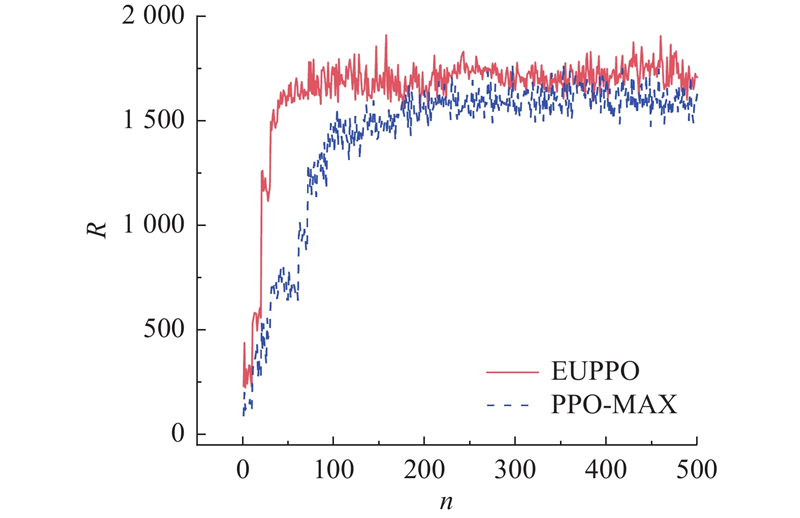
如图7所示为不同算法在每100个回合下的平均奖励变化趋势. 结果显示,EUPPO的收敛速度更快,并在约200个回合后稳定于约1 700,整体性能优于所有的对比算法. 与PPO-MAX相比,稳定奖励提升了6.8%. 与原始PPO相比,总奖励提升了15.1%,验证了所提方法的有效性.
图 7
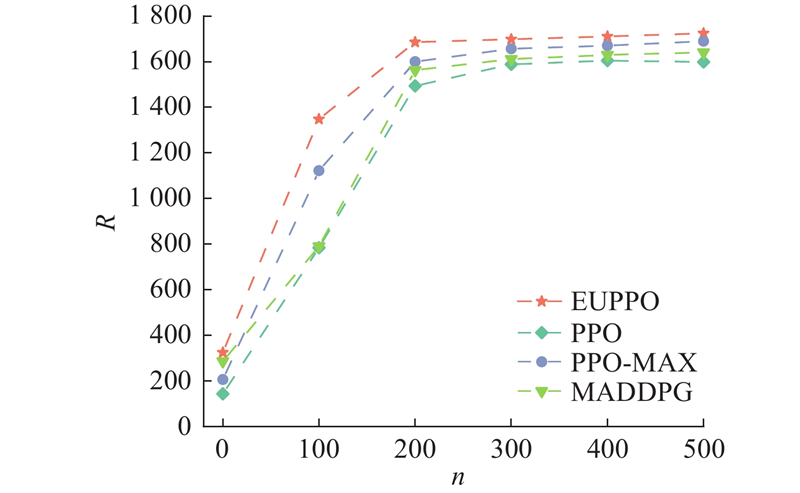
图 7 不同算法在各训练回合下的平均奖励对比
Fig.7 Comparison of average rewards across training episodes for different algorithms
由于PPO-MAX较PPO、MADDPG和DDQN表现更优,后续实验重点对比PPO-MAX与EUPPO算法,以验证所提方法的性能优势.
图 8
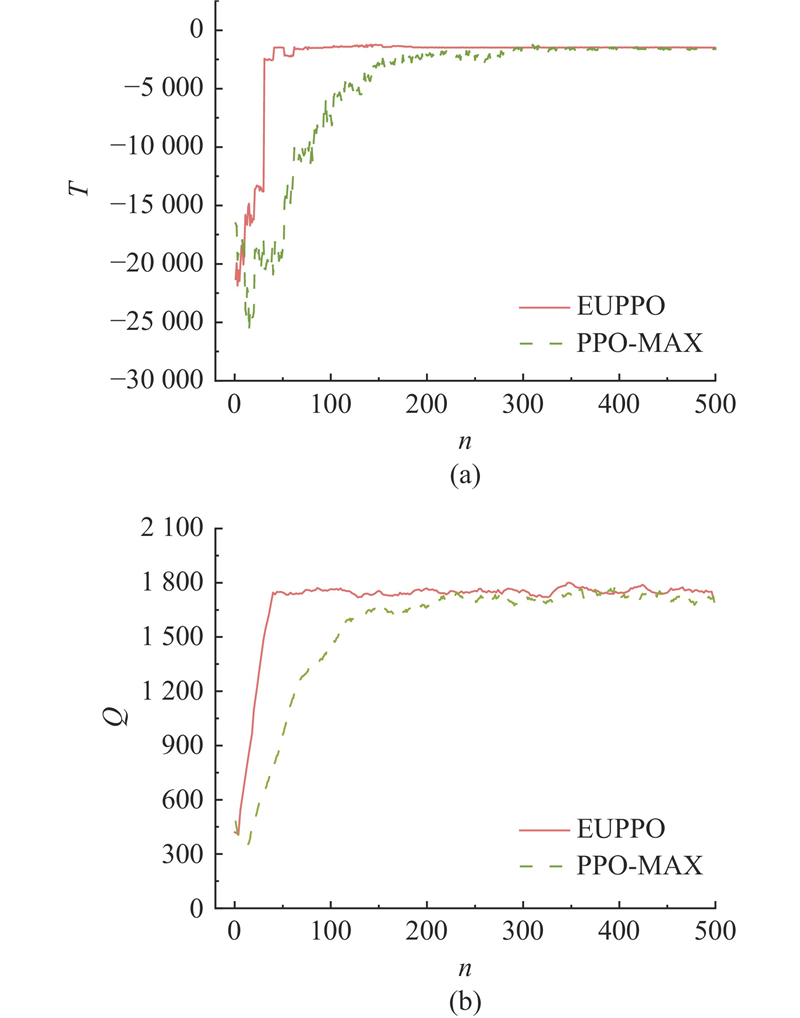
如图9所示,EUPPO在训练早期即可实现奖励的快速收敛并保持高位,整体性能优于PPO-MAX. EUPPO的优势与较高的缓存命中数相关,从而提升了任务执行效率;PPO-MAX收敛较慢且奖励较低,反映PPO-MAX在动态环境中的适应性及资源优化能力存在不足.
图 9
4. 结 语
针对MEC环境下的车联网任务卸载与资源分配问题,提出基于RSU协同的联合优化方法.通过将任务卸载与资源分配建模为0-1优化问题并转化为马尔可夫决策过程,结合改进的EUPPO算法进行求解,引入融合不确定性因素的EU-Hawkes模型实现任务需求预测与缓存优化,从而提升系统的整体决策能力. 仿真结果表明,采用所提方法,在动态车联网场景下能够有效地降低任务处理延迟并提高响应率,整体性能优于对比算法. 实际部署时可能受到通信不稳定、资源受限及车辆高动态移动等因素影响. 未来将进一步研究多模态数据融合、多智能体强化学习及安全隐私机制,提升方法的鲁棒性与实用性.
参考文献
Recent survey on Internet of vehicles: architecture, applications, challenges, and its solutions
[J].DOI:10.1520/JTE20230095 [本文引用: 1]
Low-power secure caching strategy for internet of vehicles
[J].DOI:10.1007/s11276-023-03271-2
Collaborative intelligent traffic planning in the internet of vehicles
[J].DOI:10.3390/s24041303 [本文引用: 1]
A multi-objective computation offloading algorithm in MEC environments
[J].
Efficient task offloading and resource allocation in MEC
[J].DOI:10.4018/jcit.371753 [本文引用: 1]
Performance analysis of RSU relaying in the vehicular network
[J].DOI:10.7840/kics.2022.47.3.522 [本文引用: 1]
Deep reinforcement learning method of offloading decision and resource allocation in MEC
[J].
Adaptive request scheduling and service caching for MEC-assisted IoT networks: an online learning approach
[J].DOI:10.1109/JIOT.2022.3157677 [本文引用: 1]
Energy and latency efficient caching in mobile edge networks: survey, solutions, and challenges
[J].DOI:10.1007/s11277-023-10187-9 [本文引用: 1]
Adaptive priority-based cache replacement and prediction-based cache prefetching in edge computing environment
[J].DOI:10.1016/j.jnca.2020.102715 [本文引用: 1]
Intelligent and efficient task caching for mobile edge computing
[J].DOI:10.1007/s10586-024-04658-2 [本文引用: 1]
A trust-based malicious RSU detection mechanism in edge-enabled vehicular Ad Hoc networks
[J].DOI:10.3329/jasbs.v51i1.82796 [本文引用: 1]
Notice of violation: a 3D printed multi-mode conical dielectric resonant antenna with stable omnidirectional radiation patterns for 5G vehicle picocell applications
[J].DOI:10.1109/tvt.2022.3196909 [本文引用: 1]
Collaborative data scheduling for vehicular edge computing via deep reinforcement learning
[J].DOI:10.1109/JIOT.2020.2983660 [本文引用: 1]
MESON: a mobility-aware dependent task offloading scheme for urban vehicular edge computing
[J].DOI:10.1109/TMC.2023.3289611 [本文引用: 1]
Deep reinforcement learning-based joint optimization model for vehicular task offloading and resource allocation
[J].DOI:10.1007/s12083-024-01693-z [本文引用: 1]
Multi-dimensional task offloading using deep learning for vehicular edge computing networks: a survey
[J].DOI:10.5573/ieiespc.2024.13.1.1 [本文引用: 1]


