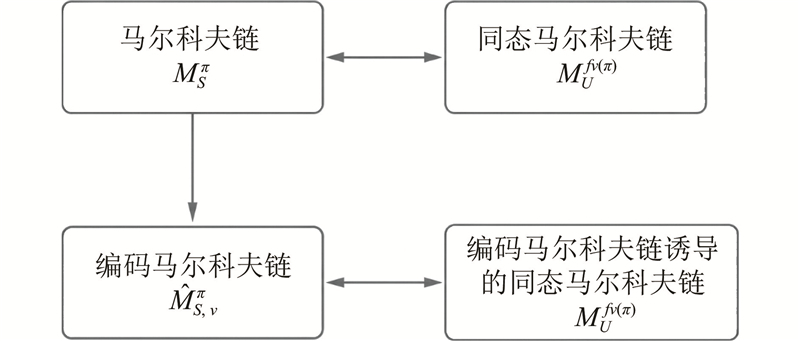
(23) $ \begin{split}&{\nabla }_{\theta }V_{U}^{{f}_{\nu }({\pi }_{\theta })}(u) =\sum \limits_{t=0}^{T}{\gamma }^{t}\sum \limits_{x\in U}p\left(u\rightarrow x,k,{\pi }_{\theta }\right)\times \\&\qquad {{E}}_{{{S}_{t}}\sim \nu (\cdot \mid x),{{A}_{t}}\in {{\pi }_{\theta }}(\cdot \mid {{S}_{t}})}\left[r\left({S}_{t},{A}_{t}\right){\nabla }_{\theta }\ln {\pi }_{\theta }\left({A}_{t}\mid {S}_{t}\right)\right]+\\& \qquad \gamma {{E}}_{{{S}_{t}}\sim \nu (\cdot \mid x),{{A}_{t}}\in {{\pi }_{\theta }}(\cdot \mid {{S}_{t}}),Y\sim {{P}_{1}}(\cdot \mid {{S}_{t}},{{A}_{t}})}\left[{\nabla }_{\theta }\ln {\pi }_{\theta }\left({A}_{t}\mid {S}_{t}\right)\times \right.\\& \qquad\left. V_{U}^{{f}_{\nu }\left({\pi }_{\theta }\right)}(Y)\right]=\\&\qquad\sum \limits_{x\in U}\eta \left(x\mid f\left({\pi }_{\theta }\right),u\right){{E}}_{{{S}_{t}}\sim \nu (\cdot \mid x),{{A}_{t}}\in {{\pi }_{\theta }}\left(\cdot \mid {S}_{t}\right),Y\sim {{P}_{1}}\left(\cdot \mid {S}_{t},{A}_{t}\right)}\times \\&\qquad \left[{\nabla }_{\theta }\ln {\pi }_{\theta }\left({A}_{t}\mid {S}_{t}\right)\left[r\left({S}_{t},{A}_{t}\right)+\gamma V_{U}^{{f}_{\nu }\left({\pi }_{\theta }\right)}(Y)\right]\right]=\\&\qquad{{E}}_{{{X}_{t}}\sim \eta \left(\cdot \mid f\left({\pi }_{\theta }\right),u\right),{{S}_{t}}\sim \nu \left(\cdot \mid {X}_{t}\right),{{A}_{t}}\in {{\pi }_{\theta }}\left(\cdot \mid {S}_{t}\right)}\left\{{\nabla }_{\theta }\ln {\pi }_{\theta }\left({A}_{t}\mid {S}_{t}\right)\times \right.\\& \qquad\left. \left[r\left({S}_{t},{A}_{t}\right)+\gamma {{E}}_{Y\sim {{P}_{1}}\left(\cdot \mid {S}_{t},{A}_{t}\right)}\left[V_{U}^{{f}_{\nu }\left({\pi }_{\theta }\right)}(Y)\right]\right]\right\}.\end{split} $
[1]
赵威, 张万枝, 侯加林, 等 基于多智能体强化学习的农业机器人路径规划方法
[J]. 浙江大学学报(工学版) , 2025 , 59 (7 ): 1492 - 1503
[本文引用: 1]
Zhao Wei, Zhang Wanzhi, Hou Jialin, et al A path planning method based on multi-agent reinforcement learning for agricultural robots
[J]. Journal of Zhejiang University(Engineering Science) , 2025 , 59 (7 ): 1492 - 1503
[本文引用: 1]
[2]
高洪伟, 尚秉旭, 张鑫康, 等 基于可达集和强化学习的智能汽车决策规划
[J]. 浙江大学学报(工学版) , 2025 , 59 (9 ): 1996 - 2004
[本文引用: 1]
Gao Hongwei, Shang Bingxu, Zhang Xinkang, et al Decision-making and planning of intelligent vehicles based on reachable sets and reinforcement learning
[J]. Journal of Zhejiang University(Engineering Science) , 2025 , 59 (9 ): 1996 - 2004
[本文引用: 1]
[3]
汤佳伟, 郭铁铮, 闻英友 基于强化学习的Kubernetes云边协同计算调度算法
[J]. 浙江大学学报(工学版) , 2025 , 59 (11 ): 2400 - 2408
[本文引用: 1]
Tang Jiawei, Guo Tiezheng, Wen Yingyou Computing scheduling algorithm for Kubernetes cloud-edge synergy based on reinforcement learning
[J]. Journal of Zhejiang University(Engineering Science) , 2025 , 59 (11 ): 2400 - 2408
[本文引用: 1]
[4]
Azar M G, Munos R, Kappen H J Minimax PAC bounds on the sample complexity of reinforcement learning with a generative model
[J]. Machine Learning , 2013 , 91 (3 ): 325 - 349
DOI:10.1007/s10994-013-5368-1
[本文引用: 1]
[5]
Gao Bin, Pavel L On passivity, reinforcement learning, and higher order learning in multiagent finite games
[J]. IEEE Transactions on Automatic Control , 2021 , 66 (1 ): 121 - 136
DOI:10.1109/TAC.2020.2978037
[6]
Sidford A, Wang Mengdi, Wu Xian, et al Variance reduced value iteration and faster algorithms for solving Markov decision processes
[J]. Naval Research Logistics , 2023 , 70 (5 ): 423 - 442
DOI:10.1002/nav.21992
[本文引用: 1]
[7]
Aoki M Some approximation methods for estimation and control of large-scale systems
[J]. IEEE Transactions on Automatic Control , 1978 , 23 (2 ): 173 - 182
DOI:10.1109/TAC.1978.1101705
[本文引用: 1]
[8]
Lastman G, Sinha N A comparison of the balanced matrix method and the aggregation method of model reduction
[J]. IEEE Transactions on Automatic Control , 1985 , 30 (3 ): 301 - 304
DOI:10.1109/TAC.1985.1103941
[9]
Li Haitao, Liu Yang, Wang Shunli, et al State feedback stabilization of large-scale logical control networks via network aggregation
[J]. IEEE Transactions on Automatic Control , 2021 , 66 (12 ): 6033 - 6040
DOI:10.1109/TAC.2021.3057139
[10]
Sahabandu D, Moothedath S, Allen J, et al RL-ARNE: a reinforcement learning algorithm for computing average reward Nash equilibrium of nonzero-sum stochastic games
[J]. IEEE Transactions on Automatic Control , 2024 , 69 (11 ): 7824 - 7831
DOI:10.1109/TAC.2024.3403693
[本文引用: 1]
[11]
杜晓昕, 王浩, 崔连和, 等 基于聚类和探测精英引导的蜻蜓算法
[J]. 浙江大学学报 (工学版) , 2022 , 56 (5 ): 977 - 986
[本文引用: 1]
Du Xiaoxin , Wang Hao, Cui Lianhe, et al Dragonfly algorithm based on clustering and probe elite guidance
[J]. Journal of Zhejiang University (Engineering Science) , 2022 , 56 (5 ): 977 - 986
[本文引用: 1]
[12]
Bertsekas D P, Castanon D A Adaptive aggregation methods for infinite horizon dynamic programming
[J]. IEEE Transactions on Automatic Control , 1989 , 34 (6 ): 589 - 598
DOI:10.1109/9.24227
[本文引用: 2]
[13]
Li Lihong, Walsh T J, Littman M L. Towards a unified theory of state abstraction for MDPs [C] // Proceedings of the 9th International Symposium on Artificial Intelligence and Mathematics . Fort Lauderdale: Florida Atlantic University, 2006: 531–539.
[本文引用: 1]
[15]
Abel D, Hershkowitz D, Littman M L. Near optimal behavior via approximate state abstraction [C] // International Conference on Machine Learning , 2016: 2915–2924.
[本文引用: 1]
[16]
Ravindran B. An algebraic approach to abstraction in reinforcement learning [D]. Amherst: University of Massachusetts Amherst, 2004: 1-182.
[本文引用: 1]
[17]
Ferns N, Panangaden P, Precup D Bisimulation metrics for continuous Markov decision processes
[J]. SIAM Journal on Computing , 2011 , 40 (6 ): 1662 - 1714
DOI:10.1137/10080484X
[本文引用: 1]
[18]
Van der Pol E, Worrall D E, Van Hoof H, et al. MDP homomorphic networks: Group symmetries in reinforcement learning [C] // Advances in Neural Information Processing Systems . Red Hook: Curran Associates, Inc. 2020, 33: 4199–4210.
[本文引用: 1]
[19]
Zhao Shuo, Li Yongqiang, Feng Yu, et al. Homomorphic mappings for value-preserving state aggregation in Markov decision processes [PP/OL]. arXiv (2025-10-11)[2025-12-01]. https://arxiv.org/abs/2510.09965.
[本文引用: 6]
[20]
Mahadevan S, Maggioni M Proto-value functions: a Laplacian framework for learning representation and control in Markov decision processes
[J]. Journal of Machine Learning Research , 2007 , 8 : 2169 - 2231
[本文引用: 1]
[21]
Geist M, Scherrer B. Off-policy learning with linear function approximation [C] // Proceedings of the 31st International Conference on Machine Learning , 2014: 262–270.
[本文引用: 1]
[22]
Ravindran B, Barto A G. Approximate homomorphisms: a framework for non-exact minimization in Markov decision processes [C] // Proceedings of the 5th International Conference on Knowledge Based Computer Systems . Mumbai: Allied Publishers, 2004.
[本文引用: 1]
[23]
Bao Bing, Yin Baoqun , Xi Hongsheng. Infinite-horizon policy-gradient estimation with variable discount factor for Markov decision process [C] //3rd International Conference on Innovative Computing Information and Control . Dalian: IEEE, 2008: 584–584.
[本文引用: 1]
[24]
Ferns N, Precup D. Bisimulation metrics are optimal value functions [C] // Proceedings of the Conference on Uncertainty in Artificial Intelligence . Quebec City: AUAI Press, 2014: 210–219.
[本文引用: 1]
[25]
Forghieri O, Castel H, Hyon E, et al. Progressive state space disaggregation for infinite horizon dynamic programming [C] // Proceedings of the 34th International Conference on Automated Planning and Scheduling . Banff: AAAI Press, 2024, 34(1): 221–229.
[本文引用: 2]
[26]
Sutton R S, Precup D, Singh S Between MDPs and semi-MDPs: a framework for temporal abstraction in reinforcement learning
[J]. Artificial Intelligence , 1999 , 112 (1/2 ): 181 - 211
DOI:10.1016/s0004-3702(99)00052-1
[本文引用: 1]
[27]
Sutton R S, Barto A G. Reinforcement learning: an introduction [M]. Cambridge: MIT Press, 2018.
[本文引用: 1]
[28]
Ohno K, Ichiki K Computing optimal policies for controlled tandem queueing systems
[J]. Operations Research , 1987 , 35 (1 ): 121 - 126
DOI:10.1287/opre.35.1.121
[本文引用: 1]
[29]
Tournaire T, Jin Y, Aghasaryan A, et al. Factored reinforcement learning for auto-scaling in tandem queues [C] // Proceedings of the IEEE/IFIP Network Operations and Management Symposium . Budapest: IEEE, 2022: 1–7.
[本文引用: 1]
[30]
Ayoub A, Jia Z, Szepesvari C, et al. Model-based reinforcement learning with value-targeted regression [C] // Proceedings of the 37th International Conference on Machine Learning , 2020: 463–474.
[本文引用: 2]
[31]
Chen Guanting, Gaebler J D, Peng M, et al. An adaptive state aggregation algorithm for Markov decision processes [PP/OL]. arXiv (2021-07-23)[2025-12-01]. https://arxiv.org/abs/2107.11053.
[32]
Ishfaq H, Cui Qiwen, Nguyen V, et al. Randomized exploration in reinforcement learning with general value function approximation [C]// Proceedings of the 38th International Conference on Machine Learning , 2021: 4607–4616.
[本文引用: 1]
[33]
Lee J, Oh M. Demystifying linear MDPs and novel dynamics aggregation framework [C]// The 12th International Conference on Learning Representations , 2024: 1-17.
[本文引用: 3]
基于多智能体强化学习的农业机器人路径规划方法
1
2025
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
基于可达集和强化学习的智能汽车决策规划
1
2025
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
基于强化学习的Kubernetes云边协同计算调度算法
1
2025
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
Minimax PAC bounds on the sample complexity of reinforcement learning with a generative model
1
2013
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
On passivity, reinforcement learning, and higher order learning in multiagent finite games
0
2021
Variance reduced value iteration and faster algorithms for solving Markov decision processes
1
2023
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
Some approximation methods for estimation and control of large-scale systems
1
1978
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
A comparison of the balanced matrix method and the aggregation method of model reduction
0
1985
State feedback stabilization of large-scale logical control networks via network aggregation
0
2021
RL-ARNE: a reinforcement learning algorithm for computing average reward Nash equilibrium of nonzero-sum stochastic games
1
2024
... 强化学习(reinforcement learning, RL)在解决序列决策问题方面取得了显著成就,被广泛应用于机器人控制[1 ] 、游戏博弈轨迹规划[2 ] 以及复杂系统调度等领域[3 ] . 随着应用场景的日趋复杂,离散状态空间常呈现指数级扩张,导致状态数量急剧增加. 面对海量的状态,直接学习价值函数或策略不仅计算代价高昂,而且难以收敛[4 -6 ] . 为了应对这一挑战,状态抽象技术[7 -10 ] 应运而生. 该技术旨在通过将原始庞大的状态空间映射到维度缩减的潜在空间,在保留关键决策信息的同时去除冗余细节,从而显著降低计算复杂度并提升样本效率. 如何构建既能有效压缩状态数量,又能保证策略最优性的抽象映射,是当前大规模强化学习研究的核心挑战. ...
基于聚类和探测精英引导的蜻蜓算法
1
2022
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
基于聚类和探测精英引导的蜻蜓算法
1
2022
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
Adaptive aggregation methods for infinite horizon dynamic programming
2
1989
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
1
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
Learning to perceive and act by trial and error
1
1991
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
1
... 在现有方法中,基于启发式或聚类的状态聚合方法[11 -12 ] 较典型,主要依据特征相似性对状态进行划分. 这类方法本质上属于有损抽象,因忽略了马尔可夫决策过程(MDP)底层的转移概率、奖励函数这些动力学结构[13 ] ,易引发“状态混淆”[14 ] 问题. 这使得在抽象空间中学习的策略在被还原至原始空间时,无法保证性能一致性,从而限制了该类方法在复杂任务中的应用[15 ] . ...
1
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
Bisimulation metrics for continuous Markov decision processes
1
2011
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
1
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
6
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
... Zhao等[19 ] 引入编码马尔可夫链的概念,旨在对同态映射中的逼近误差进行系统性表征. 将原始条件式$ \boldsymbol{P}_{U}^{\mu }{\boldsymbol{P}}_{\nu }={\boldsymbol{P}}_{\nu }\boldsymbol{P}_{S}^{\pi } $
... 为了形式化描述这种误差,Zhao等[19 ] 给出编码马尔可夫链存在的充分必要条件:当编码矩阵$ {\boldsymbol{P}}_{\nu } $ $ {F} $ $ {f}_{\nu } $ $ \pi \in {\varPi }_{S} $ $ {\boldsymbol{C}}^{\pi }=\boldsymbol{P}_{S}^{\pi }\boldsymbol{P}_{\nu }^{\dagger } $ . ...
... 类似于Zhao等[19 ] 的工作,基于上述优化理论提出基于模型的优化算法,即算法1. 其中,lr为学习率. ...
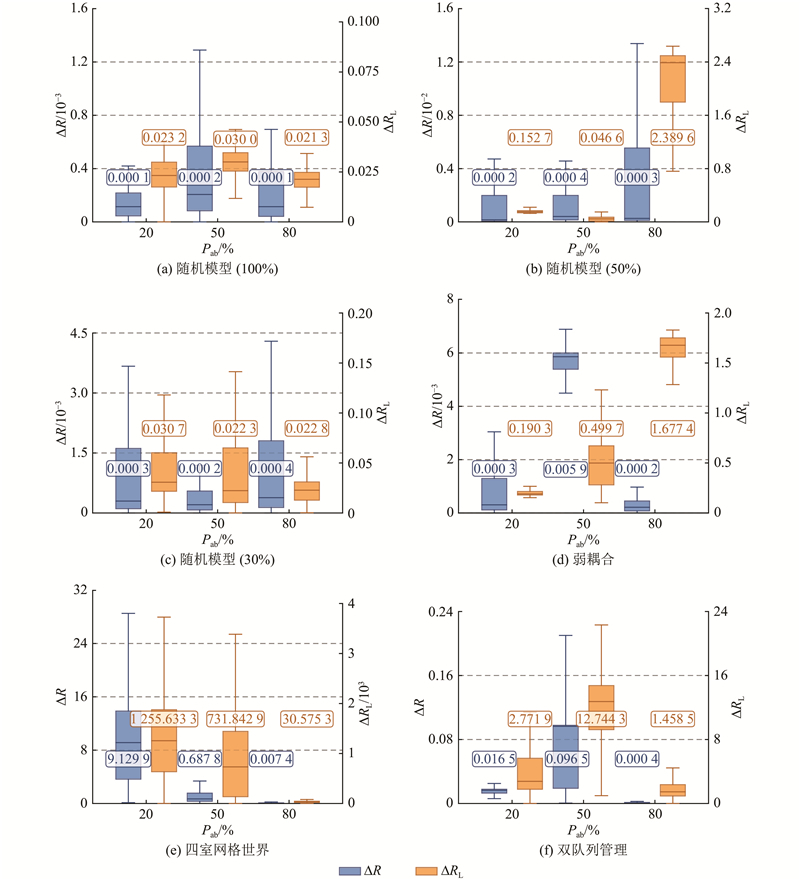
... 如图3 所示,对本文方法与EBHPG[19 ] 在不同任务下的性能及理论下界差异进行对比. 其中,∆R 为本文方法和EBHPG的实际性能差异,∆R L 为本文方法和EBHPG的下界性能差异. EBHPG采用伪逆运算,在矩阵病态时数值不稳定,导致惩罚项激增,并使得下界松弛失效. 相比之下,提出的正交投影法通过几何约束保证了算子的规范性,显著抑制了惩罚项的增长. 实验结果表明,本文方法的理论下界与实际性能之间更趋一致,在非对称任务(如四室网格世界和双队列管理)中表现出极强的稳健性. 综上所述,正交投影机制在保持零损失的同时,有效克服了基线方法的波动性和不适定性,后续工作将进一步验证该方法在更具挑战性任务中的性能. ...
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
Proto-value functions: a Laplacian framework for learning representation and control in Markov decision processes
1
2007
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
1
... 为了克服上述结构性偏差,基于MDP同态(homomorphism)理论[16 ] 的抽象方法逐渐受到关注. 这类方法通过严格的代数约束保持动力学一致性,但在实际应用中往往难以满足精确转移所需的严苛条件[17 ] . 近期,同态马尔可夫链(HMC)框架[18 ] 通过线性约束证明在更弱条件下仍可满足策略等价性,并由此衍生出基于最小二乘投影的近似聚合方法(如EBHPG)[19 ] . EBHPG算法依赖于编码矩阵的伪逆运算[20 ] ,在大规模或稀疏空间下易出现数值病态,这导致投影误差失控以及性能下界偏松,并在复杂拓扑任务中表现出显著的收敛不稳定性[21 ] . ...
1
... 在MDP的语境中,同态定义了从基础MDP到简化抽象MDP的结构保持映射,该映射通过聚合在转移动态和奖励方面表现出等价行为的状态-动作对[22 ] 来实现. 更具体地,给定一个基础MDP到一个抽象MDP的同态由一对满射映射定义:$ e( S \rightarrow {S}^{\prime} )$ $ {g}_{s}( A \rightarrow {A}^{\prime}) $ $ h(s,a) = (e(s),{g}_{s}(a)) $ . 如果对于所有$ {s}^{\prime}\in S $ $ (s,a)\in S\times A $
1
... 该引理可以根据文献[23 ]进行证明. ...
1
... 提出最优策略等价性的定义,这一概念与最优耦合存在一定的关联[24 ] . ...
2
... Experimental task configurations and parameter descriptions
Tab.1 任务名称 任务说明 随机模型[25 ] 转移密度为10%~100%,奖励为0~1.0 弱耦合MDP[26 ] 由具有‘簇内转移稠密、簇间转移稀疏’特征的不相交状态簇构成的复杂系统 四室网格世界(Room)[27 ] 动作成功率为0.8的持续任务 双队列管理问题[28 ] 涉及9种联合操作的串行服务器负载平衡问题[29 ]
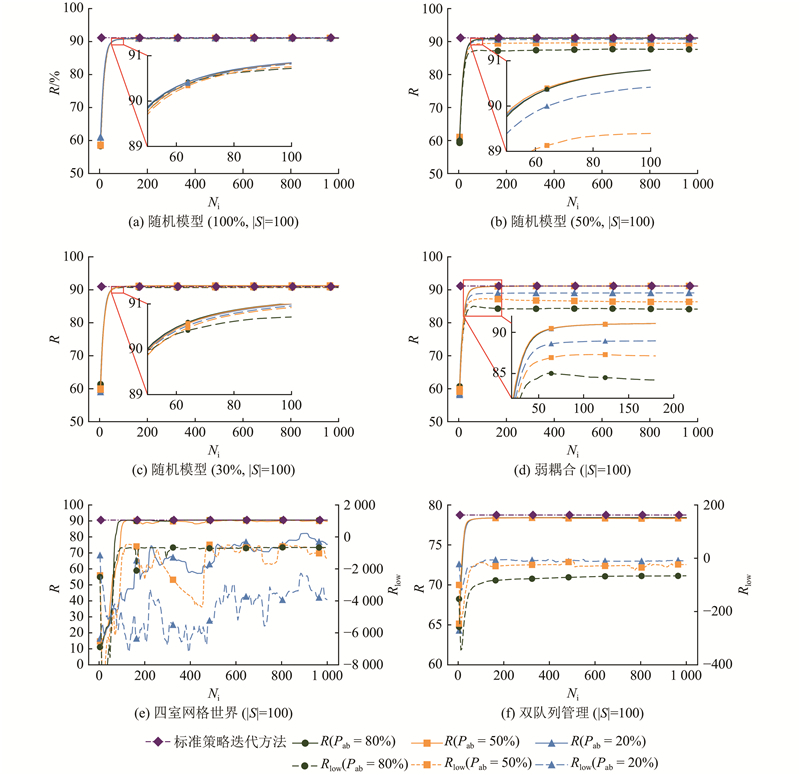
3.1. 理论验证实验 如表2 所示为实验的参数设置. 如图2 所示为不同任务下的策略性能随迭代次数N i 的变化. 其中,R 为实际的累积奖励,R low 为累积奖励的理论下界,P ab 为抽象状态空间占比. 随机模型设有30%、50%和100% 3种密度等级,实线与虚线分别对应实际性能及其下界(图2 (e)、(f)中的虚线参考右轴). 菱形标记虚线表示40 000次迭代后的结果,并作为最优性能的近似. ...
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
Between MDPs and semi-MDPs: a framework for temporal abstraction in reinforcement learning
1
1999
... Experimental task configurations and parameter descriptions
Tab.1 任务名称 任务说明 随机模型[25 ] 转移密度为10%~100%,奖励为0~1.0 弱耦合MDP[26 ] 由具有‘簇内转移稠密、簇间转移稀疏’特征的不相交状态簇构成的复杂系统 四室网格世界(Room)[27 ] 动作成功率为0.8的持续任务 双队列管理问题[28 ] 涉及9种联合操作的串行服务器负载平衡问题[29 ]
3.1. 理论验证实验 如表2 所示为实验的参数设置. 如图2 所示为不同任务下的策略性能随迭代次数N i 的变化. 其中,R 为实际的累积奖励,R low 为累积奖励的理论下界,P ab 为抽象状态空间占比. 随机模型设有30%、50%和100% 3种密度等级,实线与虚线分别对应实际性能及其下界(图2 (e)、(f)中的虚线参考右轴). 菱形标记虚线表示40 000次迭代后的结果,并作为最优性能的近似. ...
1
... Experimental task configurations and parameter descriptions
Tab.1 任务名称 任务说明 随机模型[25 ] 转移密度为10%~100%,奖励为0~1.0 弱耦合MDP[26 ] 由具有‘簇内转移稠密、簇间转移稀疏’特征的不相交状态簇构成的复杂系统 四室网格世界(Room)[27 ] 动作成功率为0.8的持续任务 双队列管理问题[28 ] 涉及9种联合操作的串行服务器负载平衡问题[29 ]
3.1. 理论验证实验 如表2 所示为实验的参数设置. 如图2 所示为不同任务下的策略性能随迭代次数N i 的变化. 其中,R 为实际的累积奖励,R low 为累积奖励的理论下界,P ab 为抽象状态空间占比. 随机模型设有30%、50%和100% 3种密度等级,实线与虚线分别对应实际性能及其下界(图2 (e)、(f)中的虚线参考右轴). 菱形标记虚线表示40 000次迭代后的结果,并作为最优性能的近似. ...
Computing optimal policies for controlled tandem queueing systems
1
1987
... Experimental task configurations and parameter descriptions
Tab.1 任务名称 任务说明 随机模型[25 ] 转移密度为10%~100%,奖励为0~1.0 弱耦合MDP[26 ] 由具有‘簇内转移稠密、簇间转移稀疏’特征的不相交状态簇构成的复杂系统 四室网格世界(Room)[27 ] 动作成功率为0.8的持续任务 双队列管理问题[28 ] 涉及9种联合操作的串行服务器负载平衡问题[29 ]
3.1. 理论验证实验 如表2 所示为实验的参数设置. 如图2 所示为不同任务下的策略性能随迭代次数N i 的变化. 其中,R 为实际的累积奖励,R low 为累积奖励的理论下界,P ab 为抽象状态空间占比. 随机模型设有30%、50%和100% 3种密度等级,实线与虚线分别对应实际性能及其下界(图2 (e)、(f)中的虚线参考右轴). 菱形标记虚线表示40 000次迭代后的结果,并作为最优性能的近似. ...
1
... Experimental task configurations and parameter descriptions
Tab.1 任务名称 任务说明 随机模型[25 ] 转移密度为10%~100%,奖励为0~1.0 弱耦合MDP[26 ] 由具有‘簇内转移稠密、簇间转移稀疏’特征的不相交状态簇构成的复杂系统 四室网格世界(Room)[27 ] 动作成功率为0.8的持续任务 双队列管理问题[28 ] 涉及9种联合操作的串行服务器负载平衡问题[29 ]
3.1. 理论验证实验 如表2 所示为实验的参数设置. 如图2 所示为不同任务下的策略性能随迭代次数N i 的变化. 其中,R 为实际的累积奖励,R low 为累积奖励的理论下界,P ab 为抽象状态空间占比. 随机模型设有30%、50%和100% 3种密度等级,实线与虚线分别对应实际性能及其下界(图2 (e)、(f)中的虚线参考右轴). 菱形标记虚线表示40 000次迭代后的结果,并作为最优性能的近似. ...
2
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
... 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
1
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
3
... 实验中采用标准策略迭代算法作为主要基准对比方法. 参与比较的算法包括Bertsekas等[12 ] 提出的经典聚合技术,以及Ayoub等[30 -33 , 25 , 19 ] 提出的6种状态聚合方法. 文献[30 , 32 , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
... , 33 ]方法属于无模型方法,其余方法则属于基于模型的方法. 为了确保对比的公平性和可复现性,所有算法均采用默认超参数配置运行,策略优化统一通过策略梯度方法实现(学习率设置为$ 1\times 1{0}^{-3} $ ). ...
... 实验结果表明,所提方法在大规模任务中展现出卓越的收敛效率与数值稳定性. 如图4 (a)、(b)所示,在随机模型与弱耦合任务中,该方法能够迅速收敛至较高奖励区间. 在双队列管理任务(图4 (c))中,尽管所提方法的峰值回报略低于EBHPG,但学习曲线更平滑,且有效抑制了后期振荡,展现出更强的鲁棒性. 在具有复杂拓扑结构的四室网格世界环境(图4 (d))中,传统基于矩阵求逆的方法[33 ] 常因矩阵病态特征导致收敛停滞;相比之下,本文通过引入正交投影算子有效规避了这一技术瓶颈,确保了在数千量级状态空间下仍能取得最优的收敛性能与鲁棒性. ...