浙江大学学报(工学版), 2026, 60(12): 2613-2622 doi: 10.3785/j.issn.1008-973X.2026.12.007

计算机技术

基于对抗图生成的动态蒙特卡洛强化学习

宋莉,, 宛袁玉, 金苍宏,, 宋明黎

1. 浙江树人学院 信息科技学院,浙江 杭州 310015

2. 浙江大学 计算机科学与技术学院,浙江 杭州 310027

3. 浙大城市学院 计算机与计算科学学院,浙江 杭州 310015

4. 浙江大学 软件学院,浙江 宁波 315100

Dynamic Monte-Carlo reinforcement learning based on adversarial graph generation

SONG Li,, WAN Yuanyu, JIN Canghong,, SONG Mingli

1. College of Information Science and Technology, Zhejiang Shuren University, Hangzhou 310015, China

2. College of Computer Science and Technology, Zhejiang University, Hangzhou 310027, China

3. School of Computer and Computing Science, Hangzhou City University, Hangzhou 310015, China

4. School of Software Technology, Zhejiang University, Ningbo 315100, China

通讯作者: 金苍宏,男,教授. orcid.org/0000-0002-9774-9688. E-mail:jinch@hzcu.edu.cn

收稿日期: 2025-09-19  

基金资助: 浙江省“尖兵领雁+X”科技计划资助项目(2025C04019, 2024C01072);浙江省自然科学基金联合基金资助项目(LHZSD24F020001);国家自然科学基金资助项目(62306275, U20B2066).

Received: 2025-09-19  

Fund supported: 浙江省“尖兵领雁+X”科技计划资助项目(2025C04019,2024C01072);浙江省自然科学基金联合基金资助项目(LHZSD24F020001);国家自然科学基金资助项目(62306275,U20B2066).

作者简介 About authors

宋莉(1991—),女,博士,从事图多智能体强化学习算法研究.orcid.org/0000-0003-2616-5156.E-mail:slili516@zjsru.edu.cn , E-mail:slili516@zjsru.edu.cn

摘要

为了解决传统图强化学习(GRL)在节点或边频繁变化的实际场景中,因假设图拓扑与节点连接在短时间内保持不变而无法动态生成或调整图结构的问题,提出基于对抗图生成的多智能体动态蒙特卡洛强化学习算法(GGAN-MCRL),以生成动态图来模拟智能体之间的关系和互动. 该算法的关键思想是利用图生成对抗网络(GGAN)来捕捉动态图中节点或边的实时变化. 与直接在GRL中应用GGAN相比,GGAN-MCRL采用图softmax,使得智能体间的交互强度随距离的增加而衰减,削减了冗余计算. 结合改进的上置信界机制以增强探索能力,降低无效搜索. 实验结果表明,GGAN-MCRL在动态和高维环境中的策略更优,计算效率更高.

关键词: 多智能体强化学习 ; 图生成对抗网络 ; 改进的上置信界 ; 图softmax

Abstract

A multi-agent dynamic Monte-Carlo reinforcement learning based on adversarial graph generation (GGAN-MCRL) algorithm was proposed in order to address the issue that traditional graph reinforcement learning (GRL) cannot dynamically generate or adjust graph structure due to the assumption that the graph topology and node connections remain unchanged in a short period of time in scenarios where nodes or edges frequently change. Dynamic graphs were generated to model the relationships and interactions of agents. The key idea was to exploit a graph generative adversarial network (GGAN) to capture real-time changes of nodes or edges in dynamic graphs. Graph softmax was adopted in GGAN-MCRL compared with directly applying GGAN in GRL. Then the interaction strength between agents decreased with the increase of distance, thereby reducing redundant computation. An improved upper confidence bound mechanism was combined with GGAN-MCRL to enhance exploration capability and reduce ineffective searches. The experimental results show that GGAN-MCRL has better strategies and higher computational efficiency in dynamic and high-dimensional environments.

Keywords: multi-agent reinforcement learning ; graph generative adversarial network ; improved upper confidence bound ; graph softmax

PDF (1478KB) 元数据 多维度评价 相关文章 导出 EndNote| Ris| Bibtex  收藏本文

本文引用格式

宋莉, 宛袁玉, 金苍宏, 宋明黎. 基于对抗图生成的动态蒙特卡洛强化学习. 浙江大学学报(工学版)[J], 2026, 60(12): 2613-2622 doi:10.3785/j.issn.1008-973X.2026.12.007

SONG Li, WAN Yuanyu, JIN Canghong, SONG Mingli. Dynamic Monte-Carlo reinforcement learning based on adversarial graph generation. Journal of Zhejiang University(Engineering Science)[J], 2026, 60(12): 2613-2622 doi:10.3785/j.issn.1008-973X.2026.12.007

近年来,图强化学习(graph reinforcement learning, GRL)作为图神经网络与多智能体强化学习(multi-agent reinforcement learning, MARL)的交叉融合范式,已逐渐发展为处理关系型序列决策问题的重要方法[1-4]. 随着图神经网络技术的不断成熟,该领域涌现出一系列创新研究[5-6]. 为了构建动态状态表征,基于图卷积网络的MARL被用于建模复杂交互[7]. 为了优化信用分配,基于图神经网络的动态奖励机制通过分析节点影响力,实现奖励的合理分配[8]. 为了提升策略的泛化能力,基于演员-评论家框架的MARL算法利用图结构提取全局信息,以增强分布式协调的鲁棒性[9]. 为了提高样本的效率与稳定性,元图强化学习引入元学习策略,使其能够自适应不同的图结构与任务[10]. 尽管上述进展显著,现有方法多数仍建立在静态交互拓扑的假设之上. 早期代表性工作如图Q网络和门控图强化学习[11-12],侧重于从静态的交互拓扑中提取特征以指导智能体决策,并在机器人协作、交通调度、智能物流等典型场景中展现出初步潜力[13]. 这类方法通常基于一个重要假设:智能体之间的交互拓扑是静态不变的. 这一假设在现实动态环境中面临显著挑战:当环境发生突变或任务目标发生变化时,固定的交互结构会严重限制模型的适应性和协作效率.

推动GRL从静态图建模扩展至动态图结构感知与优化,已成为该领域发展的关键趋势[14-15]. 为了使模型适应现实世界中多智能体协作需求的动态演变,一系列新的GRL算法得到探索. 从早期的分布式深度Q学习到近年来的值分解方法,研究的演进体现了学界对多智能体系统中动态图交互结构的不断深化理解[16]. 此外,针对反向传播和目标导向多智能体通信策略的深度强化学习研究,进一步表明交互拓扑结构对系统性能具有显著的影响[17-18]. 据此,Singh等[19]提出个性化控制连续通信模型,学习何时在大规模多智能体合作和竞争任务中通信,以动态调整与优化交互结构. 研究焦点逐渐转向更具挑战性的核心问题:如何在任务执行过程中动态生成并持续优化交互图结构.

对抗生成技术的引入为解决这一难题提供了全新的突破口. 该技术的核心思想在于通过生成器与判别器之间的对抗博弈,不断提升生成结构或样本的质量,以实现对复杂交互关系的逼真建模[20]. 将这一机制应用于图结构生成,可以提升数据的有效性、稳定性和动态性[21],为多智能体系统中的实时拓扑优化奠定方法论基础. 本文提出新的基于图生成对抗的多智能体动态蒙特卡洛强化学习(multi-agent dynamic monte-carlo reinforcement learning based on adversarial graph generation, GGAN-MCRL)方法,以捕捉多智能体间节点与边的动态变化. 在生成器中,采用传统的启发式搜索方法(如深度优先搜索)选择动作时存在不确定性,这导致计算复杂度增大. 在GGAN-MCRL中,结合蒙特卡洛强化学习与图Softmax,使得邻近节点的影响随着节点距离的增加而逐步减弱,从而提升计算效率. 利用改进的上置信界(upper confidence bound, UCB)选择概率最高的动作,相较于盲目搜索更具优势,并能平衡探索与利用.

1. 基于改进的上置信界的对抗性多智能体图强化学习

在高动态性和大规模状态-动作空间的多智能体复杂环境中,如何学习多智能体之间的交互并动态生成或修改图结构数据是值得解决的重要问题. 提出基于改进的上置信界的生成对抗多智能体图强化学习算法,实时捕获随时间步实时更新的状态相关动态拓扑矩阵,从而提升多智能体在复杂高维状态环境中的学习能力,解决在复杂大规模环境中无法完全掌握状态空间以及动作选择的不确定性问题.

该算法将多智能体任务环境建模为基于生成对抗强化学习的图结构网络$ {\cal{G}}=\left(V,E\right) $,并在此基础上进行多智能体策略优化. 图结构网络中,每个节点代表一个智能体,节点特征为这些智能体观察到的状态. 智能体与其邻居之间通过边相连. 在该图结构网络$ \cal{G} $中,$ V=\left\{{v}_{1},{v}_{2},\cdots ,{v}_{W}\right\} $表示节点集,$ E=\left\{{e}_{ij}\right\}_{i,j=1}^{W} $表示边集. 其中$ {e}_{ij} $表示智能体$ i $与智能体$ j $之间的交互强度或可通信性,$ {e}_{ij}={{\mathrm{exp}}}\;{\left(-{\left|\left|{{\boldsymbol{s}}}_{i}-{{\boldsymbol{s}}}_{j}\right|\right|}/{\sigma }\right)} $, $ \left|\left|{{\boldsymbol{s}}}_{i}-{{\boldsymbol{s}}}_{j}\right|\right| $表示智能体状态差距(如空间距离或特征距离) ,$ \sigma $为尺度系数. 在每个时间步,若$ {e}_{ij} $超过阈值$ \tau $,则认为2个智能体之间存在边连接,否则视为不连接. 给定一个节点$ {v}_{c} $,${M}\left({v}_{c}\right) $表示与节点$ {v}_{c} $直接相邻的节点$ v $的集合(一阶邻居);$ {P}_{\mathrm{{da}}}\left(v|{v}_{c}\right) $表示网络中节点关于$ {v}_{c} $的真实条件分布,该分布刻画了节点$ {v}_{c} $的连接偏好.

为了实时获取动态图的拓扑结构及节点间的连接关系,提出图生成对抗蒙特卡洛强化学习算法. 该算法主要包含以下2个核心模型.

1)判别器$ D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $主要用于区分连接良好的节点对与连接不良的节点对(连接良好的节点对表示交互强或信息传递密切的智能体对,对应的边权值$ {e}_{ij} $较大;相反,连接不良的节点对表示交互弱或无直接信息传递的智能体对,$ {e}_{ij} $较小). $ D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $输出一个标量,表示节点$ v $与$ {v}_{c} $之间存在边的概率.

2)生成器$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的主要目标是尽可能拟合或预测智能体之间的真实连接分布概率$ {P}_{\mathrm{da}}\left(v|{v}_{c}\right) $,在节点集$ V $中选择最可能与$ {v}_{c} $连接的节点. 生成器旨在生成与真实相邻节点相似的节点,以欺骗判别器.

图生成对抗性蒙特卡洛强化学习中最小最大博弈的目标函数[22]为

$ \begin{split}&{\min }_{{{\theta }_{\mathrm{g}}}}{\max }_{{{\theta }_{\mathrm{d}}}}V\left(G,D\right)=\sum \limits_{c=1}^{W}\bigg[{{{{E}}}}_{v\sim {{P}_{\mathrm{da}}}\left(\cdot |{v}_{c}\right)}\ln D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\bigg.+\\& \qquad\qquad\bigg.{{E}}_{v\sim G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right)}\ln \left(1-D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\right)\bigg].\\[-5pt]\end{split} $

式中:$ V\left(G,D\right) $为最小最大博弈的值函数,$ {E}\left(\cdot \right) $为期望,$ D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $表示节点$ v $与节点$ {v}_{c} $之间存在边的可能性.

式(1)中参数的更新规则如下. (a) 对于$ {\theta }_{\mathrm{d}} $,判别器使真实样本的输出概率尽可能大,而生成样本的输出概率尽可能小,即使得$ 1-D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $尽可能大. (b)对于$ {\theta }_{\mathrm{g}} $,生成器努力生成与真实样本$ {v}_{c} $相似的样本,以最小化判别器识别出生成样本的概率. 具体到图结构层面,生成器旨在提高生成节点与$ {v}_{c} $存在边的概率,从而使得$ 1-D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $较小. 综合上述2个对抗目标,可得式(1)所示的最小最大博弈的目标函数.

生成器和判别器的参数通过交替训练持续更新. 在每次迭代中,判别器$ D $通过使用$ {P}_{\mathrm{da}}\left(v|{v}_{c}\right) $提供的样本和生成器$ G $生成的样本进行训练,而生成器$ G $通过$ D $的指导,按照梯度策略进行更新.

1.1. 判别器优化

在图生成对抗性蒙特卡洛强化学习中,给定由生成器生成的与节点$ {v}_{c} $相邻的节点以及实际与节点$ {v}_{c} $相邻的节点,判别器旨在最大化生成样本与真实样本的似然概率. 将判别器$ D $表示为2个节点的 sigmoid 函数,

$ D\left(v,{v}_{c}\right)=\sigma \left(\boldsymbol{h}_{v}^{{\mathrm{T}}}{\boldsymbol{h}}_{{{v}_{c}}}\right)=\frac{1}{1+{\mathrm{exp}}\;{(-{\boldsymbol{h}_{v}^{\mathrm{T}}}{{\boldsymbol{h}}_{{{v}_{c}}}}})}. $

式中:$ \boldsymbol{h}_{v}^{\mathrm{T}}、{\boldsymbol{h}}_{{{v}_{c}}}\in {\bf{R}}^{k} $分别为判别器中节点$ v $和$ {v}_{c} $的h维向量,该向量表示判别器中$ v $、$ {v}_{c} $更新后的节点状态. $ {\theta }_{{{\mathrm{d}}}} $是所有$ {\boldsymbol{h}}_{v} $的集合.

若判别器$ D $对$ {\theta }_{\mathrm{d}} $可微分,则最大似然概率可以通过随机梯度上升法求解. 由于式(1)仅涉及节点对$ \left(v,{v}_{c}\right) $,仅更新节点表示向量$ \boldsymbol{h}_{v}^{\mathrm{T}} $和$ {\boldsymbol{h}}_{{{v}_{c}}} $,求解给定节点对$ \left(v,{v}_{c}\right) $的最大似然概率:

$ {\nabla }_{{{\theta }_{\mathrm{d}}}}V\left(G,D\right)=\begin{cases} {\nabla }_{{{d}_{v}},{{d}_{{{v}_{c}}}}}\ln D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right),\;\;v\sim {P}_{\mathrm{da}};\\{\nabla }_{{{d}_{v}},{{d}_{{{v}_{c}}}}}\left(1-\ln D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\right),\;\;v\sim G.\end{cases} $

1.2. 基于蒙特卡洛强化学习的生成器优化

根据最小最大博弈的目标函数,生成器旨在最小化判别器对生成节点与真实节点的区分能力. 生成器对$ {\theta }_{\mathrm{g}} $的梯度可以通过梯度下降法进行优化与更新,具体步骤如下.

$ \begin{split} {\nabla }_{{{\theta }_{\mathrm{g}}}}V\left(G,D\right)=&\;{\nabla }_{{{\theta }_{\mathrm{g}}}}\sum \limits_{c=1}^{W}{{E}}_{v\sim G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right)}\ln \left(1-D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\right)=\\&\sum \limits_{c=1}^{W}{{E}}_{v\sim G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right)}\left[{\nabla }_{{{\theta }_{\mathrm{g}}}}\ln G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right)\times \right.\\&     \left.\ln \left(1-D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\right)\right].\\[-4pt]\end{split} $

式中:梯度$ {\nabla }_{{{\theta }_{\mathrm{g}}}}V\left(G,D\right) $为对梯度$ {\nabla }_{{{\theta }_{\mathrm{g}}}}\ln G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $权重求和的结果,该梯度权重利用似然概率$ \ln \left(1-D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right)\right) $计算获得. 若判别器将生成的节点识别为负样本节点(生成节点),则$ D\left(v,{v}_{c};{\theta }_{\mathrm{d}}\right) $将很小,而生成节点梯度的对应权重将很大,这会增加计算复杂度.

分析生成对抗蒙特卡洛图强化学习中生成器的实现. 生成器模型中节点之间的预测连接分布可以通过softmax函数实现[19]. 传统 softmax 函数需要对图中所有节点进行归一化计算,因此面临较高的计算开销. 此外,由于其固有的归一化特性及对各个节点的均等处理机制,softmax 难以捕捉图拓扑结构中蕴含的丰富节点与边信息. 分层 softmax 虽能在一定程度上解决计算复杂度问题,但会损失图的结构信息. Singh等[19]转而使用广度优先搜索(breadth first search, BFS)更新在线策略以实现解空间的全面搜索. 但BFS需要访问大量节点,使得生成器的学习速度变慢,存储开销也更大.

为了考虑图结构中节点和边的信息并提高算法的计算效率,将蒙特卡洛方法引入到生成器中,用于计算连接度分布$ G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right) $. 该分布的计算通过树搜索并采用改进的UCB进行,以优化动作选择机制. 基于原始图网络$ \mathcal{G} $进行蒙特卡洛树搜索,展开得到以$ {v}_{c} $为根节点的蒙特卡洛强化学习树$ {T}_{c} $. 给定一个节点$ v $及其邻居$ {v}_{i}\in {{M}}_{c}\left(v\right) $,节点$ v $与节点$ {v}_{i} $之间边连接的概率为

$ {P}_{c}\left({v}_{i}|v\right)=\frac{{\mathrm{exp}}\;{({\boldsymbol{g}_{{v}_{i}}^{\mathrm{T}}}{{\boldsymbol{g}}_{v}}})}{ \displaystyle {\sum }_{{{v}_{j}}\neq {{{M}}_{c}}\left(v\right)}{\mathrm{exp}}\;{({\boldsymbol{g}_{{v}_{{{}_{j}}}}^{\mathrm{T}}}{{\boldsymbol{g}}_{v}}})}. $

式中:$ {\boldsymbol{g}}_{{{v}_{i}}}、{\boldsymbol{g}}_{v}\in {\bf{R}}^{k} $为生成器中节点$ {v}_{i} $和节点$ v $的$ k $维向量,该向量表示节点$ {v}_{i} $和$ v $的嵌入表示. $ {\theta }_{\mathrm{g}} $是所有$ {\boldsymbol{g}}_{{{v}_{i}}} $的集合. 式(5)是生成器中$ {{M}}_{c}\left(v\right) $上的softmax函数. 在蒙特卡洛方法的学习过程中,每个节点可以通过路径$ {\mathrm{pat{h}}}_{{{v}_{c}}\rightarrow v}=\left({v}_{{{r}_{0}}},{v}_{{{r}_{1}}},\cdots ,{v}_{{{r}_{m}}}\right) $,其中$ {v}_{{{r}_{0}}}={v}_{c} $且$ {v}_{{{r}_{m}}}=v $. 使用图softmax的预测连接分布$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $为

$ G\left(v|{v}_{c}\right)=\left(\prod \limits_{j=1}^{m}{P}_{c}\left({v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}}\right)\right)\cdot {P}_{c}\left({v}_{{{r}_{m-1}}}|{v}_{{{r}_{m}}}\right). $

式中:$ m $为路径$ {\mathrm{pat{h}}}_{{{v}_{c}}\rightarrow v} $的长度.

在生成器模型使用蒙特卡洛扩展树搜索的过程中,图模型被扩展为一棵树,节点之间的连接概率沿路径连续相乘,使得节点之间的连接概率随着节点间最短距离的增加而减小,从而确保距离当前节点更远的邻居对该节点的影响较小. 具体的树搜索主要包括以下步骤.

1)初始化决策树,将当前节点设为根节点,并从根节点开始以初始探索概率进行探索.

2)采用探索策略,从当前节点的所有子节点中选择最值得探索的节点. 一般的探索策略是优先选择未探索的子节点. 若所有子节点均已被探索,则选择改进的UCB值最大的子节点,这可使决策树向最优方向扩展,避免盲目搜索,提高计算效率. 利用下式计算多个智能体的改进UCB分数:

$ \mathrm{scores}\left({a}_{i}\right)={Q}_{i}\left(s,{a}_{i}\right)+\rho \cdot \sqrt{\frac{{U}_{\mathrm{jo}i}\left(s,a\right)}{{N}_{i}\left({a}_{i}\right)+1}}+\lambda \cdot {C}_{{i}}\left(s,a\right). $

式中:${Q}_{i}\left(s,{a}_{i}\right) $为状态-动作值,

其中$ \gamma $为折扣因子,可以通过衰减远期回报来缓解延迟回报所导致的估值偏差;$ \rho \sqrt{{{U}_{\mathrm{jo}i}\left(s,a\right)}/({{N}_{i}\left({a}_{{i}}\right)+1})} $为协作探索项,其中$ \rho $为探索系数,$ {N}_{i}\left({a}_{i}\right) $为智能体$ i $选择动作$ {a}_{i} $的次数,$ {U}_{\mathrm{joi}}\left(s,a\right) $为全局不确定度;$ {C}_{i}\left(s,a\right)={Q}_{\mathrm{te}}\left(s,a\right)- {Q}_{\mathrm{te}}\left(s\left(\;{a}_{-i},{\overline{a}}_{i}\right)\right) $,其中 $ {a}_{-i} $为其他智能体的动作组合,$ {\overline{a}}_{i} $为智能体$ i $的默认动作,$ {\overline{a}}_{i}= \left.{\displaystyle {\sum }_{a\in {{\tilde {{A}}}_{i}}}a} \right/{\left| {\tilde {{A}}}_{i}\right| }$,$ {Q}_{\mathrm{te}} $为团队的Q值;$ \lambda {C}_{i}\left(s,a\right) $为信用分配项,为那些Q值不高但对整体至关重要的动作提供额外关注,其中$ \lambda $为权重系数,以调整$ {C}_{i}\left(s,a\right) $的影响. 式(6)中的探索项和信用分配项协同工作,可以应对策略局部最优问题. 全局不确定性为

式中:$ {w }_{1}、 {w}_{2} $为权重系数,${\mathrm{ Var}}\left(R\right) $为团队奖励方差,${\mathrm{ Var}}\left({V}_{\mathrm{te}}\right) $为通过生成器预测得到的下一个状态$ {s}_{t+1} $的团队值方差. 该联合项$ {U}_{\mathrm{joi}}\left(s,a\right) $结合了所有智能体的状态-动作组合,使得各智能体的$ {Q}_{i}\left(s,{a}_{i}\right) $能够通过共享全局信息间接捕获延迟效应. 该算法可以通过折扣因子$ \gamma $与联合项$ {U}_{\mathrm{joi}}\left(s,a\right) $,解决多智能体回报滞后问题.

若节点未被扩展,则将其扩展为新的子节点.

3)从新节点开始,通过蒙特卡洛采样生成一条完整路径,计算路径的返回值,并将路径的返回值存储在所有节点中.

4)将路径返回值传递回所有的相关节点,并更新节点值和参数,以便后续计算改进的UCB值.

5)重复节点选择、模拟路径和返回值的计算,直至满足停止条件. 通过上述步骤的循环迭代,能够高效地探索和利用策略空间,逐步接近最优策略.

算法1 基于蒙特卡洛强化学习的在线策略生成
输入:环境$ E $、动作$ a $、状态$ s $、节点$ {v}_{c} $、步数$ T $
输出:最优策略$ {a}_{\mathrm{opt}} $
初始化:创建状态$ {s}_{0} $的根节点$ {v}_{0} $
1:for $ t=0,1,\cdots ,T-1 $do
2: while当前节点$ {v}_{c} $未达到最优do
3:  若$ {v}_{c} $未完全展开,则扩展$ {v}_{c} $
4:  否则利用式(6)选择最优子节点$ {v}_{c} $
5: end while
6: 更新当前节点$ {v}_{t}\leftarrow {v}_{c} $
7: 执行选择的动作$ a\in A\left(s\right) $获得新状态$ s' $
8:end for
9:返回最优策略节点$ {v}_{c} $及对应动作$ {a}_{\mathrm{opt}} $

通过连续模拟获得大多数节点的改进UCB值,根据改进的UCB值在下次模拟中选择值得利用或探索的节点以继续模拟. 在搜索空间巨大且计算资源有限的情况下,这种基于蒙特卡洛的强化学习算法将图结构扩展为树结构. 基于假设1,节点之间的连接概率会随着最短路径长度的增加而降低,这是由于路径上概率的连续乘积随长度增加而减小所导致的. 该机制有助于在局部邻域内更密集地探索优质节点,以提升被选择概率. 提出的GGAN-MCRL中生成器的伪代码在算法1中给出. 算法1输出的最优节点$ {v}_{c} $将作为生成器$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的输入,用于算法2的对抗训练.

假设1 假设预测的连接分布满足$ \displaystyle {\sum }_{v\neq {{v}_{c}}} G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right)= 1 $和 $ 0 \lt G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right) \lt 1.0 $.

定理1(标准化) 对于生成器$ G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right) $的节点,预测连接分布满足$ \displaystyle {\sum }_{v\neq {{v}_{c}}}G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right)=1 $.

证明:为了证明定理1,将访问路径$ {T}_{c}\left(v\neq {v}_{c}\right) $中位于节点$ v $的子访问路径表示为${\mathrm{ S{T}}}_{v} $,可得$ \displaystyle {\sum }_{{{v}_{i}}\in S{{T}_{v}}} G\left({v}_{i}|{v}_{c}\right) = \displaystyle \prod \limits_{j=1}^{m}{P}_{c}\left( {v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}} \right) $,其中$ \left( {v}_{{{r}_{0}}},{v}_{{{r}_{1}}},{v}_{{{r}_{2}}},\cdots {v}_{{{r}_{m}}} \right) $是路径$ {\mathrm{pat{h}}}_{{{v}_{c}}\rightarrow v} $,$ {v}_{{{r}_{0}}}={v}_{c} $,$ {v}_{{{r}_{m}}}=v $. 对于子访问路径$ {\mathrm{S{T}}}_{v} $上的每个节点$ v $,可得$ \displaystyle {\sum }_{{{v}_{i}}\in {\mathrm{S}}{{{\mathrm{T}}}_{v}}}G\left({v}_{i}|{v}_{c};{\theta }_{\mathrm{g}}\right)= \displaystyle \prod\nolimits _{j=1}^{m}{P}_{c}\left({v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}}\right) $. 访问路径的最后一步满足节点只有一个邻居,即$ {P}_{c}\left({v}_{{{r}_{m-1}}}|{v}_{{{r}_{m}}}\right)={P}_{c}\left({v}_{{{r}_{m-1}}}|v\right)=1 $.

对于每个智能体的节点$ v $, $ {\mathcal{C}}_{c}\left(v\right) $表示$ {T}_{c} $中$ {v}_{c} $的访问路径节点集. 假设每个子节点$ {v}_{k}\in {\mathcal{C}}_{c}\left(v\right) $满足式(5),可得

$ \begin{split}& {\sum }_{{{v}_{i}}\in {\mathrm{S}}{{\mathrm{{T}}}_{v}}}G\left({v}_{i}|{v}_{c}\right)=\\&\left(\prod \nolimits_{j=1}^{m}{P}_{c}\left({v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}}\right)\right)\cdot {P}_{\mathrm{con}}\left({v}_{{{r}_{m-1}}}|{v}_{{{r}_{m}}}\right)+\\&{\sum }_{{{v}_{k}}\in {{\mathcal{C}}_{c}}\left(v\right)}\left(\left(\prod \nolimits_{j=1}^{m}{P}_{c}\left({v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}}\right)\right){P}_{c}\left({v}_{k}|{v}_{{{r}_{m}}}\right)\right)=\\&\prod \nolimits_{j=1}^{m}{P}_{c}\left({v}_{{{r}_{j}}}|{v}_{{{r}_{j-1}}}\right).\end{split} $

将式(7)应用于节点$ {v}_{c} $的所有子节点,可得

定理2(图结构化信息) 生成器利用图的结构信息来近似图的连接分布. 对于节点$ {v}_{c} $,该节点与相邻节点的连接分布$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $随着$ v $和$ {v}_{c} $之间最短距离的增加而指数级减小.

证明:对于式(4)、(5), $ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $是$ m$个节点之间的连接概率的乘积. 其中,$ m $为路径$ {\mathrm{pat}}{{\mathrm{h}}}_{{{v}_{c}}\rightarrow v} $的长度,即为图$ \mathcal{G} $中$ v $和$ {v}_{c} $之间的最短距离. 由于蒙特卡洛树搜索维持了从$ {v}_{c} $到图中所有其他顶点的最短路径距离,连接分布$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $与图$ \mathcal{G} $中节点$ v $和节点$ {v}_{c} $之间最短距离的倒数呈指数正比关系.

定理2为搜索过程提供了结构性先验,在拓扑结构上更近邻的区域内进行深度探索,避免了该算法在整个图中完全盲目地搜索,实现了对搜索过程的高效引导,提高了计算效率.

定理3(计算效率) 在图softmax中,$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的计算效率取决于图$ \mathcal{G} $中节点的平均度$ d $和节点个数$ W $.

证明:基于式(4)、(5),根据定理2和假设1的分析可知,连接分布满足$ 0 \lt G\left(\cdot |{v}_{c};{\theta }_{\mathrm{g}}\right) \lt 1 $,且$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $与图$ \mathcal{G} $中节点$ v $和节点$ {v}_{c} $之间最短距离的倒数呈指数正比关系. $ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的计算与路径$ {\mathrm{pat{h}}}_{{{v}_{c}}\rightarrow v} $上的节点和与路径直接相连的节点相关. 一般路径的最大长度(即蒙特卡洛搜索树的深度)为$ \ln W $,且路径中的每个节点平均与$ d $个节点连接. $ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的计算与$ d $和$ W $相关,且计算所用的节点只覆盖图结构中与该节点关系更密切的点,从而减少计算量.

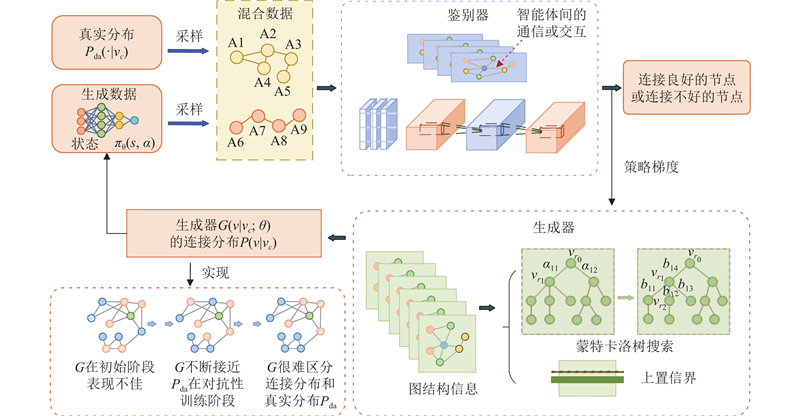
整个生成对抗蒙特卡洛图强化学习算法的框架如图1所示. GGAN-MCRL利用基于蒙特卡洛树搜索的生成器,尽可能准确地推算出实际连接分布的概率,并找出与$ {v}_{c} $相连的最优节点. 该算法使用生成器对正确分布的数据和生成的数据进行采样,形成多个智能体的混合数据. 基于sigmoid函数的判别器用于区分连接良好的节点和连接不良的节点. 在生成器和判别器的训练过程中,生成器试图生成与节点$ {v}_{c} $的真实邻居节点相似的节点,使生成器$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $的连接分布$ P\left(v|{v}_{c}\right) $与$ {v}_{c} $的真实情况相符. 判别器试图确定哪些节点是$ {v}_{c} $的真实邻居,哪些节点是由生成器生成的. 生成器和判别器达到平衡,获得多个智能体的最优策略. 生成对抗蒙特卡洛图强化学习的伪代码如算法2所示. 算法2是提出算法的整体框架,其中生成器的策略优化过程由算法1提供.

图 1

图 1   图生成对抗蒙特卡洛强化学习的框架

Fig.1   Framework of graph generative adversarial Monte-Carlo reinforcement learning


算法2 基于图生成对抗结构的蒙特卡洛强化学习
输入:图结构网络$ \mathcal{G}=\left(V,E\right) $(其中边的定义依据智能体状态差异$ \left|\left|{s}_{i}-{s}_{j}\right|\right| $与阈值$ \tau $),生成样本大小为$ {\kappa }_{\mathrm{g}} $,判别样本大小为$ {\kappa }_{\mathrm{d}} $,初始参数为$ {\theta }_{\mathrm{g}} $和$ {\theta }_{\mathrm{d}} $
输出:生成器$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $,判别器$ D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $
1:初始化并预训练$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $和$ D\left(v, {v}_{c};{\theta }_{\mathrm{d}}\right) $
2:构建所有节点$ {v}_{c}\in V $的蒙特卡洛强化学习树$ {T}_{c} $
3:repeat
4: for $ D $-steps do
5: 对于每个节点$ {v}_{c} $,从专家演示中采样$ {\kappa }_{\mathrm{d}} $个正节点
6: 从$ G\left(v|{v}_{c};{\theta }_{\mathrm{g}}\right) $中采样$ {\kappa }_{\mathrm{d}} $个负节点
7: 利用式(1)更新$ {\theta }_{\mathrm{d}} $
8: end for
9: for $ G $-steps do
10: 根据判别器反馈与奖励估计,采用算法1为每个节点$ {v}_{c} $生成邻居节点
11: 利用式(3)更新$ {\theta }_{\mathrm{g}} $
12: end for
13:until GGAN-MCRL收敛

2. 实验和仿真分析

为了验证所提算法的性能,选择不同复杂度的多智能体环境进行实验. 在这些实验环境中,对与环境和训练密切相关的超参数(学习率、折扣因子)进行微调,以适应各自的任务规模和复杂度. 算法的核心架构与机制在所有环境中保持一致.

2.1. 多智能体grid world环境

为了评估所提算法的性能,使用多智能体grid world环境. 在该环境中,设置6个智能体,试图通过4个动作(“上”、“下”、“左”和“右”)协调行动,以高效导航至目标位置,同时避免与其他智能体发生碰撞. 奖励的具体设计规则如下. 1)对于接近目标的行为,给予的奖励定义为目标与智能体在新状态下的曼哈顿距离的负值. 2)碰撞的惩罚为接近目标奖励的0.5倍. 在该多智能体环境中,根据智能体间的欧式距离判断两者是否存在边连接.

在该环境中,将提出的GGAN-MCRL与多智能体演员-评论(multi-agent actor critic, MAC-RL)算法[15]以及多智能体共识演员-评论(multi-agent consensus actor-critic, MCAC-RL)算法[23]进行比较. 在该实验环境中,参数设置如下:轨迹长度为35,演员的学习率为0.002,评论家和团队奖励的学习率为0.005,折扣因子$ \gamma $为0.95,固定策略下的回合数Ne为1 000,智能体的动作空间大小为5,每个回合的步数为500. 该环境的参数设置简单,旨在重点测试算法在紧凑空间下的实时合作与竞争能力.

如图2所示,在整个训练过程中,多智能体间的通信拓扑从初始的均衡链状结构逐渐演化,呈现出明显的中心化趋势:智能体1、2和4在多个训练阶段持续保持较高的连接度,成为承担信息中转的关键中心节点;智能体3和5相对边缘化,连接数量明显减少,最终形成以智能体0、1、2、4为核心的紧密社区和以智能体3、5为主的边缘群体. 这种节点角色的分化反映了系统基于学习经验的自主优化——中心节点承担了大部分信息协调任务,边缘节点专注于局部决策,从而实现通信效率与团队协作的平衡.

图 2
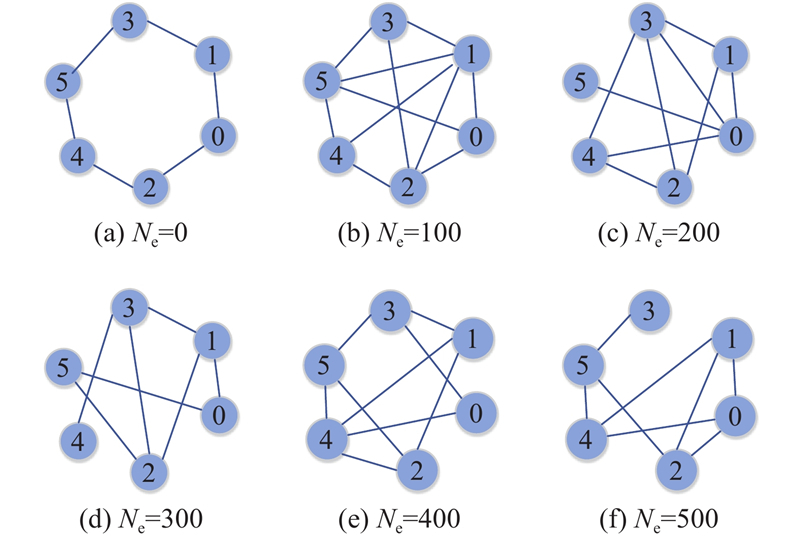
图 2   学习过程中的节点连接变化图

Fig.2   Graph of node connection change during learning process


MAC-RL、MCAC-RL、GGAN-MCRL的Q值及奖励差异rd分别如图3(a)、(b)所示. 由于MAC-RL和MCAC-RL算法不能很好地掌握多智能体间的动态矩阵变化,这2种算法的性能都略差. 从图3(a)可以看出,与MAC-RL和MCAC-RL相比,GGAN-MCRL得到的Q值收敛速度更快,获得的Q值更高. 为了进一步验证所提算法的性能,使用多智能体的预测奖励与实际奖励之间的差异来衡量算法的性能. 图3(b)表明,与MAC-RL和MCAC-RL相比,GGAN-MCRL能够获得更小的差异. GGAN-MCRL可以利用生成对抗图网络来捕捉动态图矩阵. GGAN-MCRL的性能优于MAC-RL和MCAC-RL.

图 3
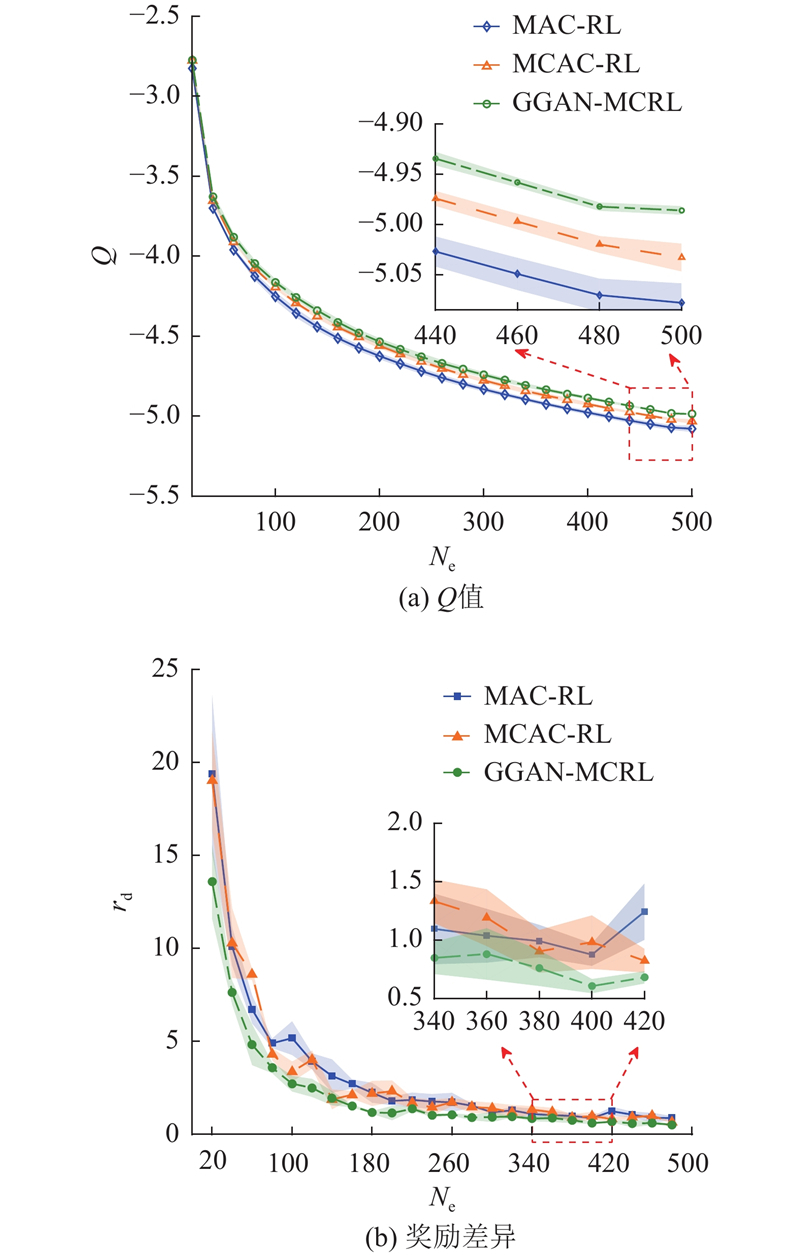
图 3   MAC-RL、MCAC-RL和GGAN-MCRL的Q值和奖励差异

Fig.3   Q value and difference of reward for MAC-RL, MCAC-RL and GGAN-MCRL


如表1所示为周期性奖励、平均回报及周期性回报的结果. 周期性奖励是指每个周期内的奖励,周期性回报是指每个周期内的折扣累积奖励,平均回报是折扣累积奖励的平均值. 表1中,GGAN-MCRL的周期性奖励和平均回报均高于MAC-RL和MCAC-RL. 由于算法的随机性以及缺乏固定的随机种子,GGAN-MCRL的周期性奖励为−0.042,这并非最优值. 该值的方差最小且相对较小. 综合考虑周期性奖励和平均回报的结果可知,与MAC-RL和MCAC-RL相比,提出的GGAN-MCRL表现更优.

表 1   MAC-RL、MCAC-RL和GGAN-MCRL的奖励和回报

Tab.1  Reward and return of MAC-RL, MCAC-RL and GGAN-MCRL

算法周期性奖励平均回报周期性回报
MAC-RL−7.533 ± 0.733−2.915 ± 0.360−0.080 ± 0.139
MCAC-RL−6.242 ± 0.015−2.693 ± 0.329−0.022 ± 0.202
GGAN-MCRL −5.042 ± 0.792 −2.121 ± 0.234 −0.042 ± 0.103

新窗口打开| 下载CSV


2.2. Citation网络的多智能体环境

为了进一步验证提出的算法能否理解并利用智能体间的抽象关系,该实验采用复杂的Citation网络来模拟学术合作的多智能体环境,其中智能体代表学者,通过引文和合著来相互联系. 在该实验中,使用一系列真实数据集来评估提出的GGAN-MCRL 算法的性能. 采用该算法,能够生成新的研究论文及其引文关系,分析所有节点间的联系.

将GGAN-MCRL与基于时空图注意力的生成对抗网络模型(generative adversarial nets model based on a spatio-temporal graph attention network, GAT-GAN)、基于图神经网络的对抗性多智能体强化学习(structural adversarial network based on graph neural networks, GGAN-DQN)和离散GAN强化学习(discrete GAN reinforcement learning, GAN-RL)进行比较. GAT-GAN将GAN的原理与图数据结构相结合,利用GAN学习时空数据的分布,通过对抗的方式生成逼真的数据[22]. GGAN-DQN建立基于GNN的虚假鉴别器的对抗攻击框架,使用深度Q学习来寻找最大化奖励的最优策略[21]. GAN-RL利用RL来约束离散GAN模型的生成性能,提高训练稳定性[24].

从arXiv网站获取arXiv-GrQc 数据集,该数据集涵盖提交至广义相对论和量子宇宙学类别论文的作者之间的科学合作情况. 该图网络结构共有14 496条边和5 242个节点. 为了检验算法在大规模群体中的可扩展性,该实验中生成器和判别器的l2损失调节权重设定为1×10⁻⁵. 在本次实验中,采用惩罚机制来引导智能体避免低效行为. 相关性越低的参考文献,受到的惩罚越大. 为了更清晰地分析所得的数据,实验的结果取绝对值. 数据越小,说明算法性能越好.

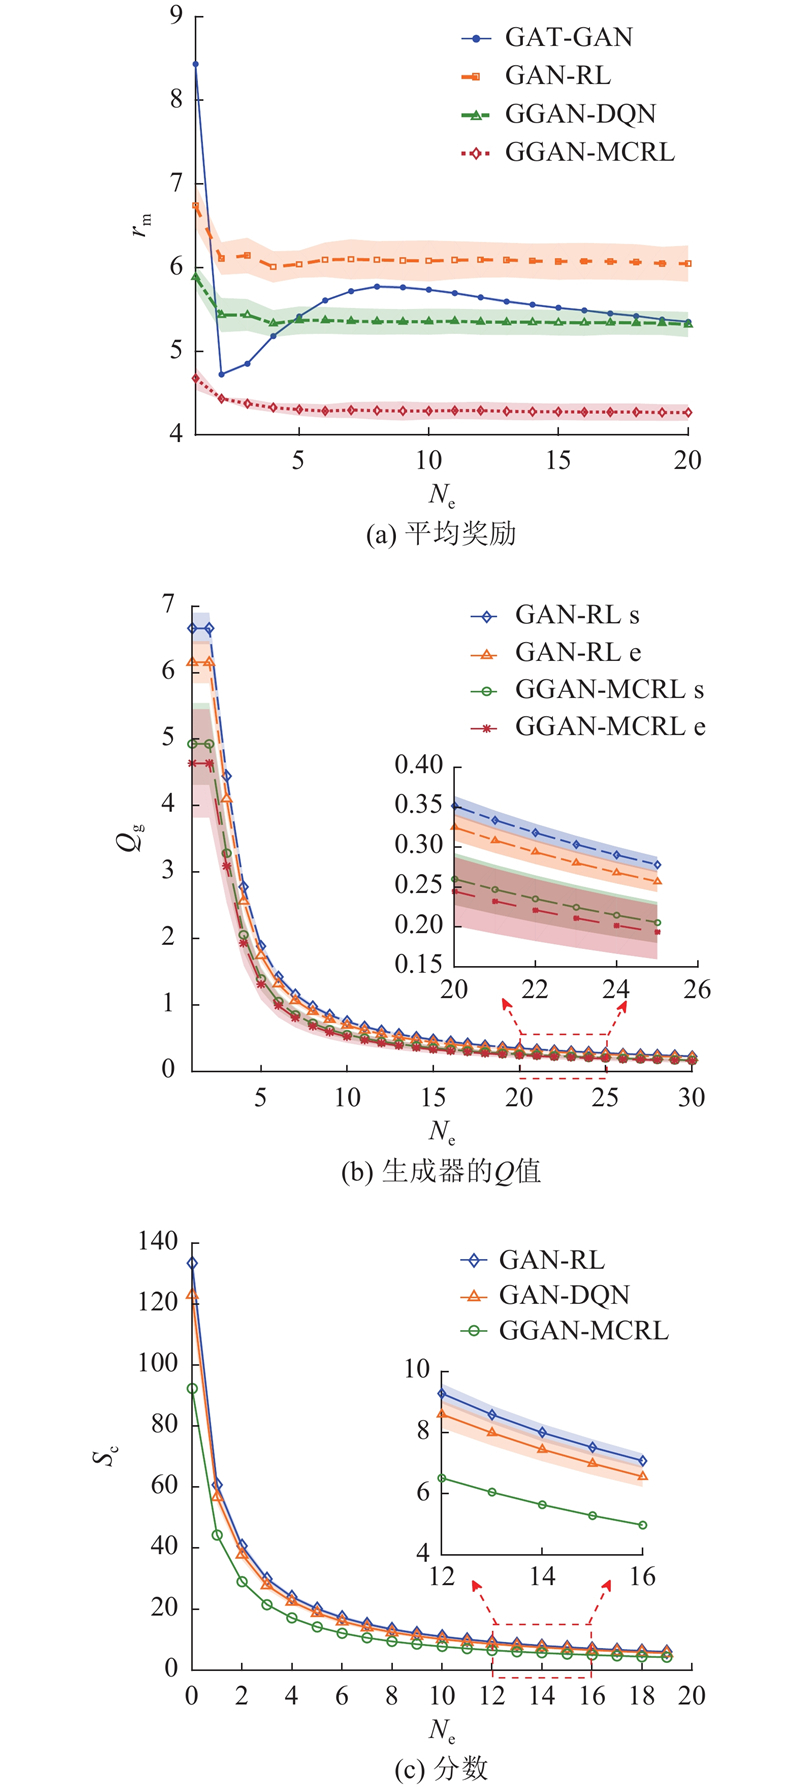
为了展示所提算法的性能,将GGAN-MCRL与GAT-GAN、GGAN-DQN、GAN-RL进行比较. GAT-GAN、GAN-RL、GGAN-DQN和GGAN-MCRL的平均奖励rm的情况如图4(a)所示. 从图4(a)可知,GAT-GAN、GAN-RL和GGAN-DQN的奖励更高. 因为GGAN-MCRL能够利用蒙特卡洛强化学习方法减少对相邻节点的影响,该影响随着距离增加而减小. 选择改进的UCB策略的叶节点,避免盲目搜索,减少计算量. GGAN-MCRL的平均奖励最低.

图 4

图 4   GAT-GAN、GAN-RL、GGAN-DQN、GGAN-MCRL的平均奖励、生成器的Q值、分数

Fig.4   Mean reward, Q value of generator, and scores for GAT-GAN, GAN-RL, GGAN-DQN, GGAN-MCRL


在算法的训练过程中,获得的GGAN-MCRL和GAN-RL生成器的Q值函数Qg如图4(b)所示. GGAN-MCRL s和GAN-RL s是Q值函数在初始阶段的值,GGAN-MCRL e和GAN-RL e是Q值函数在结束阶段的值. 从图4(b)可以看出,与GAN-RL相比,GGAN-MCRL在初始阶段和结束阶段的Q值更低且收敛更快. GGAN-MCRL 算法在整个训练过程中表现得更好.

为了说明提出算法的性能,获取的GAN-RL、GGAN-DQN和GGAN-MCRL的分数Sc如图4(c)所示. 结果显示,与GGAN-MCRL和GGAN-DQN相比,GAN-RL的分数最高. 因为GGAN-MCRL能够使用蒙特卡洛强化学习来生成新的连接关系,随着距离的增加,当前节点的邻居对该节点的影响会减小. GGAN-MCRL的得分最低,与其他算法相比收敛得更快.

在训练结束后,GAN-RL、GGAN-DQN和GGAN-MCRL的判别器的奖励rod如图5(a)所示. GGAN-MCRL的判别器奖励值为0.211,在所有方法中最小. GAT-GAN、GAN-RL、GGAN-DQN、GGAN-MCRL (无UCB)和GGAN-MCRL (有UCB)的运行时间t如图5(b)所示. GAT-GAN、GAN-RL、GGAN-DQN、GGAN-MCRL (无UCB)和GGAN-MCRL (有UCB)的运行时间分别为20 823.4、20 627.8、20 133.3、19 834.3和19 627.2 s. 根据定理2和定理3可知,GGAN-MCRL(有UCB)通过使用图 softmax和改进的UCB策略来提高性能. 这不仅减少了计算量,而且选择了概率最大的动作,提高了计算效率. 与其他方法相比,GGAN-MCRL(有UCB)算法的运行时间最短.

图 5
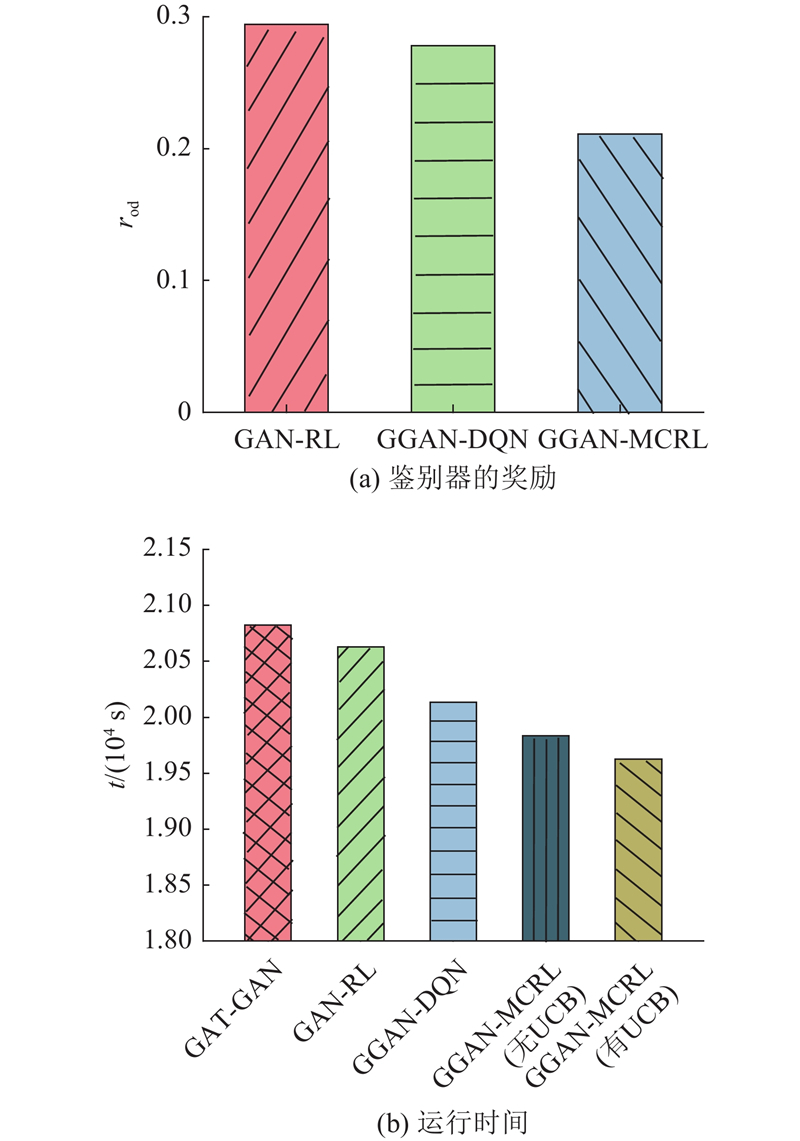
图 5   奖励和运行时间

Fig.5   Reward and running time


2.3. 多智能体车辆的驾驶环境

为了进一步评估所提算法的性能,选取多智能体highway-fast-v0、merge-v0和roundabount-v0等环境开展驾驶实验. 在多智能体highway-fast-v0环境中,每个自动驾驶车辆的目标是高速行驶、避免碰撞和靠右行驶. 该环境的默认设置是四车道高速公路,并为每个自动驾驶车辆生成50辆其他车辆. 观察内容包括车辆的位置、速度、转向角度等动态信息. 自动驾驶车辆的动作包括:保持当前状态、变更车道至左侧、变更车道至右侧以及加速、减速. 奖励函数综合考虑了速度奖励、车道位置奖励及碰撞惩罚. 采用类似的环境配置,在多智能体merge-v0环境中,自动驾驶车辆能够安全且高效地融入主干道的交通流中. 在多智能体roundabount-v0环境中,车辆能够安全且高效地融入没有交通信号灯的环形岛内的交通流中,并避免碰撞.

在多智能体车辆的驾驶环境中,每个节点代表一辆车,节点特征为车辆的动态状态(位置、速度、加速度等). 当两辆车的纵向距离小于安全阈值$ {m}_{\mathrm{{rs}}} $,且横向距离小于$ {m}_{\mathrm{{rl}}} $时建立连接,用于建模换道或跟车行为. 该环境的运行参数如下:总时间步数为20 000,缓冲区大小为$ 1.0\times {10}^{6} $,折扣因子$ \gamma $为0.99,速度范围为$ \left[10,25\right] $,预训练的时间步长为500,车辆数量为50,加速度为[−3.5, 3.5],高速奖励为0.5,非道路奖励为0.1,碰撞奖励为−1.

在highway-fast-v0、merge-v0和roundabount-v0中,为了验证GGAN-MCRL的性能,将其与多智能体深度Q学习(MA-DQN)[3]和GGAN-DQN[6]进行比较. 损失los、策略梯度损失ls、Q值差异Qd、Q值、周期性回报Rc和成功率Psuc的结果如表2所示. 与MA-DQN和GGAN-DQN相比,GGAN-MCRL能够提高计算效率,优化策略选择. GGAN-MCRL的损失、策略梯度损失和值差异的绝对值更小,Q值、周期性回报和成功率更大. 表2的结果表明,与GGAN-DQN和MA-DQN相比,GGAN-MCRL表现更优.

表 2   GGAN-DQN、GGAN-MCRL、MA-DQN在多智能体驾驶环境中的结果

Tab.2  Result of GGAN-DQN, GGAN-MCRL and MA-DQN in multi-agent driving environments

环境算法loslsQdQRcPsuc
highway-
fast-v0
MA-DQN0.934—−1.0223.7827.2370.86
GGAN-DQN1.005−2.5560.84674.74815.1190.82
GGAN-MCRL0.490−2.5070.33224.34415.8550.97
merge-v0MA-DQN0.214—−2.0183.1368.9700.64
GGAN-DQN1.398−5.1001.0792.69134.3170.60
GGAN-MCRL0.423−2.4300.30124.41242.2400.98
roundabount-v0MA-DQN0.114—−0.7514.7779.8530.84
GGAN-DQN2.627−4.7331.3565.04526.5550.73
GGAN-MCRL0.347−2.2910.24123.11434.2530.98

新窗口打开| 下载CSV


在highway-fast-v0中,分别设置智能体的数量W为40、50、60、70,以验证GGAN-DQN的拓展性. 在不同数量的车辆驾驶环境中,将GGAN-MCRL与GGAN-DQN、MA-DQN进行对比,获得的Q、los、时间步数ts如图6(a)~(c)所示. 图6(a)、(b)表明,当智能体数量从40增加到70时,与GGAN-DQN相比,GGAN-MCRL具有更高的Q值和更低的损失,且Q值和损失的变化幅度更小. 这表明GGAN-MCRL能够更有效地在更大规模的群体中学习和维持有效的协作策略. 图6(c)表明,随着智能体数量的增加,GGAN-DQN和GGAN-MCRL的训练时间步数都会增加. 与GGAN-DQN相比,GGAN-MCRL具有更小的ts,且ts的增长曲线更平缓. 这说明在面对多智能体数量变化的情况时,GGAN-MCRL比GGAN-DQN具有更高的计算效率和可拓展性.

图 6
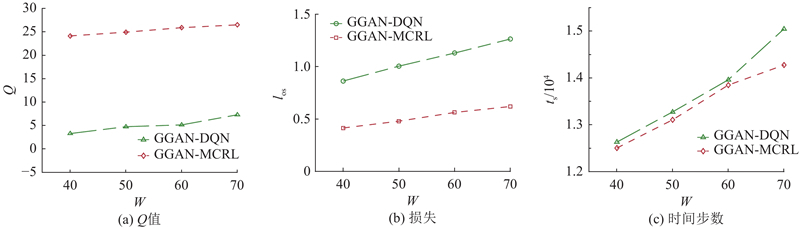
图 6   Highway-fast-v0中的Q值、损失函数、时间步数

Fig.6   Q value, loss and time step in highway-fast-v0


3. 结 语

提出的GGAN-MCRL新方法旨在实现MARL的策略优化. 该方法能够结合GGAN和蒙特卡洛方法,增强生成相邻节点的能力,并区分连接良好和连接不良的边. 通过引入改进的UCB和图softmax,提升了计算效率. 实验证明,该方法在复杂高动态环境中的性能明显优于传统的强化学习算法.

在该方法中,很难明确解释所生成图结构的拓扑生成逻辑. 未来可以考虑引入因果关系分析,提升该方法的可解释性.

参考文献

李大字, 刘子博, 包琰洋, 等

图强化学习算法及其在工业领域的应用研究综述

[J]. 国防科技大学学报, 2025, 47 (4): 76- 90

DOI:10.11887/j.issn.1001-2486.24120028      [本文引用: 1]

Li Dazi, Liu Zibo, Bao Yanyang, et al

Research review of graph reinforcement learning algorithms and their applications in the industrial field

[J]. Journal of National University of Defense Technology, 2025, 47 (4): 76- 90

DOI:10.11887/j.issn.1001-2486.24120028      [本文引用: 1]

李岳珩, 谢广明

集中训练分布执行下的多智能体强化学习综述

[J]. 控制理论与应用, 2025, 42 (11): 2114- 2124

DOI:10.7641/CTA.2025.50009     

Li Yueheng, Xie Guangming

Review of multi-agent reinforcement learning under centralized training with decentralized execution

[J]. Control Theory and Applications, 2025, 42 (11): 2114- 2124

DOI:10.7641/CTA.2025.50009     

Peng H, Shen X

Multi-agent reinforcement learning based resource management in MEC- and UAV-assisted vehicular networks

[J]. IEEE Journal on Selected Areas in Communications, 2021, 39 (1): 131- 141

DOI:10.1109/JSAC.2020.3036962      [本文引用: 1]

Yu T, Wang X, Hu J, et al

Multi-agent proximal policy optimization-based dynamic client selection for federated AI in 6G-oriented Internet of vehicles

[J]. IEEE Transactions on Vehicular Technology, 2021, 73 (9): 13611- 13624

DOI:10.1109/tvt.2024.3383860      [本文引用: 1]

Ding S, Du W, Ding L, et al

Multiagent reinforcement learning with graphical mutual information maximization

[J]. IEEE Transactions on Neural Networks and Learning Systems, 2025, 36 (11): 19515- 19524

DOI:10.1109/TNNLS.2023.3243557      [本文引用: 1]

Goeckner A, Sui Y Y, Martinet N, et al. Graph neural network-based reinforcement learning for multi-agent systems [C]// 36th Conference on Neural Information Processing Systems. New Orleans: MIT Press, 2022: 1–8.

[本文引用: 2]

Jiang J C, Dun C, Huang T J, et al. Graph convolutional reinforcement learning [C]// Proceedings of the 8th International Conference on Learning Representations. Addis Ababa: [s.n.], 2020: 1–13.

[本文引用: 1]

Wang S, Ji W, Gui H, et al

XMIX: graph-based temporal credit assignment and attention-augmented value decomposition for multi-agent cooperative reinforcement learning

[J]. Neurocomputing, 2025, 655: 131471

DOI:10.1016/j.neucom.2025.131471      [本文引用: 1]

Hu Y, Fu J, Wen G

Graph soft actor–critic reinforcement learning for large-scale distributed multirobot coordination

[J]. IEEE Transactions on Neural Networks and Learning Systems, 2025, 36 (1): 665- 676

DOI:10.1109/TNNLS.2023.3329530      [本文引用: 1]

Yang P F, Zheng T Y, Zhang S Y, et al

Graph-meta-reinforcement-learning-based algorithm for task offloading in vehicular edge–cloud collaboration

[J]. IEEE Transactions on Vehicular Technology, 2026, 75 (5): 8320- 8335

DOI:10.1109/TVT.2025.3626007      [本文引用: 1]

张名芳, 马健, 赵娜乐, 等

无信号交叉口处基于深度强化学习的智能网联车辆运动规划

[J]. 浙江大学学报(工学版), 2024, 58 (9): 1923- 1934

[本文引用: 1]

Zhang Mingfang, Ma Jian, Zhao Nale, et al

Intelligent connected vehicle motion planning at unsignalized intersections based on deep reinforcement learning

[J]. Journal of Zhejiang University (Engineering Science), 2024, 58 (9): 1923- 1934

[本文引用: 1]

Fellek G, Farid A, Fujimura S, et al

G-DGANet: gated deep graph attention network with reinforcement learning for solving traveling salesman problem

[J]. Neurocomputing, 2024, 579: 127392

DOI:10.1016/j.neucom.2024.127392      [本文引用: 1]

Nie M, Chen D, Wang D

Reinforcement learning on graphs: a survey

[J]. IEEE Transactions on Emerging Topics in Computational Intelligence, 2023, 7 (4): 1065- 1082

DOI:10.1109/TETCI.2022.3222545      [本文引用: 1]

Xu S, Guo S

Distributed reactive power optimization for energy Internet via multiagent deep reinforcement learning with graph attention networks

[J]. IEEE Transactions on Industrial Informatics, 2024, 20 (6): 8696- 8706

DOI:10.1109/TII.2023.3342467      [本文引用: 1]

Wang Y, Shi D, Xue C, et al. AHAC: actor hierarchical attention critic for multi-agent reinforcement learning [C]//Proceedings of the IEEE International Conference on Systems, Man, and Cybernetics. Toronto: IEEE, 2020: 3013–3020.

[本文引用: 2]

Lim B, Vu M

Distributed multi-agent deep Q-learning for load balancing user association in dense networks

[J]. IEEE Wireless Communications Letters, 2023, 12 (7): 1120- 1124

DOI:10.1109/LWC.2023.3250492      [本文引用: 1]

Foerster J N, Assael Y M, Freitas N D, et al. Learning to communicate with deep multi-agent reinforcement learning [C]// 30th Conference on Neural Information Processing Systems. Changsha: MIT Press, 2016: 2145–2153.

[本文引用: 1]

Das A, Gervet T, Romoff J, et al. TarMAC: targeted multi-agent communication [C]//Proceedings of the International Conference on Machine Learning. Long Beach: ACM, 2019: 1538–1546.

[本文引用: 1]

Singh A, Jain T, Sukhbaatar S. Learning when to communicate at scale in multiagent cooperative and competitive tasks [C]//Proceedings of the 7th International Conference on Learning Representations, 2019: 1−16.

[本文引用: 3]

Liu C, Guan D, Yuan W, et al

ITS2Graph: graph-based generative adversarial learning for imbalanced time series classification

[J]. Neural Networks, 2025, 191: 107770

DOI:10.1016/j.neunet.2025.107770      [本文引用: 1]

Wang H, Dou Y, Chen C, et al. Attacking fake news detectors via manipulating news social engagement [C]//Proceedings of the ACM Web Conference. Austin: ACM, 2023: 3978–3986.

[本文引用: 2]

Wang L, Wang R, Jia G. Generative adversarial nets model based on spatio-temporal graph attention network for multi-step prediction [C]//Proceedings of the China Automation Congress. Chongqing: IEEE, 2024: 6954–6959.

[本文引用: 2]

Zhu J H, Wen G X, Veluvolu K C

Optimized backstepping consensus control using adaptive observer-critic-actor reinforcement learning for strict-feedback multi-agent systems

[J]. Journal of the Franklin Institute-Engineering and Applied Mathematics, 2024, 361 (6): 1- 23

DOI:10.1016/j.jfranklin.2024.106693      [本文引用: 1]

Zhang J, Wang Z, JIANG Z, et al

Quantitative evaluation of molecular generation performance of graph-based GANs

[J]. Software Quality Journal, 2024, 32 (2): 791- 819

DOI:10.1007/s11219-024-09671-7      [本文引用: 1]

/

〈 〉