[1]
JOSHI A, BHAT A, JAIN A, et al. COGMEN: contextualized GNN based multimodal emotion recognition [C]// Proceedings of the 2022 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies . Seattle: Association for Computational Linguistics, 2022: 4148–4164.
[本文引用: 2]
[2]
ZHENG X, ZHAO G, ZHU L, et al. PERD: personalized emoji recommendation with dynamic user preference [C]// Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval . Madrid: ACM, 2022: 1922–1926.
[本文引用: 1]
[3]
PHANEENDRA BOTTU V S G S, RAGAVAN K Emotion-based music recommendation system integrating facial expression recognition and lyrics sentiment analysis
[J]. IEEE Access , 2025 , 13 : 87740 - 87752
DOI:10.1109/ACCESS.2025.3570011
[本文引用: 1]
[4]
FOTOPOULOU E, CASSÀ È L, MAVRAIDI L, et al EduCardia: a modern technology-powered methodology for the assessment and improvement of social and emotional competencies of students in K12 schools
[J]. IEEE Access , 2025 , 13 : 10786 - 10804
DOI:10.1109/ACCESS.2025.3529120
[本文引用: 1]
[5]
KHAN N D, ALI KHAN J, LI J, et al Leveraging large language model ChatGPT for enhanced understanding of end-user emotions in social media feedbacks
[J]. Expert Systems with Applications , 2025 , 261 : 125524
DOI:10.1016/j.eswa.2024.125524
[本文引用: 1]
[6]
GIACOMUZZO G, TERRERAN M, JAIN S, et al. DECAF: a discrete-event based collaborative human-robot framework for furniture assembly [C]// Proceedings of the IEEE/RSJ International Conference on Intelligent Robots and Systems . Abu Dhabi: IEEE, 2024: 7085–7091.
[本文引用: 1]
[7]
YE J, WEI Y, WEN X C, et al. Emo-DNA: emotion decoupling and alignment learning for cross-corpus speech emotion recognition [C]// Proceedings of the 31st ACM International Conference on Multimedia . Ottawa: ACM, 2023: 5956–5965.
[本文引用: 1]
[8]
SHI T, HUANG S L. MultiEMO: an attention-based correlation-aware multimodal fusion framework for emotion recognition in conversations [C]// Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) . Toronto: Association for Computational Linguistics, 2023: 14752–14766.
[本文引用: 1]
[9]
GHOSAL D, MAJUMDER N, PORIA S, et al. DialogueGCN: a graph convolutional neural network for emotion recognition in conversation [C]// Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) . Hong Kong: Association for Computational Linguistics, 2019: 154–164.
[本文引用: 3]
[10]
HU J, LIU Y, ZHAO J, et al. MMGCN: multimodal fusion via deep graph convolution network for emotion recognition in conversation [C]// Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics and the 11th International Joint Conference on Natural Language Processing (Volume 1: Long Papers) . [S.l.]: Association for Computational Linguistics, 2021: 5666–5675.
[本文引用: 2]
[11]
HU D, HOU X, WEI L, et al. MM-DFN: multimodal dynamic fusion network for emotion recognition in conversations [C]// Proceedings of the ICASSP 2022—2022 IEEE International Conference on Acoustics, Speech and Signal Processing . Singapore: IEEE, 2022: 7037–7041.
[本文引用: 4]
[12]
SHEN W, WU S, YANG Y, et al. Directed acyclic graph network for conversational emotion recognition [C]// Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics and the 11th International Joint Conference on Natural Language Processing (Volume 1: Long Papers) . [S.l.]: Association for Computational Linguistics, 2021: 1551–1560.
[本文引用: 2]
[13]
NGUYEN C T, NGUYEN C B, LE D T, et al. Curriculum learning meets directed acyclic graph for multimodal emotion recognition [C]// Proceedings of the 2024 Joint International Conference on Computational Linguistics, Language Resources and Evaluation (LREC-COLING 2024) . Torino: Association for Computational Linguistics, 2024: 4259–4265.
[本文引用: 3]
[14]
BALTRUŠAITIS T, AHUJA C, MORENCY L P Multimodal machine learning: a survey and taxonomy
[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence , 2019 , 41 (2 ): 423 - 443
DOI:10.1109/TPAMI.2018.2798607
[本文引用: 1]
[15]
LI J, JI D, LI F, et al. HiTrans: a Transformer-based context- and speaker-sensitive model for emotion detection in conversations [C]// Proceedings of the 28th International Conference on Computational Linguistics . Barcelona: Association for Computational Linguistics, 2020: 4190–4200.
[本文引用: 2]
[16]
LIAN Z, LIU B, TAO J CTNet: conversational transformer network for emotion recognition
[J]. IEEE/ACM Transactions on Audio, Speech, and Language Processing , 2021 , 29 : 985 - 1000
DOI:10.1109/TASLP.2021.3049898
[本文引用: 2]
[17]
ZHANG X, LI Y. A cross-modality context fusion and semantic refinement network for emotion recognition in conversation [C]// Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) . Toronto: Association for Computational Linguistics, 2023: 13099–13110.
[本文引用: 2]
[18]
MA H, WANG J, LIN H, et al A transformer-based model with self-distillation for multimodal emotion recognition in conversations
[J]. IEEE Transactions on Multimedia , 2024 , 26 : 776 - 788
DOI:10.1109/TMM.2023.3271019
[本文引用: 2]
[19]
YUN T, LIM H, LEE J, et al. TelME: teacher-leading multimodal fusion network for emotion recognition in conversation [C]// Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers) . Mexico City: Association for Computational Linguistics, 2024: 82–95.
[本文引用: 1]
[20]
ISHIWATARI T, YASUDA Y, MIYAZAKI T, et al. Relation-aware graph attention networks with relational position encodings for emotion recognition in conversations [C]// Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP) . [S.l.]: Association for Computational Linguistics, 2020: 7360–7370.
[本文引用: 1]
[21]
TU G, XIE T, LIANG B, et al Adaptive graph learning for multimodal conversational emotion detection
[J]. Proceedings of the AAAI Conference on Artificial Intelligence , 2024 , 38 (17 ): 19089 - 19097
DOI:10.1609/aaai.v38i17.29876
[本文引用: 4]
[22]
LI M, SHI J, BAI L, et al FrameERC: framelet transform based multimodal graph neural networks for emotion recognition in conversation
[J]. Pattern Recognition , 2025 , 161 : 111340
DOI:10.1016/j.patcog.2024.111340
[本文引用: 2]
[23]
LI Z, TANG F, ZHAO M, et al. EmoCaps: emotion capsule based model for conversational emotion recognition [C]// Proceedings of the Findings of the Association for Computational Linguistics . Dublin: Association for Computational Linguistics, 2022: 1610–1618.
[本文引用: 1]
[24]
YANG H, GAO X, WU J, et al. Self-adaptive context and modal-interaction modeling for multimodal emotion recognition [C]// Proceedings of the Findings of the Association for Computational Linguistics . Toronto: Association for Computational Linguistics, 2023: 6267–6281.
[本文引用: 3]
[25]
SCHULLER B, BATLINER A, STEIDL S, et al Recognising realistic emotions and affect in speech: state of the art and lessons learnt from the first challenge
[J]. Speech Communication , 2011 , 53 (9/10 ): 1062 - 1087
DOI:10.1016/j.specom.2011.01.011
[本文引用: 1]
[26]
LIU Y, OTT M, GOYAL N, et al. RoBERTa: a robustly optimized BERT pretraining approach [EB/OL]. (2019–07–26)[2025–10–22]. https://arxiv.org/pdf/1907.11692.
[本文引用: 1]
[27]
HUANG G, LIU Z, VAN DER MAATEN L, et al. Densely connected convolutional networks [C]// Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition . Honolulu: IEEE, 2017: 2261–2269.
[本文引用: 1]
[28]
XIE Y, ZHOU P, KIM S. Decoupled side information fusion for sequential recommendation [C]// Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval . Madrid: ACM, 2022: 1611–1621.
[本文引用: 1]
[29]
BUSSO C, BULUT M, LEE C C, et al IEMOCAP: interactive emotional dyadic motion capture database
[J]. Language Resources and Evaluation , 2008 , 42 (4 ): 335 - 359
DOI:10.1007/s10579-008-9076-6
[本文引用: 1]
[30]
PORIA S, HAZARIKA D, MAJUMDER N, et al. MELD: a multimodal multi-party dataset for emotion recognition in conversations [C]// Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics . Florence: Association for Computational Linguistics, 2019: 527–536.
[本文引用: 1]
[31]
MAJUMDER N, PORIA S, HAZARIKA D, et al DialogueRNN: an attentive RNN for emotion detection in conversations
[J]. Proceedings of the AAAI Conference on Artificial Intelligence , 2019 , 33 (1 ): 6818 - 6825
DOI:10.1609/aaai.v33i01.33016818
[本文引用: 1]
2
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
1
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
Emotion-based music recommendation system integrating facial expression recognition and lyrics sentiment analysis
1
2025
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
EduCardia: a modern technology-powered methodology for the assessment and improvement of social and emotional competencies of students in K12 schools
1
2025
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
Leveraging large language model ChatGPT for enhanced understanding of end-user emotions in social media feedbacks
1
2025
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
1
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
1
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
1
... 多模态会话情感识别(multimodal emotion recognition in conversation, MERC)是自然语言处理领域中的重要任务[1 ] ,目的是识别说话人的情感状态. MERC任务在推荐系统[2 -3 ] 、社交媒体分析[4 -5 ] 、人机交互[6 -7 ] 等应用场景中具有广泛的应用价值,逐渐受到工业界和学术界的关注[8 ] . ...
3
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
2
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
4
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
... 不同模型在2个数据集上的性能评估指标对比结果分别如表2 和表3 所示. #和$表示结果分别来自MM-DFN[11 ] 和原始论文,*表示较AdaIGN[21 ] 有显著改善(p < 0.05). MELD中“恐惧”和“厌恶”类别相应的训练样本不足,无法得出具有统计意义的结论,表3 报告了其他5类情感的F1分数. 可以看出,MDF在2个数据集上均取得最优的整体性能. 具体来看,相比当前对比模型中表现最优的基线方法AdaIGN,MDF在IEMOCAP上的Acc和W-F1分别提升了2.38和2.31个百分点,在MELD上的分别提升了0.44和0.13个百分点. 经显著性检验验证,MDF的整体性能相较于基线方法具有显著提升. 从各个情绪类别的F1分数来看,MDF的大部分情绪分类优于基线. 在IEMOCAP中,对比所有基线,除“愤怒”、“兴奋”和“沮丧”3个情感类别的没有显著提升效果,其余情感类别的F1分数均有显著提升,并已通过显著性检验验证. 在MELD中,大部分情绪类别的识别效果均有所提升,尤其是“悲伤”和“愤怒”类别. ...
2
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
3
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
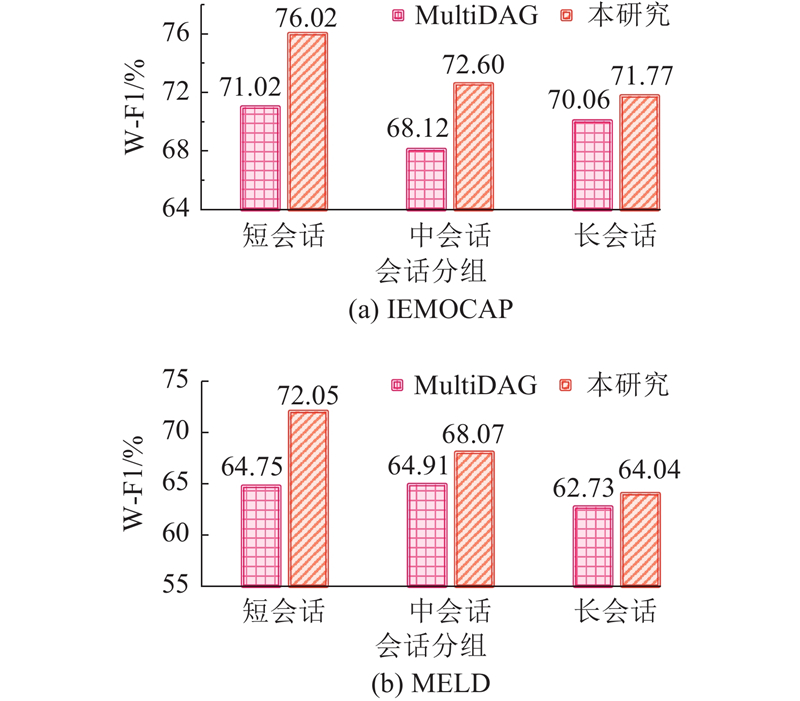
... 基于表1 的会话长度数据统计,采用第一分位点(Q1)和第三分位点(Q3)划分测试集为短会话、中会话和长会话. 对于IEMOCAP,短会话$ [1,43] $ $ (43,59] $ $ (59,91] $ $ [1,5] $ $ (5,13] $ $ (13,33] $ . 如图6 所示,MDF在所有会话长度的表现上都优于MultiDAG[13 ] . 此外,随着会话长度的增加,模型性能开始下降. 该现象主要归因于长会话中更复杂的语义依赖、情绪的频繁转变以及信息冗余,这些因素共同给模型的情感建模带来了更大挑战. 具体而言,长会话中远距离的上下文信息可能难以被有效捕获,影响模型对关键情感线索的理解和利用. 同时,过长的序列也可能导致自注意力机制在所有位置上分配同等关注,稀释真正重要的信息,降低模型的判别效率. 未来,考虑引入更高效的长序列建模技术,如稀疏注意力或分层Transformer结构,以更好地处理长距离依赖;或者结合外部知识库,辅助模型理解会话中隐含的情感演变,缓解长会话带来的性能下降问题. ...
Multimodal machine learning: a survey and taxonomy
1
2019
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
2
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
CTNet: conversational transformer network for emotion recognition
2
2021
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
2
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
A transformer-based model with self-distillation for multimodal emotion recognition in conversations
2
2024
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
... 式中:$ m=\left\{a,v,t\right\} $ $ {\tilde{\boldsymbol{x}}}_{i}^{m} $ $ \boldsymbol{c}_{i}^{m}\in {{R}}^{{{d}_{0}}} $ $ m $ $ i $ [18 ] : ...
1
... MERC任务面临两大核心挑战,一是上下文信息的精准提取,二是多模态特征的有效融合. 图神经网络(graph neural network, GNN)强大的关系建模能力被用于捕捉更灵活和丰富的上下文结构[1 ] . 例如,Ghosal等[9 -11 ] 通过构建全连接图来传递全局信息. 这种做法忽略了会话中并非所有话语都存在强关联,往往会引入噪声干扰. 有研究者为此构建有向无环图,建模说话人之间及自身话语间的情感依赖[12 -13 ] . 这种方法过度依赖说话人关系,未能充分整合其他潜在语义线索,导致上下文信息提取不够全面. 可见,现有方法在精细化建模多角度上下文信息方面仍存在不足. 在多模态特征融合方面,早期方法仅将多模态信息进行简单相加或拼接[14 ] ,未能模拟复杂的跨模态交互. 多模态融合方法被引入Transformer结构[15 -19 ] ,利用自注意力机制促进跨模态信息交互. 这在一定程度上增强了融合能力,但不同模态的特征源自独立编码器,直接交互易引入噪声和冗余信息,从而影响融合效果. 此外,传统Transformer中的多头注意力机制默认所有注意力头具有同等重要性,忽略了表征能力的差异,导致低质量的注意力矩阵对模型性能产生负面影响. ...
1
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
Adaptive graph learning for multimodal conversational emotion detection
4
2024
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
... 实验选用2个常用多模态会话情感识别基准数据集:IEMOCAP[29 ] 和MELD[30 ] . IEMOCAP分为6个类别:快乐、悲伤、中性、愤怒、兴奋和沮丧. MELD分为7个类别:中性、惊讶、恐惧、悲伤、喜悦、厌恶和愤怒. 遵循以往工作[21 ] ,数据集划分和详细信息如表1 所示. 采用准确率Acc和加权平均F1分数W-F1作为主要评估指标,衡量模型的整体性能;报告每个情绪类别的F1分数,反映模型在各类情绪上的识别表现. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
... 不同模型在2个数据集上的性能评估指标对比结果分别如表2 和表3 所示. #和$表示结果分别来自MM-DFN[11 ] 和原始论文,*表示较AdaIGN[21 ] 有显著改善(p < 0.05). MELD中“恐惧”和“厌恶”类别相应的训练样本不足,无法得出具有统计意义的结论,表3 报告了其他5类情感的F1分数. 可以看出,MDF在2个数据集上均取得最优的整体性能. 具体来看,相比当前对比模型中表现最优的基线方法AdaIGN,MDF在IEMOCAP上的Acc和W-F1分别提升了2.38和2.31个百分点,在MELD上的分别提升了0.44和0.13个百分点. 经显著性检验验证,MDF的整体性能相较于基线方法具有显著提升. 从各个情绪类别的F1分数来看,MDF的大部分情绪分类优于基线. 在IEMOCAP中,对比所有基线,除“愤怒”、“兴奋”和“沮丧”3个情感类别的没有显著提升效果,其余情感类别的F1分数均有显著提升,并已通过显著性检验验证. 在MELD中,大部分情绪类别的识别效果均有所提升,尤其是“悲伤”和“愤怒”类别. ...
FrameERC: framelet transform based multimodal graph neural networks for emotion recognition in conversation
2
2025
... Ghosal等[9 ] 提出对话图卷积网络(dialogue graph convolutional network, DialogueGCN),通过建模说话人内部及说话人间的语境依赖,为会话建模引入图结构. Ishiwatari等[20 ] 提出关系图注意力网络(relational graph attention networks, RGAT),通过引入关系位置编码,增强了图结构中的时序信息,实现了结构信息与序列信息的结合. Hu等[10 ] 提出多模态融合图卷积网络(multimodal fused graph convolutional network, MMGCN),在会话图中引入多模态特征节点,使模型能够同时建模模态间依赖与说话人间结构关系. 为了提升信息传递的方向性,Shen等[12 ] 提出有向无环图(directed acyclic graph, DAG)情感识别模型DAG-ERC,利用说话人身份和位置关系构建DAG,从而模拟上下文信息流. 在此基础上,Nguyen等[13 ] 将DAG构图策略扩展至多模态任务中,提出多模态DAG课程学习模型MultiDAG+CL,结合课程学习机制(curriculum learning, CL)提升对情绪转变和数据不平衡的鲁棒性. Hu等[11 ] 提出多模态动态融合网络(multimodal dynamic fusion network, MM-DFN),通过动态调整融合图结构,缓解模态冗余问题,增强了语义表达. Tu等[21 ] 提出自适应交互图网络(adaptive interactive graph network, AdaIGN),引入Gumbel Softmax和节点边选择机制,从图结构本身出发,实现信息交互的自适应优化. Li等[22 ] 提出基于图结构的新型端到端ERC模型——FrameERC. ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
1
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
3
... Li等[15 ] 提出基于Transformer的上下文与说话人敏感的会话情感检测模型(Transformer-based context- and speaker-sensitive model, HiTrans),用于建模局部与全局上下文. Lian等[16 ] 提出对话Transformer网络(conversational Transformer network, CTNet),利用Transformer结构建模模态内和跨模态交互. Li等[23 ] 引入情感胶囊模型(emotion capsule-based model, EmoCaps),通过情感向量重构多模态特征,并结合上下文分析,进一步提升模型的分类性能. Yang等[24 ] 提出自适应上下文与模态交互建模框架(self-adaptive context and modal-interaction modeling, SCMM) ,通过Transformer的结构建模全局信息. Ma等[18 ] 提出基于自蒸馏的Transformer多模态会话情感识别模型(Transformer-based model with self-distillation, SDT),通过Transformer捕获模态内和模态间的交互,利用分层门控融合模块动态地为每个模块派生特定于任务的增强表示. Zhang等[17 ] 提出跨模态上下文融合与语义细化网络(cross-modality context fusion and semantic refinement network, CMCF-SRNet),设计跨模态局部约束Transformer,用于研究多个模态交互. ...
... 得到各个模态的多头注意力矩阵后,通过解耦融合[24 ] 得到文本模态的融合特征: ...
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...
Recognising realistic emotions and affect in speech: state of the art and lessons learnt from the first challenge
1
2011
... 给定一段由$ N\geqslant 2 $ $ D = \{{u}_{1},{u}_{2},\cdots,{u}_{N}\} $ $ M\geqslant 2 $ i 句话语对应说话人$ {s}_{i} $ . 此外,每句话语有音频、文本和视觉3种模态的信息,第$ i $ $ {u}_{i}=\{\boldsymbol{u}_{i}^{a},\boldsymbol{u}_{i}^{t},\boldsymbol{u}_{i}^{v}\} $ . 音频特征$ \boldsymbol{u}_{i}^{a}\in {{R}}^{{{d}_{a}}} $ [25 ] 提取,文本特征$ \boldsymbol{u}_{i}^{t}\in {{R}}^{{{d}_{t}}} $ [26 ] 提取,视觉特征$ \boldsymbol{u}_{i}^{v}\in {{R}}^{{{d}_{v}}} $ [27 ] 提取. MERC的任务是通过处理多模态信息来识别会话中每句话语的情感状态. ...
1
... 直接融合多模态特征容易受到噪声干扰,且传统多头注意力机制忽视注意力头质量差异. 为此,设计多视角模态解耦融合模块,包含Top-K掩码机制、注意力头重要性建模及多模态解耦融合策略. 该解耦策略[28 ] 并非简单地将各模态完全分离,而是通过构建主辅模态架构,辅以注意力机制中的精细化控制,以减少模态间的直接干扰和噪声,从而更有效地融合信息. 3个模态均采用相同结构,本节以文本模态为主模态,音频和视觉模态为辅助模态为例说明. ...
IEMOCAP: interactive emotional dyadic motion capture database
1
2008
... 实验选用2个常用多模态会话情感识别基准数据集:IEMOCAP[29 ] 和MELD[30 ] . IEMOCAP分为6个类别:快乐、悲伤、中性、愤怒、兴奋和沮丧. MELD分为7个类别:中性、惊讶、恐惧、悲伤、喜悦、厌恶和愤怒. 遵循以往工作[21 ] ,数据集划分和详细信息如表1 所示. 采用准确率Acc和加权平均F1分数W-F1作为主要评估指标,衡量模型的整体性能;报告每个情绪类别的F1分数,反映模型在各类情绪上的识别表现. ...
1
... 实验选用2个常用多模态会话情感识别基准数据集:IEMOCAP[29 ] 和MELD[30 ] . IEMOCAP分为6个类别:快乐、悲伤、中性、愤怒、兴奋和沮丧. MELD分为7个类别:中性、惊讶、恐惧、悲伤、喜悦、厌恶和愤怒. 遵循以往工作[21 ] ,数据集划分和详细信息如表1 所示. 采用准确率Acc和加权平均F1分数W-F1作为主要评估指标,衡量模型的整体性能;报告每个情绪类别的F1分数,反映模型在各类情绪上的识别表现. ...
DialogueRNN: an attentive RNN for emotion detection in conversations
1
2019
... 将MDF与先进的基线方法进行比较:DialogueRNN[31 ] 采用3个GRU建模全局状态、角色状态及情感表示;MMGCN[10 ] 利用图结构融合来捕捉多模态依赖关系与说话人信息;CTNet[16 ] 利用Transformer建模模态内和模态间的交互;MM-DFN[11 ] 引入动态融合机制以降低模态冗余并增强互补性;SCMM[24 ] 集成上下文建模、模态交互和路径选择模块以融合多模态特征;CMCF-SRNet[17 ] 将Transformer与图结构精炼机制结合,探索模态交互与语义关系;MultiDAG[9 ] 使用DAG和课程学习解决情感转变与数据不平衡问题;FrameERC[22 ] 是基于图形的模型,在特征级强调高频信号;AdaIGN[21 ] 引入自适应图神经网络建模说话人间的依赖关系. ...