



随着超大规模多输入多输出(multiple-input multiple-output, MIMO)系统的广泛部署,计算复杂性和控制开销增加,传统通信方法依赖逐比特精确传输模式,系统在面对复杂信道条件时,难以兼顾传输质量与资源效率. 在图像传输领域,传统图像压缩编码方法在低信噪比(signal-to-noise ratio, SNR)环境下易因量化失真而导致细节丢失;MIMO系统的信道矩阵维度更高,信道状态更难估计与补偿,接收端重建图像时的模糊与畸变问题加剧. 基于端到端优化神经网络或深度学习的联合信源信道编码(deep joint source-channel coding,Deep JSCC)方法已成为语义通信领域的活跃研究对象,其图像传输性能超越经典基于分离式的方法,如JPEG、JPEG2000和BPG等[1-2].
基于端到端深度学习的数据传输已成为语义通信领域的主要研究方向. Deep JSCC方法通常以CNN为骨干网络. CNN捕捉图像中长距离语义关联的能力受局部感受野的限制,在捕捉全局上下文信息方面存在不足,可能丢失在特征提取过程中对语义理解至关重要的结构性特征信息[7-8]. ViT(Vision Transformer)通过窗口注意力机制直接应用于图像块序列,相较于传统CNN模型,经过JFT-300M预训练的ViT-H/14在ImageNet上准确率为88.55%,超过CNN基线模型如BiT和Noisy Student[9]. 典型的ViT通过全局自注意力机制对图像块序列建模,在ImageNet和COCO基准上性能领先[9-10],为图像语义传输和图像处理领域的后续研究提供了重要参考. ViT在处理高维数据或长序列时,随着序列长度
单输入单输出(single-input single-output, SISO)的天线传输系统在一定程度上限制了数据传输速率. MIMO通过空间复用和多径传输机制实现更高的数据吞吐量和鲁棒性,但多用户干扰与信道状态动态变化为图像语义信息的稳定传输带来了新的挑战. Liang等[13]提出基于奇异值分解的MIMO瑞利衰落(Rayleigh fading)信道上的语义重要性感知系统,以最大限度地提高语义性能. 有研究者提出在基于Deep JSCC的MIMO信道中使用Transformer预编码方法传输图像语义信息,减少天线间的干扰[14]. 目前缺少将预编码方法和基于Swin Transformer的语义编码器相结合的图像语义传输方案. Li等[15-16]将MIMO衰落信道上的信道状态信息(channel state information,CSI)作为语义特征提取器的侧信息,辅助增强语义编码,提升图像语义信息的稳定传输. 由于在MIMO系统中CSI反馈开销较大,在基于Swin Transformer的图像多级语义MIMO传输中,结合预编码方法优化端到端传输是值得探究的方向.
本研究提出MIMO系统下基于Swin Transformer的图像多级语义特征自适应融合的传输方案:1)在发射端采用Swin Transformer模块对原始图像执行多尺度处理,通过局部窗口注意力机制实现像素级语义特征提取;2)利用Word2Vec模型将离散的图像类别标签文本信息映射为连续文本语义向量;3)通过自适应权重融合机制整合不同维度的特征信息,构建出紧凑而完备的联合语义表征;4)通过Transformer预编码器,根据语义特征和MIMO信道状态学习预编码映射,以抑制空间干扰并实现联合优化.
1. 语义通信系统
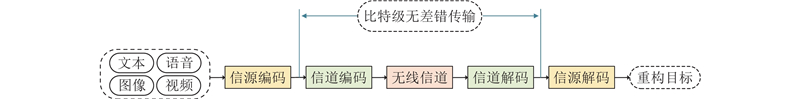
如图1所示,传统数字通信系统基于香农信息论框架,以比特级精确传输为目标,着重保障信息的无差错传递. 该系统先利用信源编码实现数据压缩,继而通过信道编码(如LDPC码和Turbo码)引入冗余,抵御瑞利衰落或加性高斯白噪声(additive white Gaussian noise, AWGN)的信道干扰,最终经由调制技术将信号适配至物理信道进行传输. 接收端通过与编码过程相对应的逆操作,包括信道解码、解调及信源解码完成原始信息的重构.
图 1
图像包含多层级语义信息,底层语义主要保留图像的像素细节与颜色分布,以维持基本视觉保真度;中层语义侧重目标轮廓、纹理特征与空间结构的建模,有助于重构时恢复目标形态与相对位置;高层语义融合图像文本描述与外部先验知识,形成具有抽象推理能力的语义表征[17]. 通过提取图像的语义信息,利用预构建的语义知识库将图像内容进行语义映射并进行传输的方案如图2所示. 在理论上,语义知识库可通过预训练的图神经网络存储跨模态语义关联规则,指导各层级特征的编码权重分配与冗余压缩. 在理想传输过程中,系统将根据信道状态动态调整层级间的带宽分配策略:在低信噪比条件下优先传输高层抽象语义,以确保核心信息的可理解性;在高带宽环境下,传输中层的结构化细节以提升重建质量[18-19]. 接收端结合语义知识库推理能力,通过跨层级特征融合实现端到端语义恢复,显著降低对传统像素级重建的依赖. 这一多层级机制不仅提升了图像语义通信的鲁棒性,还通过知识驱动的自适应压缩,在有限码长下实现语义熵的最小化[20].
图 2
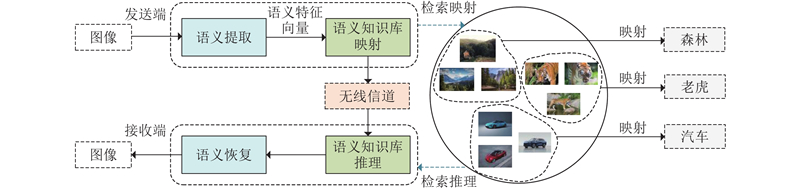
图 2 图像语义传输方案及语义知识库映射
Fig.2 Image semantic transmission scheme and semantic knowledge base mapping
如图3所示,常见的基于神经网络的图像语义通信系统以语义保真度为优化目标,强调传输对视觉理解中关键的语义信息(如目标轮廓和纹理关联性). 神经网络进行原始数据的多层级语义特征提取,并利用信源信道联合编码的优势,将提取的语义信息在有限码长的情况下直接映射到信道符号. 该方法通过自适应信道条件,实现端到端的高效通信系统.
图 3
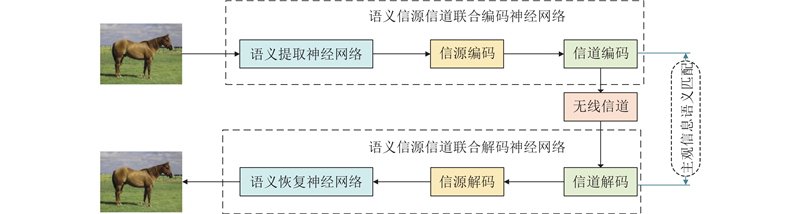
图 3 基于神经网络的图像语义通信系统
Fig.3 Image semantic communication system based on neural networks
2. 图像多级语义MIMO传输方案
在基于CNN的Deep JSCC图像语义传输方案中,CNN的局部感受野限制了CNN捕捉图像中长距离语义关联的能力. 为了降低ViT由于全局自注意力机制带来计算成本显著增加的问题,本研究提出基于Swin Transformer的图像多级语义信息MIMO传输,为6G通信系统中的高效语义传输提供新的技术方案.
2.1. 系统模型
如图4所示,所提图像语义通信方案由待传输的图像群、语义特征编解码器、基于Transformer的预编码器和相对应解码器组成. 在发送端,待传输的
图 4
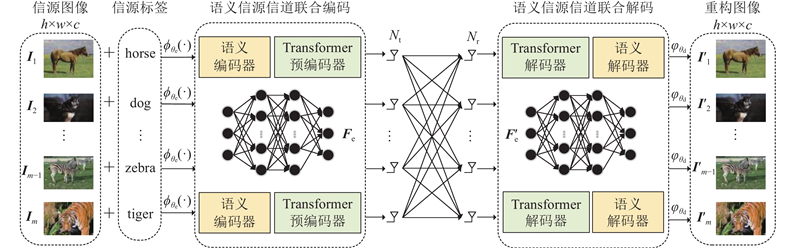
式中:
图 5
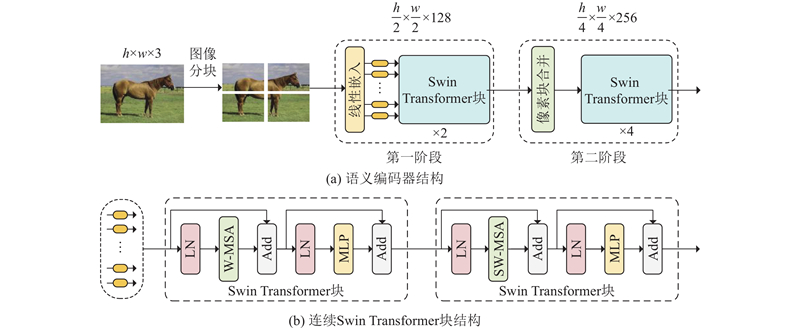
图 5 语义编码器结构及连续Swin Transformer块结构
Fig.5 Semantic encoder structure and continuous Swin Transformer block structure
式中:
其中
2.2. 多级图像语义特征融合
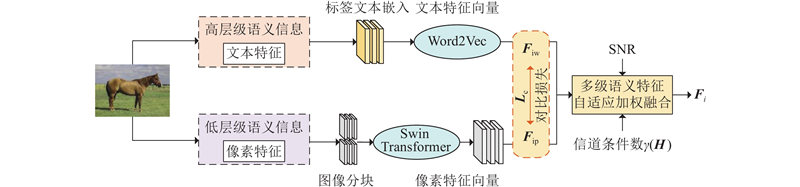
高层级语义信息融合图像文本描述与外部先验知识,具有抽象推理能力;低层级语义信息包括图像的局部细节语义特征[22]. BERT、CLIP和Word2Vec等词嵌入模型已被广泛用于自然语言处理,这些模型均能将离散文本映射到连续的语义空间,为多级语义特征融合提供文本侧表征. BERT与CLIP的语义特征提取表达能力更强,却总是伴随较高的参数量和推理延迟;Word2Vec为静态词表结构,兼具平衡性能-复杂度优势.
如图6所示,本研究提出的嵌入语义编码器中的多级语义特征提取器包括高层级标签文本特征模块和低层级像素特征模块,不同模块负责提取不同层级的图像语义信息. 标签文本特征模块基于Word2Vec模型[23],将不同图像的离散类别标签文本信息映射为连续的文本语义特征向量
图 6
其中
其中权重
式中:
2.3. 基于Transformer预编码的MIMO系统
在典型MIMO通信场景下,无线信道受多径传播效应、时变衰落特性及信道矩阵维度升高,空间干扰耦合更复杂等因素的共同作用,会引发接收信号间的非线性干扰叠加问题. 现有基于非码本的线性预编码方法能够实现信道增益矩阵
其中
MMSE预编码的最终预编码矩阵与ZF阶数一致,因此复杂度保持同阶. Transformer预编码器和解码器的网络结构如图7所示,输入端将语义特征向量
图 7
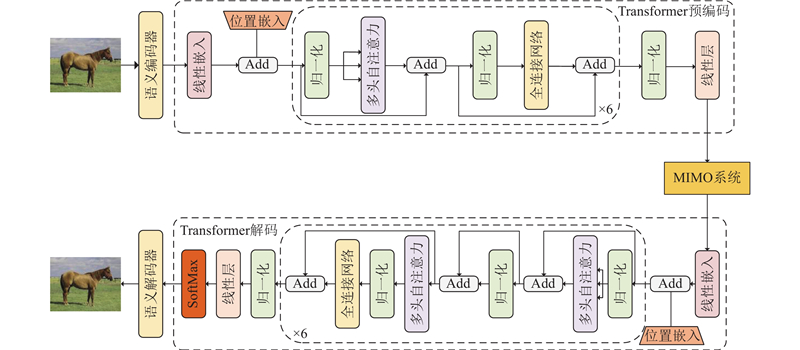
图 7 Transformer预编码器和解码器的结构
Fig.7 Structure of pre-encoder and decoder of Transformer
式中:
其中
将发射端、信道模型和接收端在同一个图像数据集上进行联合训练,引入Transformer预编码联合优化语义特征与信道状态,使传输系统具有适应不同通信环境的能力,解决传统非码本线性预编码方法运用于MIMO系统中的高复杂度问题.
3. 实验结果与分析
3.1. 实验设置
在不同信噪比、信道带宽比(channel bandwidth ratio,CBR)和MIMO系统天线数量的仿真条件下进行实验,将所提方案与传统方案进行接收端图像重建质量的比较. 所有实验结果均使用CIFAR-10数据集训练得到的评价模型得到,数据集中每个样本均为32×32×3(宽度×高度×色彩通道)像素的RGB图像,分别包含50 000个训练样本和10 000个测试样本. 训练集和测试集由完全不同的10类图像组成;每个图像配备类别标签值0~9,用于将离散类别标签文本信息映射为连续的文本语义特征向量. 数据集图像本身包含的细节信息较少,在像素语义特征提取部分采用窗口大小设置为2,含有2个阶段Swin Transformer的骨干网络来集中提取局部关键特征. 该数据集具备广泛的实验基准地位,适用于快速验证多模型和多参数配置下的方法性能,特别是在语义通信领域,已有大量研究采用该数据集进行对比测试. 尽管CIFAR-10图像分辨率较低,但保留了目标的基本轮廓与纹理模式,能够评估多级语义特征提取与恢复能力,尤其在低SNR和小样本训练条件下更能体现模型在结构细节提取与恢复方面的优势. 此外,在引入多尺度Swin Transformer和标签文本语义信息对齐机制后,模型可以在有限信息条件下展现出较强的语义感知与重建能力.
实验平台CPU为Intel(R) Core(TM) i5-14600KF 3.50 GHz,GPU为NVIDIA GeForce RTX
3.2. 评估指标
为了衡量基于Swin Transformer的MIMO信道图像语义传输方案的重建性能,从不同层面对比分析重建图像与原始图像的差异,对重建图像采用2种常见的图像质量评估指标:峰值信噪比(peak signal-to-noise ratio,PSNR)和结构相似性(structural similarity index measure,SSIM). PSNR是利用均方误差(mean squared error,MSE)反映图像重建质量的常用指标,
式中:
式中:对于CIFAT-10数据集,
式中:
3.3. 实验结果分析
如图8所示为AWGN信道下CBR=0.5时,不同传输方案的图像重建质量. 实验在配备不同数量的发送天线和接收天线的MIMO场景下进行比较,各项传输方案在4×4 MIMO场景中的图像重建质量均优于2×2 MIMO场景的图像重建质量. 此外,各方案接收端重建图像的PSNR随SNR增加呈单调递增趋势. 在高SNR环境下,噪声导致的信息丢失与损坏更少,支持更多图像语义信息与细节传输,重建图像质量更趋近于原始图像. 在低SNR环境下,JPEG2000和BPG方案的PSNR呈现急剧下降趋势,甚至出现悬崖效应,部分归因于传统压缩标准采用信源编码与信道编码分离的设计,未考虑端到端失真. 相比之下,本研究所提传输方案与基于CNN的Deep JSCC仍能维持较高PSNR水平,其中本研究基于Swin Transformer的多级语义特征传输方案表现更优. 在4×4 MIMO场景下,当SNR=0 dB时,所提方案的PSNR较JPEG2000提升3.06倍,较BPG提升4.55倍,较Deep JSCC提升62.97%;SSIM较JPEG2000提升2.79倍,较BPG提升4.46倍,较Deep JSCC提升42.59%. 多级语义特征自适应融合机制使图像在压缩传输至信道干扰严重的环境时,尽管像素层面存在损失,但语义结构更完整、更自然,维持了重建图像质量,表现出更优的适应性与鲁棒性.
图 8
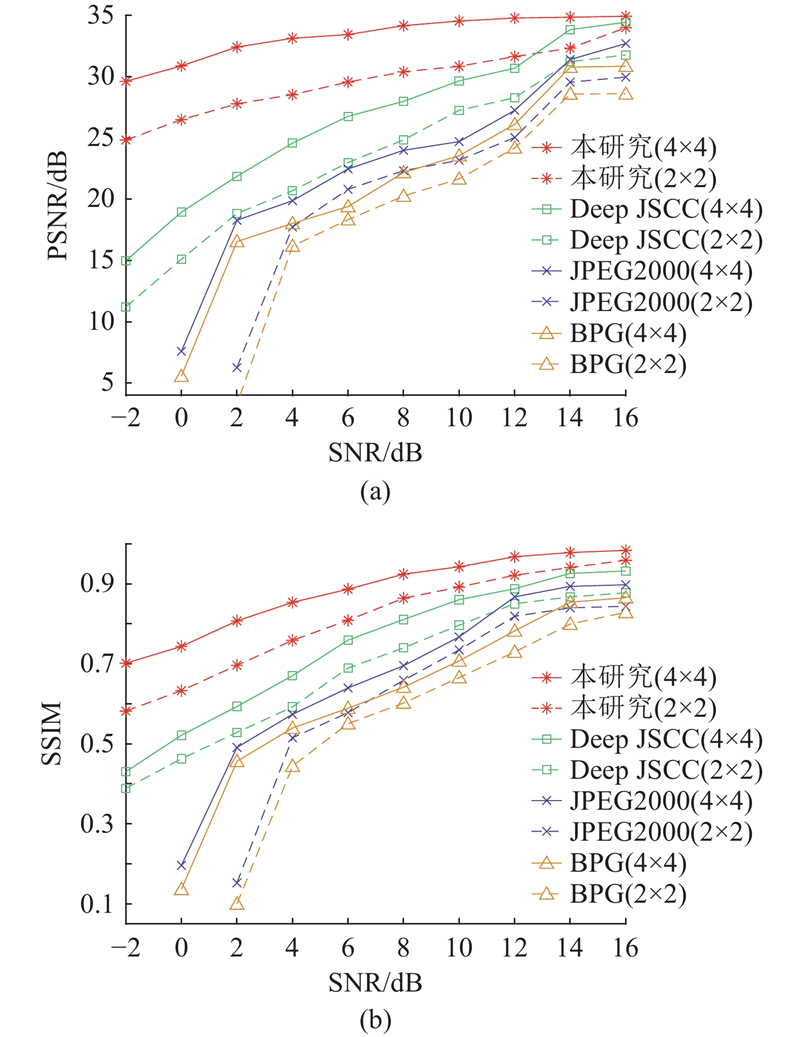
图 8 不同传输方案的图像重建质量对比
Fig.8 Comparison of image reconstruction quality among different transmission schemes
在MIMO系统中利用有限资源实现数据的高效传输,CBR是优化频谱资源利用与提升系统性能的关键参数. 如图9所示为在2×2和4×4 MIMO场景下,CBR对不同传输方案图像重建质量的影响. 可以看出,随着CBR增大,重建图像质量呈上升趋势,原因是较高的CBR对应图像语义信息经过较少的数据压缩,保留了更多的语义信息. 在2×2 MIMO场景下,评估指标为SSIM时所提传输方案比以CNN为网络骨干的Deep JSCC、JPEG2000和BPG的传输方案的性能至少分别提升4.03%、11.09%和12.60%;在4×4 MIMO场景下,性能至少分别提升2.24%、9.39%和12.96%. 上述实验结果,验证了本研究所提传输方案可以在MIMO通信系统情况下,更好地平衡图像语义传输质量与效率.
图 9
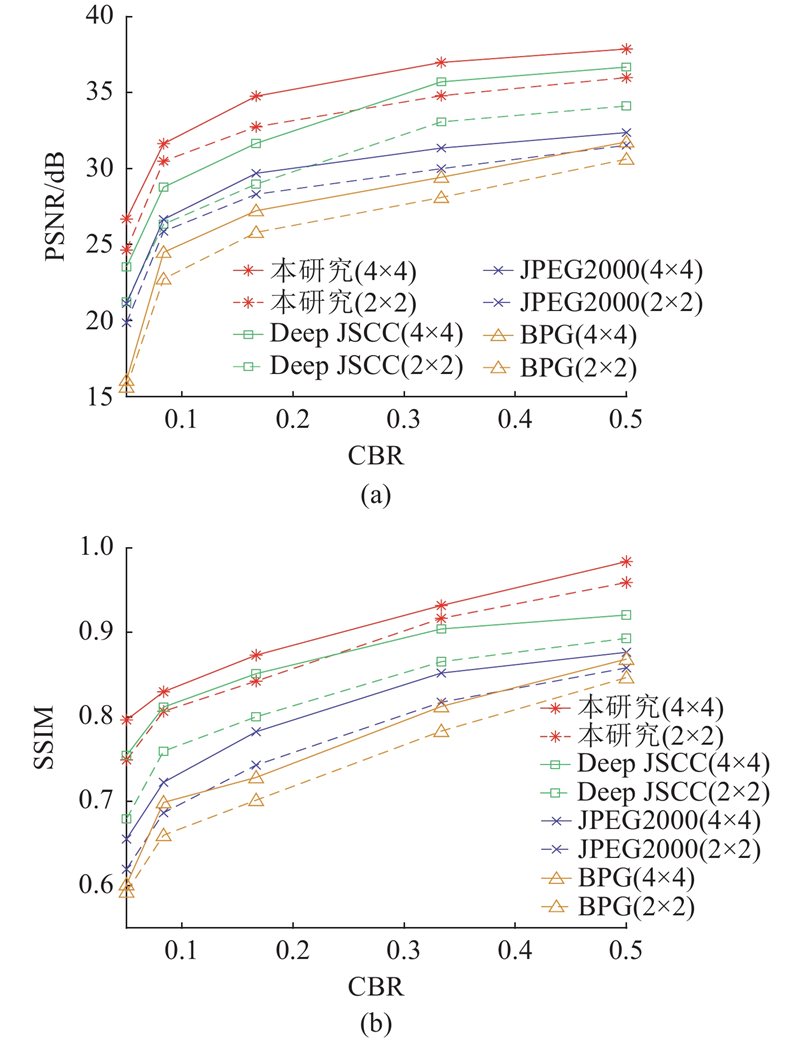
图 9 信道带宽比对不同传输方案图像重建质量的影响
Fig.9 Impact of channel bandwidth ratio on image reconstruction quality for different transmission schemes
设置自适应权重融合(权重下界
图 10
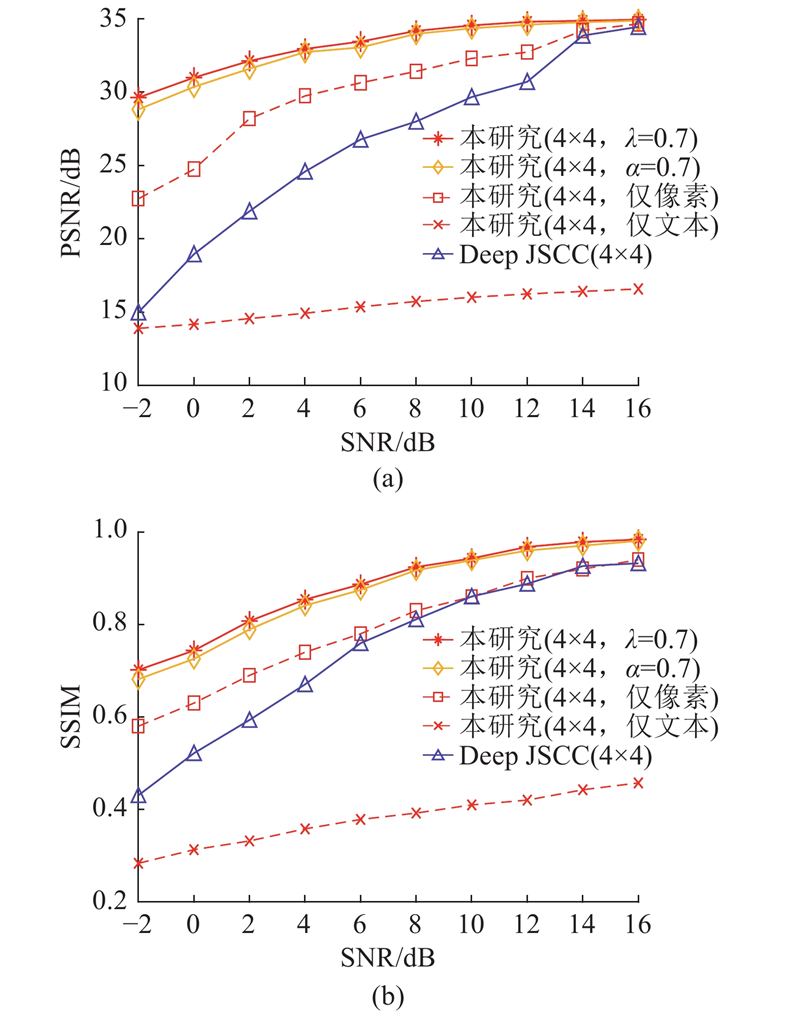
图 10 多级语义特征融合对图像重建质量的影响
Fig.10 Impact of multilevel semantic feature fusion on image reconstruction quality
在SNR=10 dB的4×4 MIMO场景下,进行方案的复杂度和实时性评估,指标包括模型参数量、每秒浮点运算数(floating point operations per second, FLOPs)、系统端到端延迟、PSNR和SSIM,结果如表1所示. 测试在批量大小为1的CIFAR-10数据集上重复实验20次,取平均后得到单次传输的端到端延迟. 本研究所提方案的参数量为46.82×10⁶,较Deep JSCC增加约7.50×10⁶,但Swin Transformer的局部窗口自注意力将FLOPs从6.57×10⁹降至5.12×10⁹,计算量下降22.07%. 所提方案不需要LDPC编码和对信道矩阵无求逆的Transformer预编码,端到端延迟为16.48 ms,显著低于其他传输方案. 虽然在模型参数量方面没有相对优势,但是所提方案在计算量与端到端延迟方面领先的同时,重建图像的PSNR和SSIM均有提升. 将Transformer预编码模块移除重新训练模型,验证该模块对系统最终性能及复杂度的影响,发现引入Transformer预编码模块后,参数量、FLOPs与端到端延迟仅分别增加约6.99%、4.70%和10.46%,但PSNR和SSIM指标显著提升了12.94 dB和0.349 5. Transformer预编码模块的引入有效抑制了空间干扰耦合复杂性与多径效应引发的信号失真问题,显著改善接收信号质量,实现了模型复杂度与图像重建质量之间更优平衡.
表 1 方案复杂度与实时性的评估
Tab.1
| 传输方案 | 参数量/106 | FlOPs/109 | 端到端延迟/ms | PSNR/dB | SSIM |
| 本研究 | 46.82 | 5.12 | 16.48 | 34.56 | 0.943 0 |
| 本研究(无Transformer预编码) | 43.76 | 4.89 | 14.92 | 21.62 | 0.593 5 |
| Deep JSCC | 39.32 | 6.57 | 37.32 | 29.66 | 0.860 7 |
| JPEG2000+LDPC | — | — | 94.73 | 24.71 | 0.767 5 |
| BPG+LDPC | — | — | 81.26 | 23.56 | 0.707 6 |
4. 结 语
本研究提出MIMO系统下基于Swin Transformer多级语义特征自适应融合与Transformer预编码协同的图像语义传输方案,针对MIMO信道高维度空间干扰耦合的核心问题,通过Transformer预编码促进语义-信道联合优化,有效抑制多用户干扰,提升低SNR场景下语义信息传输的鲁棒性. 所设计的多级语义特征自适应融合模块,通过像素语义特征与标签文本语义特征的跨模态对齐,在统一语义空间中强化语义一致性约束,缓解了低SNR和复杂信道环境下引发的图像结构畸变,实现语义保真度与视觉质量的提升. 所提方案突破了传统通信方式在单一特征依赖、信号失真及信道环境适配性上的固有瓶颈,通过Swin Transformer多尺度提取能力与Transformer预编码的信道适配优势,为复杂MIMO信道下的高可靠图像语义通信提供了新框架. 该方案在低SNR及复杂信道条件下的性能显著优于传统压缩编码方法及基于CNN的Deep JSCC语义通信方案,验证了语义-信道协同优化与跨模态语义对齐在提升通信鲁棒性中的关键作用. 未来研究将进一步拓展至CSI不完备的实际场景,并在如ImageNet、DIV2K的高分辨率数据集上深入探索多级语义特征融合机制的泛化能力,以提升方案在更复杂信道环境与更高分辨率图像传输任务中的适用性.
参考文献
SwinJSCC: taming Swin Transformer for deep joint source-channel coding
[J].DOI:10.1109/TCCN.2024.3424842 [本文引用: 1]
面向语义通信的非线性变换编码
[J].DOI:10.11959/j.issn.1000-436x.2023087 [本文引用: 1]
Nonlinear transform coding for semantic communications
[J].DOI:10.11959/j.issn.1000-436x.2023087 [本文引用: 1]
面向语义通信的信道知识库构建与信道处理研究综述
[J].DOI:10.3969/j.issn.1003-3114.2024.03.013 [本文引用: 1]
Recent research on channel knowledge base construction and channel processing for semantic communication: a survey
[J].DOI:10.3969/j.issn.1003-3114.2024.03.013 [本文引用: 1]
Swin Transformer-based dynamic semantic communication for multi-user with different computing capacity
[J].DOI:10.1109/TVT.2024.3362328 [本文引用: 1]
Deep joint source-channel coding for wireless image transmission
[J].DOI:10.1109/TCCN.2019.2919300 [本文引用: 1]
Transformer-empowered 6G intelligent networks: from massive MIMO processing to semantic communication
[J].DOI:10.1109/MWC.008.2200157 [本文引用: 1]
A survey on vision transformer
[J].DOI:10.1109/TPAMI.2022.3152247 [本文引用: 1]
Robust image semantic coding with learnable CSI fusion masking over MIMO fading channels
[J].DOI:10.1109/TWC.2024.3409735 [本文引用: 1]
Toward semantic communications: deep learning-based image semantic coding
[J].DOI:10.1109/JSAC.2022.3221999 [本文引用: 1]
Excess distortion exponent analysis for semantic-aware MIMO communication systems
[J].DOI:10.1109/TWC.2023.3238463 [本文引用: 1]
End-to-end learning for task-oriented semantic communications over MIMO channels: an information-theoretic framework
[J].DOI:10.1109/JSAC.2025.3531575 [本文引用: 1]
Wireless deep video semantic transmission
[J].DOI:10.1109/JSAC.2022.3221977 [本文引用: 1]
Spatially and temporally correlated MIMO channels: modeling and capacity analysis
[J].DOI:10.1109/TVT.2004.825766 [本文引用: 1]
Adaptive attention-based high-level semantic introduction for image caption
[J].


