浙江大学学报(工学版), 2026, 60(11): 2442-2452 doi: 10.3785/j.issn.1008-973X.2026.11.013

计算机技术

基于多任务对比约束与可控缺陷生成的异常检测算法

刘宇轩,, 苏恩祈, 井佩光, 孙宏博,, 苏育挺

1. 天津大学 电气自动化与信息工程学院,天津 300072

2. 中电信人工智能科技(北京)有限公司,北京 100027

Anomaly detection algorithm based on multi-task contrastive constraints and controllable anomaly synthesis

LIU Yuxuan,, SU Enqi, JING Peiguang, SUN Hongbo,, SU Yuting

1. School of Electrical and Information Engineering, Tianjin University, Tianjin 300072, China

2. China Telecom Artificial Intelligence Technology (Beijing) Co., Ltd., Beijing 100027, China

通讯作者: 孙宏博,男,工程师,博士. orcid.org/0000-0002-2639-9035. E-mail:sunhb3@chinatelecom.cn

收稿日期: 2025-10-8  

基金资助: 国家自然科学基金资助项目(62361002).

Received: 2025-10-8  

Fund supported: 国家自然科学基金资助项目(62361002).

作者简介 About authors

刘宇轩(2001—),男,硕士生,从事图像、视频语义分析研究.orcid.org/0009-0005-8351-3454.E-mail:liuyx2@tju.edu.cn , E-mail:liuyx2@tju.edu.cn

摘要

针对无监督视觉异常检测中正常与异常特征边界区分模糊的问题,提出基于多任务对比约束的算法. 通过可控异常生成模块生成高拟真的异常图像,作为训练投影层的多任务监督信号;在特征紧凑聚合任务中,通过最小化正常样本特征嵌入之间的距离,指导投影层将正常特征紧密聚集;在异常敏感任务中,通过最小化对比度损失,提高投影层对异常敏感区域的关注. 在异常特征抑制任务中,通过最小化特征相似度损失,抑制特征传递过程中的异常特征;通过自适应融合重建模块融合投影层提取的多尺度特征,实现精确的异常检测和定位. 在多个公开数据集上开展算法的有效性验证实验. 结果表明,所提算法在MVTec数据集上的图像级接受者特性曲线下面积(AUROC)为99.3%.

关键词: 异常检测 ; 动态扩散 ; 多任务对比约束 ; 多尺度特征融合 ; 无监督学习

Abstract

A multi-task, contrastive-constraint-based algorithm was proposed to address the challenge of ambiguous boundaries between normal and anomalous features in unsupervised visual anomaly detection. First, highly realistic anomalous images were generated by a controllable anomaly synthesis module and used as multi-task supervisory signals to train the projection layer. Second, in the feature compactness aggregation task, the distances between normal sample feature embeddings were minimized to guide the projection layer toward a compact representation of normal features. In the anomaly sensitivity task, contrastive loss was minimized to increase the projection layer’s focus on anomaly-sensitive regions. In the anomaly feature suppression task, feature similarity loss was minimized to suppress anomalous features during feature propagation. Finally, multi-scale features extracted by the projection layer were fused by an adaptive fusion reconstruction module to enable accurate anomaly detection and localization. Effectiveness validation experiments were performed on multiple public datasets for the proposed algorithm. Results showed that the proposed algorithm achieved an image-level area under the receiver operating characteristic curve (AUROC) of 99.3% on the MVTec dataset.

Keywords: anomaly detection ; dynamic diffusion ; multi-task contrastive constraint ; multi-scale feature fusion ; unsupervised learning

PDF (3832KB) 元数据 多维度评价 相关文章 导出 EndNote| Ris| Bibtex  收藏本文

本文引用格式

刘宇轩, 苏恩祈, 井佩光, 孙宏博, 苏育挺. 基于多任务对比约束与可控缺陷生成的异常检测算法. 浙江大学学报(工学版)[J], 2026, 60(11): 2442-2452 doi:10.3785/j.issn.1008-973X.2026.11.013

LIU Yuxuan, SU Enqi, JING Peiguang, SUN Hongbo, SU Yuting. Anomaly detection algorithm based on multi-task contrastive constraints and controllable anomaly synthesis. Journal of Zhejiang University(Engineering Science)[J], 2026, 60(11): 2442-2452 doi:10.3785/j.issn.1008-973X.2026.11.013

视觉异常检测是异常检测中的关键任务,在质量控制、安全监控等场景中有广泛应用. 在实际应用场景中,异常样本稀缺且标注成本高,无监督方法因无需标签的优势而备受关注[1].

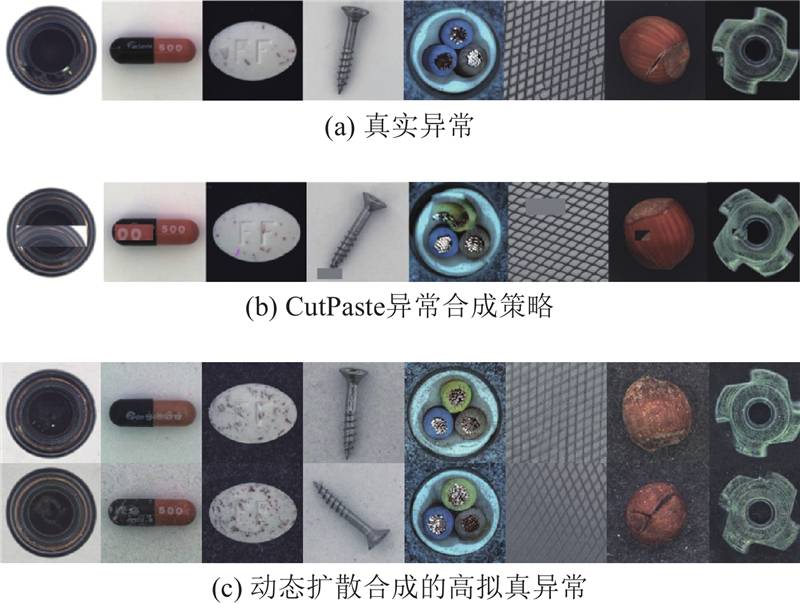
传统无监督方法缺乏有效监督信号,易将异常区域误重构为正常,影响检测可靠性. 现有无监督视觉异常检测方法大致可分为两类,一类通过构建伪异常样本引入自监督信号,另一类通过精细建模正常特征空间识别偏离正常分布的异常样本. 伪异常构建方法又可分为基于图像变换和基于异常合成的方法. 基于图像变换的方法通过定义预设的几何变换、遮挡处理等图像变换操作,构造具有类别区分度的伪标签作为监督信号,驱动模型学习正常样本的隐式特征分布. 例如,Ye等[2]提出属性擦除策略,迫使模型复原正常样本的色彩与方向属性,异常区域因无法复原而被识别;Salehi等[3]采用拼图解序任务,通过重构正常图像的语义连贯性实现异常感知. 基于异常合成的异常检测方法通过可控合成技术向正常样本注入人工异常以生成带标签的训练样本. 例如,CutPaste[4]通过剪切-粘贴图像补丁合成异常并训练单类分类器. Schlüter等[5]在CutPaste基础上引入泊松图像编辑技术以增强异常逼真度. Zavrtanik等[6]构建级联式修复-分割网络,首阶段利用Perlin噪声合成异常并进行修复,次阶段通过比对修复前后差异实现高精度分割. 基于特征建模的方法,通过特征表示、差异感知或特征拟合实现异常识别. Zhang等[7]提出稀疏特征表示框架,通过正交匹配追踪在正常特征库中重构测试样本,以高斯核距离度量异常;Cai等[8]设计差异感知框架,利用教师-学生网络生成外观无关的差异图,提升模型对合成策略的鲁棒性;Zhang等[9]基于图模型动态拟合多尺度正常特征,实现无需训练的异常定位. 尽管自监督方法在无监督异常检测中取得进展,但在生成真实、多样化的异常方面仍具挑战,尤其是难以生成复杂的结构异常和未知的新异常类别. 因缺乏异常样本与先验知识,现有方法依赖人工设计的数据增强[2-3]或外部数据[5-6]合成异常,导致合成与真实异常间存在显著分布差异,难以准确建模正常与异常的边界,限制了对细微异常的敏感性及模型泛化能力. 以扩散模型[10]为代表的系列工作能生成高拟真的图像,为高质量异常样本的可控生成提供了新思路. 如何利用扩散模型生成与自然分布紧密契合的多种类型的异常样本,成为解决异常样本合成问题的关键.

针对上述问题,本研究提出基于多任务对比约束与可控缺陷生成的异常检测算法. 1)提出可控异常生成模块(基于扩散过程的异常合成策略),仅利用正常图像生成具有不同异常强度的伪异常图像,以模仿实际异常的特征分布,且不依赖任何异常数据. 2)将正常样本特征与伪异常特征分别输入对应的投影层,通过多任务对比约束联合训练投影层. 在特征紧凑聚合任务中,通过最小化正常样本特征嵌入之间的距离,使经过投影层映射后的正常特征在嵌入空间中形成紧致分布. 在异常敏感任务和异常特征抑制任务中,在多任务训练中添加与正常训练样本同等数量的异常对比信号来最小化对比度损失和特征相似度损失,迫使网络在特征提取和传递过程中关注异常敏感区域并通过指导投影层从伪异常特征中恢复正常特征来强化区分异常的能力. 3)设计自适应融合重建模块,对投影层提取的多尺度特征进行融合,精准重建无异常的参考图像,实现异常的检测和定位.

1. 算法内容构成

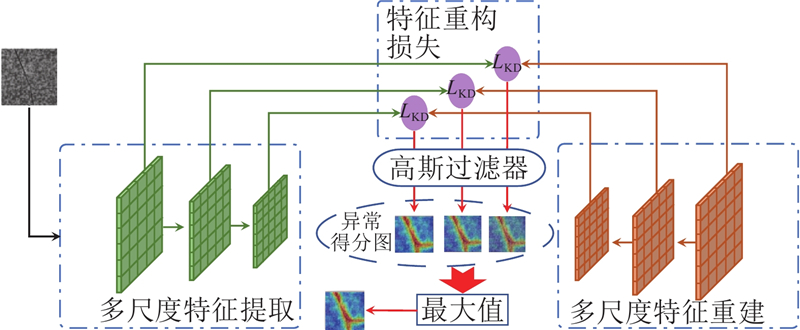
本研究所提算法架构如图1所示. 对于输入的正常图像,通过可控异常生成模块生成语义一致但包含可控扰动的伪异常图像. 原始正常图像与合成异常图像分别送入相同的主干网络提取多尺度特征张量,这两类特征随后分别进入独立的投影层进行非线性映射,形成对应的嵌入表示. 为了解决单一监督信号无法全面刻画正常与异常在特征分布、局部响应及可恢复性等方面的本质差异,在训练阶段,系统通过多任务对比约束实现特征解耦:利用自监督最优传输损失拉近正常特征间的分布距离;通过异常抑制损失从伪异常特征中恢复正常特征来提高对异常特征的抑制能力;借助带边距的对比度损失增强对异常区域的敏感性. 仅使用正常路径的多尺度投影特征,经通道分组增强与自适应融合后,输入对称解码器重建各层级正常特征. 推理时,通过计算原始特征与重建特征的余弦差异生成多尺度异常图,经上采样、累加与高斯平滑后得到像素级异常分数图,以其最大值作为图像级异常得分.

图 1
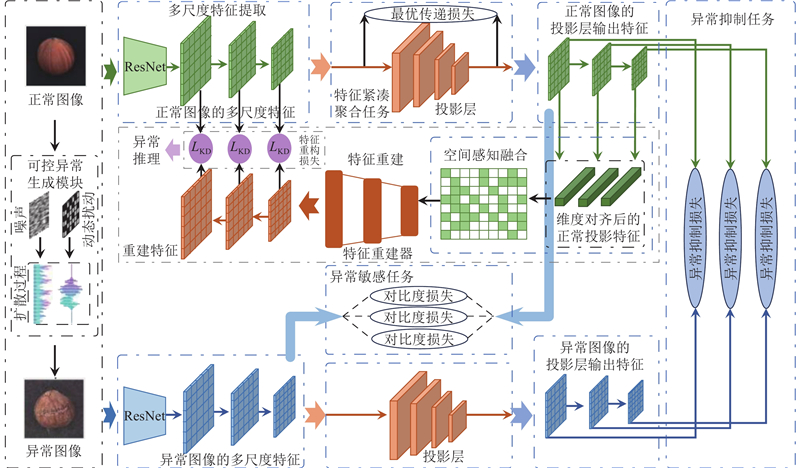
图 1   基于多任务对比约束与可控缺陷生成的异常检测算法框架

Fig.1   Framework of anomaly detection algorithm based on multi-task contrastive constraints and controllable anomaly synthesis


1.1. 可控异常生成模块

本研究提出基于动态扩散的可控异常生成模块,实现可控强度的异常合成. 该模块通过扩散模型深度建模正常样本的数据分布特征,在保持异常强度可调节性的同时,生成与真实数据分布高度吻合的多样化异常样本. 具体而言,采用去噪扩散概率模型[11]的正向扩散过程逐步将噪声$ N(0,{\boldsymbol{I}}) $添加到原始数据分布$ q({\boldsymbol{x}}_{0}) $. 在时间$ t $时,噪声数据$ {\boldsymbol{x}}_{t} $的条件概率分布公式为

$ q({\boldsymbol{x}}_{t}\mid {\boldsymbol{x}}_{t-1})=\text{N}({\boldsymbol{x}}_{t};\sqrt{1-{\beta }_{t}}{\boldsymbol{x}}_{t-1},{\beta }_{t}\boldsymbol{I}) . $

式中:$ \left\{{\beta }_{t}\right\}_{t=1}^{T} $为固定的方差调度表,$ \left\{{\boldsymbol{x}}_{t}\right\}_{t=1}^{T} $为潜在变量. 扩散过程被定义为马尔可夫链,其联合概率分布表示为$ q({\boldsymbol{x}}_{1\colon T}\mid {\boldsymbol{x}}_{0})=\prod \nolimits_{t=1}^{T}q({\boldsymbol{x}}_{t}\mid {\boldsymbol{x}}_{t-1}) $. $ {\boldsymbol{x}}_{t} $的条件概率分布为$ q({\boldsymbol{x}}_{t}\mid {\boldsymbol{x}}_{0})=\text{N}({\boldsymbol{x}}_{t};\sqrt{{\overline{\alpha }}_{t}}{\boldsymbol{x}}_{0},(1-{\overline{\alpha }}_{t})\boldsymbol{I}) $,其中$ {\alpha }_{t}=1- {\beta }_{t} $,$ {\overline{\alpha }}_{t}=\prod _{i=1}^{t}{\alpha }_{i} $. 在逆向采样过程中引入可控扰动机制,通过定向引导生成过程向潜在空间中的低概率密度区域偏移,实现对异常特征的增强重构. 逆向过程被建模为马尔可夫链,其状态转移分布由参数$ \theta $控制,定义式为

$ {p}_{\theta }({\boldsymbol{x}}_{t-1}\mid {\boldsymbol{x}}_{t})=\text{N}({\boldsymbol{x}}_{t-1};{\boldsymbol{\mu }}_{\theta }({\boldsymbol{x}}_{t},t),{\boldsymbol{\varSigma }}_{\theta }({\boldsymbol{x}}_{t},t)) . $

式中:均值函数$ {\boldsymbol{\mu }}_{\theta }({\boldsymbol{x}}_{t},t) $通过噪声预测网络$ {\boldsymbol{\varepsilon }}_{\theta }({\boldsymbol{x}}_{t},t) $建模扩散过程中的噪声分布,解析表达式为

方差项$ {{\boldsymbol{\varSigma}}}_{\theta }({\boldsymbol{x}}_{t}, t)={\beta }_{t}\boldsymbol{I} $,采用噪声调度参数$ {\beta }_{t} $进行参数化,代表逆向扩散的随机性强度. 在训练阶段,目标是最小化负对数似然的变分上界,简化的目标函数为

$ {L}_{\text{sim}}={E}_{t,\boldsymbol{\varepsilon }}\left[\| \boldsymbol{\varepsilon }-{\boldsymbol{\varepsilon }}_{\theta }({\boldsymbol{x}}_{t},t){\| }^{2}\right] . $

式中:$ \boldsymbol{\varepsilon } $为从标准高斯分布中采样的随机噪声,$ {L}_{\text{sim}} $为训练动态扩散增强模型的目标函数. 为了生成高拟真的异常图像,使用式(3)训练扩散模型来学习正常图像的分布. 在逆向扩散过程中,由$ {p}_{\theta }({\boldsymbol{x}}_{t-1}\mid {\boldsymbol{x}}_{t})=\text{N}({\boldsymbol{x}}_{t-1};{\boldsymbol{\mu }}_{\theta }({\boldsymbol{x}}_{t},t),{{\boldsymbol{\varSigma}}}_{\theta }({\boldsymbol{x}}_{t},t)) $特征化的$ {\boldsymbol{x}}_{t-1} $是在时间$ t-1 $时获得的正常图像. 由于异常图像位于靠近正常图像的低密度区域,引入额外的扰动$ s{\boldsymbol{\varSigma}} $来采样异常图像,得到$ p({{{\boldsymbol{x}}^{\prime}}}_{t-1}\mid {\boldsymbol{x}}_{t-1})=\text{N}({{{\boldsymbol{x}}^{\prime}}}_{t-1};{\boldsymbol{x}}_{t-1},s{\boldsymbol{\varSigma}}) $,其中$ {\boldsymbol{\varSigma}} $为引入的额外扰动,标量$ s $控制异常强度($ s\geqslant 0 $),$ {{{\boldsymbol{x}}^{\prime}}}_{t-1} $是在时间$ t-1 $获得的异常图像. 为了简化异常合成过程,设置$ {\boldsymbol{\varSigma}}={{\boldsymbol{\varSigma}}}_{\theta }({\boldsymbol{x}}_{t},t) $,条件概率分布写为

$ {p}_{\theta }({{{\boldsymbol{x}}^{\prime}}}_{t-1}\mid {\boldsymbol{x}}_{t})=\text{N}({{{\boldsymbol{x}}^{\prime}}}_{t-1};{\mu }_{\theta }({\boldsymbol{x}}_{t},t),(1+s){{\boldsymbol{\varSigma}}}_{\theta }({\boldsymbol{x}}_{t},t)). $

为了确保生成的异常图像接近正常图像的分布,设置$ s\rightarrow 0 $,得到$ {{{\boldsymbol{x}}^{\prime}}}_{t-1}\approx {\boldsymbol{x}}_{t-1} $;在下一次逆向扩散过程中使用$ {{{\boldsymbol{x}}^{\prime}}}_{t-1} $. 最终,$ {p}_{\theta }\left({\boldsymbol{x}}^{\prime}_{t-1}\mid {\boldsymbol{x}}^{\prime}_{t}\right)= \text{N}\left({\boldsymbol{x}}^{\prime}_{t- 1}; {\boldsymbol{\mu }}_{\theta }\left({\boldsymbol{x}}^{\prime}_{t},t\right), (1+s){\boldsymbol{\varSigma }}_{\theta }\left({\boldsymbol{x}}^{\prime}_{t},t\right)\right) $. 当$ s=0 $时,生成结果为正常图像;当$ s \gt 0 $时,采样方差增大,使生成样本更可能落入正常分布之外的区域,形成具备异常特征的图像. 随着逆向扩散的进行,该可控异常生成模块在每一步根据式(4)迭代采样,逐步生成可调强度的异常图像. 该可控扰动机制能够在保持图像分布真实性的同时,实现对异常程度的灵活控制.

1.2. 多任务对比约束模型

多任务对比约束提取多尺度特征并输入投影层. 本研究将预训练的WideResNet-50-2 [12]作为特征提取的主干网络,提取输入图像的多尺度表征. 该架构在丰富语义特征提取方面的有效性已被验证[13]. 特征提取器提取训练样本$ \boldsymbol{X} $在特征提取器第$ k $块的特征输出$ {\boldsymbol{F}}_{k}\,(k=1,2,\cdots,K) $,表达式为

$ {\boldsymbol{F}}_{k}={E}_{k}\left(\boldsymbol{X}\right)\in {{R}}^{\,{{c}_{k}}\times {{h}_{k}}\times {{w}_{k}}} . $

式中:$ {E}_{k}(\cdot ) $为第$ k $个特征提取器网络,该特征提取网络为预训练的WideResNet-50;$ {c}_{k}、{h}_{k} $和${w}_{k} $分别为第$ k $个特征提取器网络提取的张量的通道数、高度和宽度. 对于采用可控异常生成模块产生的高拟真异常的样本$ \xi (\boldsymbol{X}) $,在特征提取器第$ k $块的特征输出$ {{\tilde{\boldsymbol{F}}}}_{k} (k=1,2,\cdots,K) $表达式为

$ {{\tilde{\boldsymbol{F}}}}_{k}={E}_{k}\left(\xi \left(\boldsymbol{X}\right)\right)\in {{R}}^{\,{{c}_{k}}\times {{h}_{k}}\times {{w}_{k}}} . $

在每个提取的特征之后直接集成一个投影层,投影层由4层的卷积、二维实例归一化和激活函数组成,第$ k $块特征提取器对应的投影层表示为$ {\mathit{\Phi }}_{k} $.

在本研究中,“多任务”不是传统多任务学习中对多个独立预测任务的联合优化,而是在无监督异常检测框架下设计的3个自监督代理任务. 这些任务共享同一特征主干,但采用独立的投影层处理正常与伪异常特征,分别从正常特征紧密聚集、异常特征抑制与局部异常敏感性这3个互补维度施加约束,共同构成多任务对比约束机制. 多任务损失包括3个组成部分:1)特征紧凑聚合任务的自监督最优传输损失$ {L}_{\text{S}} $,用于学习正常样本之间的紧凑特征表示;2)异常特征抑制任务的特征相似度损失$ {L}_{\text{R}} $,用于从伪异常特征中恢复正常特征来提高对异常特征的抑制能力;3)异常特征敏感任务的对比损失$ {L}_{\text{C}} $,迫使网络在特征提取和传递过程中关注异常敏感区域.

1.2.1. 自监督最优传输

损失投影层从各自对应的特征提取网络中接收正常特征,并有意地将它们投影到紧凑的特征空间中. 该任务旨在通过最小化正常样本特征嵌入之间的距离确保来自正常样本的投影特征表示彼此接近. 为此,采用去偏Sinkhorn距离作为最小化特征嵌入分布距离的度量准则. 去偏Sinkhorn距离是最优传输距离的变体,其距离测度允许计算2个特征空间分布之间的空间差异. 给定源域与目标域概率分布$ {\boldsymbol{\alpha}} $和$ {\boldsymbol{\beta}} $,令$ \boldsymbol{\pi }\in \Pi \left(\boldsymbol{\alpha },\boldsymbol{\beta }\right) $为传输计划矩阵,$ \boldsymbol{C} $为基础传输成本矩阵,则最优传输距离$ {\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\beta }\right) $的原始问题定义为

式中:$ \varepsilon \gt 0 $为熵正则化系数,$ \rho \gt 0 $为边际惩罚系数,$ f $与$ g $为对偶势函数,$ \otimes $为向量外积运算,$ \langle \cdot \rangle $为对偶运算;$ \text{KL} $为Kullback-Leibler散度[14],定义式为

$ \text{KL}\left(\boldsymbol{\alpha },\boldsymbol{\beta }\right)=\left\langle \boldsymbol{\alpha },\ln \left(\frac{\text{d}\boldsymbol{\alpha }}{\text{d}\boldsymbol{\beta }}\right)\right\rangle -\left\langle \boldsymbol{\alpha },\mathbf{1}\right\rangle+\left\langle \boldsymbol{\beta },\mathbf{1}\right\rangle \geqslant 0 . $

为了消除传统Sinkhorn算法因熵正则化导致的边缘分布偏差,引入去偏Sinkhorn距离作为修正度量:

$ \begin{split} &{S}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\beta }\right)={\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\beta }\right)-\frac{{1}}{2}{\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\alpha }\right)-\\&\qquad \frac{1}{2}{\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\beta },\boldsymbol{\beta }\right)+\frac{\varepsilon }{2}||\left\langle \boldsymbol{\alpha },\mathbf{1}\right\rangle -\left\langle \boldsymbol{\beta },\mathbf{1}\right\rangle |{|}^{2}.\end{split} $

式中:跨域传输项$ {\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\beta }\right) $通过刻画分布间特征对齐成本,实现跨域传输代价最小化;自传输项$ {\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\alpha },\boldsymbol{\alpha }\right) $和$ {\text{OT}}_{\varepsilon ,\rho }\left(\boldsymbol{\beta },\boldsymbol{\beta }\right) $通过消除域内特征冗余偏移,实现域内分布自洽性约束;末项为补偿$ \boldsymbol{\alpha } $与$ \boldsymbol{\beta } $的非平衡性偏差. 在上述问题基础上,对于$ {\boldsymbol{F}}_{k}(k= 1,2,\cdots,K) $为训练样本$ \boldsymbol{X} $在特征提取器第$ k $块的特征输出,$ {\mathit{\Phi }}_{k} $为第$ k $块特征提取器对应的第$ k $块的投影层,$ \sigma $为softmax函数,提出自监督最优传输损失公式:

$ {L}_{\text{S}} = \frac{1}{m}\sum \limits_{i=1}^{m}\sum \limits_{j=1}^{m}\sum \limits_{k=1}^{K}{S}_{\varepsilon ,\rho }\left(\sigma \left({\mathit{\Phi }}_{k}\left({\boldsymbol{F}}_{i,k}\right)\right) , \sigma \left({\mathit{\Phi }}_{k}\left({{\tilde{\boldsymbol{F}}}}_{j,k}\right)\right)\right). $

式中:$ {\boldsymbol{F}}_{i,k} $为第$ i $个输入样本的第$ k $个特征.

1.2.2. 异常相似度损失

$ {{\boldsymbol{F}}}_{k}, {\tilde{{\boldsymbol{F}}}}_{k} $分别为正常图像$ \boldsymbol{X} $和高拟真异常图像$ \xi (\boldsymbol{X}) $的编码器块$ k $的特征输出. 在异常特征抑制任务中,须利用余弦相似度损失函数训练投影层,通过优化此学习目标,对比$ {\boldsymbol{F}}_{k} $与$ {{\tilde{\boldsymbol{F}}}}_{k} $的特征相似度,模拟投影层从异常特征中恢复正常特征的过程来提高对异常特征的抑制能力. 异常相似度损失定义如下:

$ {L}_{\text{R}}=\frac{1}{K}\sum \limits_{k=1}^{K}(1-\cos\; ({\mathit{\Phi }}_{k}({\boldsymbol{F}}_{k}),{\mathit{\Phi }}_{k}({{\tilde{\boldsymbol{F}}}}_{k}))) . $

式中:$ K $为特征的总层数. 在训练过程中,通过高拟真异常输入图像向特征空间注入异常信号,鼓励投影层学习如何从伪异常区域中重构正常特征,优化这一学习目标能够加速投影层在推理过程中抑制异常信息的能力.

1.2.3. 异常敏感损失

为了强化投影层对异常特征的敏感度,使用带有边距$ \mu $的嵌入损失将异常信息从投影的正常特征空间中分离:

$ {L}_{\text{C}}=\frac{1}{K}\sum \limits_{k=1}^{K}\max (0, \cos\; ({\mathit{\Phi }}_{k}({{\tilde{\boldsymbol{F}}}}_{k}),{{\tilde{\boldsymbol{F}}}}_{k})-\mu ) . $

式中:$ \mu \in [0,1] $用于约束异常投影与原始异常特征的相似性上限,若相似度超过$ \mu $,则产生损失,迫使网络在特征提取和传递过程中关注异常敏感区域.

1.3. 自适应融合重建模块

自适应融合重建模块通过自适应特征聚合机制融合$ \left\{{\mathit{\Phi }}_{k}\right\} $,并将融合后的特征输入重构器$ D $进行多尺度重建,输出重建特征$ \left\{{\textit{g}}_{k}\right\}_{k=1}^{3} $. 将正常特征的多尺度投影输出$ {\mathit{\Phi }}_{1}、{\mathit{\Phi }}_{2} $和${\mathit{\Phi }}_{3} $维度对齐并进行拼接,得到特征图$ \boldsymbol{M}\in {{R}}^{{{c}_{m}}\times {{h}_{m}}\times {{w}_{m}}} $. $ \boldsymbol{M} $会被划分为$ n $个子通道组,对各子通道组进行多尺度特征增强,每个子通道组的维度为$ {c}_{m}/n $,采用全局平均池化来提取通道注意力信息,利用卷积层进行特征压缩和恢复. 设$ {\boldsymbol{M}}_{i} $为第$ i $个通道组的特征,

$ {\boldsymbol{S}}_{i}=\mathrm{Sigmoid}\left({\mathrm{Conv}}_{1\times 1}\left(\mathrm{GAP}\left({\boldsymbol{M}}_{i}\right)\right)\right)\otimes {\boldsymbol{M}}_{i} . $

式中:$ \text{GAP}(\cdot ) $为全局平均池化,$ {\text{Conv}}_{1\times 1}(\cdot ) $为$ 1\times 1 $卷积层,$ {\boldsymbol{S}}_{i} $为多尺度增强特征,$ \otimes $为逐元素乘法. 将各通道组的特征$ {\boldsymbol{S}}_{i} $进行自适应特征聚合,拼接后通过$ 1\times 1 $卷积$ {\text{Conv}}_{1\times 1} $进行融合,应用高斯误差线性单元$ \text{GELU}(\cdot ) $激活并与原始输入进行逐元素乘法:

$ {\boldsymbol{F}}_{\text{O}}=\text{GELU}\left({\text{Conv}}_{1\times 1}\left(\text{Concat}\left({\boldsymbol{S}}_{i}\right)\right)\right)\otimes \boldsymbol{M} . $

式中:$ {\boldsymbol{F}}_{\text{O}}\in {{R}}^{{{c}_{m}}\times {{h}_{m}}\times {{w}_{m}}} $为融合后的特征,$ \text{Concat}(\cdot ) $为特征拼接操作. 为了重构多尺度特征,重构网络$ \text{Recove}\;(\cdot ) $被设计成与特征提取网络对称但相反的结构,由通过反卷积层构建的对称残差解码块组成,成对激活对应关系定义如下:

$ \left.\begin{array}{l}{\boldsymbol{G}}_{3}=\text{Recove}\;({\boldsymbol{F}}_{\text{O}}),\\{\boldsymbol{G}}_{2}=\text{Recove}\;({\boldsymbol{G}}_{3}),\\{\boldsymbol{G}}_{1}=\text{Recove}\;({\boldsymbol{G}}_{2}).\end{array}\right\} $

特征重建器采用特征重建损失不断优化重建能力,特征重建损失${L}_{\text{KD}} $通过计算特征重建器$ \text{Recove}\;(\cdot ) $的输出特征$ {\boldsymbol{G}}_{k} $与正常图像特征提取器的输出特征$ {\boldsymbol{F}}_{k} $的余弦相似度实现,表达式为

$ {L}_{\text{KD}}=\frac{1}{K}\sum \limits_{k=1}^{K}\left[1-\cos \left({\boldsymbol{F}}_{k},{\boldsymbol{G}}_{k}\right)\right] . $

1.4. 训练与异常推理过程

多任务优化框架通过协同训练机制实现特征解耦与异常表征学习,单个训练周期包含以下关键步骤:1)特征提取器$ E $分别处理正常样本$ \boldsymbol{X} $及其高拟真异常变体$ \xi (\boldsymbol{X}) $,生成多尺度特征块$ \left\{{\boldsymbol{F}}_{k}\right\}_{k=1}^{3} $和$ \left\{{{\tilde{\boldsymbol{F}}}}_{k}\right\}_{k=1}^{3} $. 2)3层独立投影网络$ \left\{{\mathit{\Phi }}_{k}\right\}_{k=1}^{3} $对正常特征进行非线性映射,产生解耦后的特征表示$ {\mathit{\Phi }}_{k}\left({\boldsymbol{F}}_{k}\right) $,同时对异常特征执行同步投影得到$ {\mathit{\tilde{\mathit{\Phi }}}}_{k}({{\tilde{\boldsymbol{F}}}}_{k}) $. 自适应融合重建模块通过多尺度特征增强和自适应特征聚合机制融合$ \left\{{\mathit{\Phi }}_{k}\right\} $,并将融合后的特征输入重构器$ D $进行多尺度重建,输出重建特征$ \left\{{\boldsymbol{G}}_{k}\right\}_{k=1}^{3} $. 训练的总损失表达式为

$ L={L}_{\text{KD}}+\alpha {L}_{\text{S}}+\beta {L}_{\text{R}}+\gamma {L}_{\text{C}}. $

式中:$ \alpha $、$ \beta $和$ \gamma $均为权重因子. 在测试阶段,对于带有异常的图片,特征提取器从输入样本中提取的多尺度特征表示包含正常模式的信息,也可能携带异常信息. 当输入样本存在异常时,特征提取器能够捕捉到这种异常性. 通过多任务对比约束处理,特征重建器学习重构正常的特征模板. 这意味着,即使输入样本含有异常,重建器也只能生成与正常样本相匹配的特征表示. 本研究基于特征提取器与特征重建器输出的余弦相似性度量,构建特征重构损失函数,以约束异常样本的重建特征向正常特征空间对齐. 当输入样本正常时,两者的特征表示应高度相似;反之,若样本异常,则相似度会显著降低. 因此,低相似度值可作为异常检测的依据. 如图2所示,本研究提出的异常检测方法通过特征重构差异实现像素级异常定位. 给定输入样本$ x $,特征提取器$ E $生成多尺度异常特征$ {\boldsymbol{F}}_{k} $,其中$ k $为特征层级数. 特征重建器$ D $通过多任务优化约束生成规范化特征$ {\boldsymbol{G}}_{k} $. 为了计算异常分数,计算$ {\boldsymbol{F}}_{k} $和$ {\boldsymbol{G}}_{k} $沿通道轴的余弦相似度,并得到如下2D异常图:

图 2

图 2   异常推理过程示意图

Fig.2   Schematic diagram of anomaly inference process


$ {\boldsymbol{A}}_{k}(h,w)=1-\frac{{\left[{\boldsymbol{F}}_{k}(h,w)\right]}^{\text{T}}\cdot {\boldsymbol{G}}_{k}(h,w)}{{\left|\left|{\boldsymbol{F}}_{k}(h,w)\right|\right|}_{\text{F}}{\left|\left|{\boldsymbol{G}}_{k}(h,w)\right|\right|}_{\text{F}}} . $

式中:$ {\boldsymbol{A}}_{k}\in {{R}}^{{{h}_{k}}\times {{w}_{k}}} $反映第$ k $层特征张量的逐点异常情况. 考虑到多尺度特征的使用,通过累积多尺度异常图来获得优化的标量损失函数:

$ {L}_{\text{MS}}=\sum \limits_{k=1}^{L}\left\{\frac{1}{{h}_{k}\times {w}_{k}}\sum \limits_{h=1}^{{h}_{k}}\sum \limits_{w=1}^{{w}_{k}}{\boldsymbol{A}}_{k}(h,w)\right\} . $

为了定位图像中的异常,将$ {{\boldsymbol{A}}}_{k} $上采样到图像大小,再将$ L $层异常图进行像素级累加,形成精确的得分图;使用高斯卷积$ {\text{Conv}}_{\text{gaus}}(\cdot ) $平滑得分图以去除噪声:

$ {\boldsymbol{A}}_{{\mathrm{p}}}={\text{Conv}}_{\text{gaus}}\left(\sum \limits_{k=1}^{L}\mathit{\Phi }\left({\boldsymbol{A}}_{k}\right)\right) . $

式中:$ {\boldsymbol{A}}_{{\mathrm{p}}}\in {{R}}^{m\times n} $为优化的精确异常分数图,$ \mathit{\Phi }(\cdot ) $为上采样操作. 对于具有异常区域的样品,简单地对分数图中的所有值进行平均是不公平的,原因是这可能会掩盖掉局部的异常响应. 为此,引入最大响应点的概念:任何规模的异常区域都应在分数图中产生最大的响应点. 基于此,将样本异常定位(sample anomaly localization, SAL)中的最大值定义为样本级异常得分. 最终,将$ {\boldsymbol{A}}_{{\mathrm{p}}} $的最大值定义为整个图像的异常分数$ {S}_{\text{AD}} $:

$ {S}_{\text{AD}}=\underset{i,j}{\max }\left({\boldsymbol{A}}_{{\mathrm{p}}}(i,j)\right) . $

2. 实验设置及结果分析

2.1. 实验设置

本研究提出的异常检测方法的数据集图像尺寸为256×256,不施加数据增强. 这些图像设置被广泛用作异常检测方法对比的标准配置. 使用Adam优化器,学习率设为0.005,自监督损失、对比损失和重构损失的权重因子$ \alpha $、$ \beta $和$ \gamma $分别设置为0.2、0.02和0.002,动态扩散的异常强度$ s $均匀采样在0.1~0.2. 所提异常检测模型通过Pytorch实现,实验环境为GTX 3070Ti, i9-12900H和16 GB内存. 根据在异常检测和定位方面的前期工作,采用基于生成异常分数计算的接收者特性曲线下面积(area under the receiver operating characteristic curve,AUROC)和区域重叠率曲线下面积(area under the per-region overlap curve,AUPRO)来评估异常检测和定位的性能. 其中图像级异常判别AUROCI评估图像级异常检测性能,像素级定位精度AUROCP和AUPRO评估异常定位性能.

2.2. 视觉异常数据集

在视觉异常检测领域,基于MVTec[15]和BTAD[16]这2个主流工业数据集开展实验. 所提方法在处理以局部结构或纹理缺陷为主导的异常时表现出显著优势,契合这2个数据集中异常样本的共性规律,展现出良好的适用性与有效性. MVTec包含5 354张高分辨率图像(700 像素×700像素~1 024像素×1 024像素),覆盖15个类别(5类工业纹理与10类工业制品),其中训练集含3 629张正常样本,测试集由1 725张正常与异常样本组成. 该数据集在高分辨率细节、低对比度背景、异常形态的真实性以及多视角采集等方面凸显了工业场景下异常检测的挑战性. BTAD是用于实例分割、语义分割、目标检测和半监督学习任务的数据集,共包含2 540张RGB图像,覆盖3种不同产品,其中691个样本带有像素级异常掩膜. 这3类产品图像分辨率分别为1 600像素×1 600像素、600像素×600像素和800像素×600像素,对应的训练集规模为400、1 000和399张,所有图像在训练前统一缩放至512像素.

2.3. 评估指标

采用三级评估体系对算法性能进行量化分析. 该评估框架遵循现有研究公认的检测标准,从图像级异常判别、像素级定位精度和区域级重叠度这3个维度建立综合评价指标.

图像级异常检测性能通过AUROCI进行量化. 对于包含N个测试样本的数据集,给定模型输出的异常分数$ {s}_{i}\in {{R}}^{+} $:

$ \text{AUROC}_{\mathrm{I}}=\int \nolimits_{0}^{1}\text{TPR}({\mathrm{FPR}}) {\text{d}(\text{FPR})} . $

式中:$ t\in [0,1] $为决策阈值;$ \text{TPR}(t)=P({s}_{i}\geqslant t|{y}_{i}=1) $ 为真实异常样本的检出率,正常样本的误报率为$ \text{FPR}(t)=P({s}_{i}\geqslant t|{y}_{i}=0) $,该指标值域为$ [0,1] $.

AUROCP将异常定位结果视为像素二分类问题,通过对比预测热力图$ H(x,y)\in {\bf{R}}^{w\times h} $与真实掩膜$ M(x,y)\in {{R}}^{w\times h} $,

$ \text{AUROC}_{\mathrm{P}}=\frac{1}{w\times h}\sum \limits_{x=1}^{w}\sum \limits_{y=1}^{h}\delta (H(x,y),M(x,y)). $

式中:$ \delta (\cdot ) $为基于阈值$ t $的指示函数.

针对视觉异常检测中常见的多尺度异常特性,引入AUPRO曲线积分方法,该指标赋予小尺寸异常更高权重,有效避免传统指标对大面积异常的评估偏好.

$ \text{AUPRO}=\frac{1}{T}\sum \limits_{k=1}^{T}\frac{|\widehat{{R}_{k}}\cap {R}_{k}|}{|{R}_{k}|} . $

式中:$ {R}_{k}\in {R} $为第$ k $个异常区域,$ T $为异常区域总数,$ \widehat{{R}_{k}} $为预测区域.

AUROCI反映模型对异常样本的全局判别能力,但对定位精度不敏感. AUROCP侧重像素级定位准确性,评估异常区域的空间识别精度. AUPRO通过区域加权机制,计算预测区域与真实掩膜的重叠度,重点考察小尺寸异常的检测鲁棒性,三者构成互补评估体系.

2.4. 对比实验与分析

将所提算法与几种先进的方法进行性能比较,包括PSVDD[17]、RIAD[18]、SPADE[19]、PaDiM[13]、RD4AD[20]、NIGSF[21]、PatchCore[22]、ATSN[23]和AWSSA-UNet[24].

在MVTec数据集上进行异常检测与异常定位,不同算法在各品类及整体平均值上的AUROCI与AUROCP定量结果分别如表1和表2所示. 可以看出,所提算法在整体性能上展现出明显优势:AUROCI平均值为99.3%,AUROCP平均值为98.3%,显著优于RD4AD、ATSN、PSVDD、RIAD等对比方法,验证了模型的有效性与泛化性. 在图像级异常判别中,在多个品类中的AUROCI达到100%,表明所提算法在这些场景下能完美区分正常与异常样本,优于对比方法PSVDD和RIAD. 即使在部分难度较高的品类中,所提算法仍超越多数对比方法,并在多数品类中AUROCI最大,且平均值领先,提升了异常检测的精度. 在像素级定位中,所提算法在多个品类中取得最大值,体现了该算法对纹理和复杂形状物体异常的精准定位能力. 即便在小尺寸、精细结构类别(如晶体管)中,该算法仍显著优于RIAD和NIGSF,体现了细粒度异常捕捉能力.

表 1   不同算法在MVTec数据集中的图像级异常检测结果

Tab.1  Image-level anomaly detection results of different algorithms on MVTec dataset

类别AUROCI/%
PSVDDRIADPaDiMRD4ADATSNNIGSF本研究
地毯92.984.299.898.999.896.5100
铁丝网94.699.696.710099.9100100
皮革90.9100100100100100100
砖瓦97.898.798.199.398.810099.9
木头96.593.099.299.299.699.799.5
瓶子98.699.999.910010096.0100
电缆90.381.992.795.010085.699.2
胶囊76.788.491.396.396.893.997.5
榛子92.083.392.099.910099.8100
金属94.088.598.710098.799.7100
药丸86.183.893.396.696.797.298.2
螺丝钉81.384.585.897.096.886.698.6
牙刷10010096.199.593.1100100
晶体管91.590.997.496.798.395.398.8
拉链97.998.190.398.598.299.698.4
平均值92.191.795.598.598.496.799.3

新窗口打开| 下载CSV


表 2   不同算法在MVTec数据集中的像素级异常检测结果

Tab.2  Pixel-level anomaly detection results of different algorithms on MVTec dataset

类别AUROCP/%
PSVDDRIADPaDiMRD4ADATSNNIGSF本研究
地毯92.696.399.198.999.197.499.2
铁丝网96.298.897.399.399.099.299.3
皮革97.499.499.299.499.498.999.5
砖瓦91.489.194.195.695.099.796.6
木头90.885.894.995.394.897.396.1
瓶子98.198.498.398.798.896.398.8
电缆96.884.296.797.498.093.398.5
胶囊95.892.898.598.798.697.498.7
榛子97.596.198.298.998.999.599.2
金属98.092.597.297.396.099.598.1
药丸95.195.795.798.298.099.598.4
螺丝钉95.798.898.599.699.197.299.6
牙刷98.198.998.899.198.999.699.1
晶体管97.087.797.592.594.584.794.8
拉链95.197.898.598.298.398.298.5
平均值95.794.297.597.897.897.298.3

新窗口打开| 下载CSV


不同算法在MVTec数据集上基于AUPRO指标的异常定位结果如表3所示. AUPRO对小范围异常检测更具挑战性,可以看出,所提算法AUPRO平均值为95.0%,位居榜首. 所提算法在纹理类(如地毯、铁丝网、皮革)及规则物体、精密零件(如胶囊、螺丝钉)中均表现出色,优于PSVDD和RIAD. 这表明在小范围异常定位这一高难度任务中,所提算法能更精准捕捉异常区域,验证了算法对复杂异常检测场景的适应性与优越性.

表 3   不同算法在MVTec数据集中的区域级异常检测结果

Tab.3  Region-level anomaly detection results of different algorithms on MVTec dataset

类别AUPRO/%
PSVDDRIADPaDiMRD4ADATSNNIGSF本研究
地毯86.561.496.297.097.370.597.7
铁丝网84.036.494.697.697.266.997.7
皮革75.749.197.899.199.173.299.2
砖瓦92.552.686.090.688.897.292.5
木头81.638.291.190.992.484.493.5
瓶子80.576.494.896.696.481.596.9
电缆84.024.488.891.092.762.094.3
胶囊86.238.293.595.895.751.695.7
榛子84.733.892.695.595.183.796.3
金属84.064.385.692.388.496.892.3
药丸82.551.692.796.496.193.297.0
螺丝钉85.943.994.498.296.643.898.5
牙刷83.950.693.194.593.294.294.5
晶体管50.339.284.578.083.940.183.2
拉链16.963.495.995.495.083.295.8
平均值77.348.292.193.993.974.895.0

新窗口打开| 下载CSV


不同算法在BTAD数据集上的AUROCI与AUROCP如表4所示. BTAD数据集作为更具挑战性的测试场景,对方法的鲁棒性与精度提出更高要求. BTAD包含3类匿名工业产品:Class 01、Class 02和Class 03. Class 01和Class 03为具有环形结构的工业部件,Class 02为具有纵向纹理的平面工业产品. 所提算法平衡了检测与定位精度,在综合性能上实现了突破,AUROCI平均值为96.7%,AUROCP平均值为97.4%,均领先于对比方法,尤其在Class 03中展现出卓越性能. 整体结果表明,所提算法对复杂、多样化的异常场景具有更强的鲁棒性,进一步印证了研究方法的创新性与实用性.

表 4   不同算法在BTAD数据集中的图像级和像素级异常检测结果

Tab.4  Image-level and pixel-level anomaly detection results of different algorithms on BTAD dataset

算法AUROCI/%AUROCP/%
Class 01Class 02Class 03平均值Class 01Class 02Class 03平均值
VT-ADL99.094.077.090.097.671.082.683.7
P-SVDD91.693.691.092.195.772.182.183.3
FastFlow99.482.491.190.997.193.698.396.3
PatchCore95.594.799.396.590.979.399.890.0
CFA98.185.599.094.295.996.098.696.8
AWSSA-UNet93.391.999.094.710082.099.893.9
本研究96.593.999.796.796.296.499.797.4

新窗口打开| 下载CSV


2.5. 收敛性分析

对所提算法进行收敛性分析,重点关注MVTec数据集中的“地毯”类别,算法训练过程中的收敛曲线如图3所示. 结果表明,3项性能指标曲线均呈上升态势,初期上升斜率较大,此时模型快速学习数据特征,性能显著提升;后期趋于平缓,说明模型在像素级异常定位、图像级异常检测及小范围异常检测任务上的性能逐步饱和,能够稳定输出高精度结果,验证了算法对异常检测任务的有效建模能力. 训练的总损失曲线呈现持续下降趋势,前期下降速率快,后期趋于平稳并维持在较低水平. 这表明训练过程中模型参数不断优化,对数据特征的学习愈发精准,最终实现有效收敛,确保模型仍能保持优异的异常检测与定位性能,并且其余类别的收敛行为与此基本一致,整体趋势稳定. 综上,性能指标的提升与损失的下降相互佐证,表明了模型参数优化的合理性,也证实了算法在异常检测与定位任务中学习特征、提升精度的有效性.

图 3
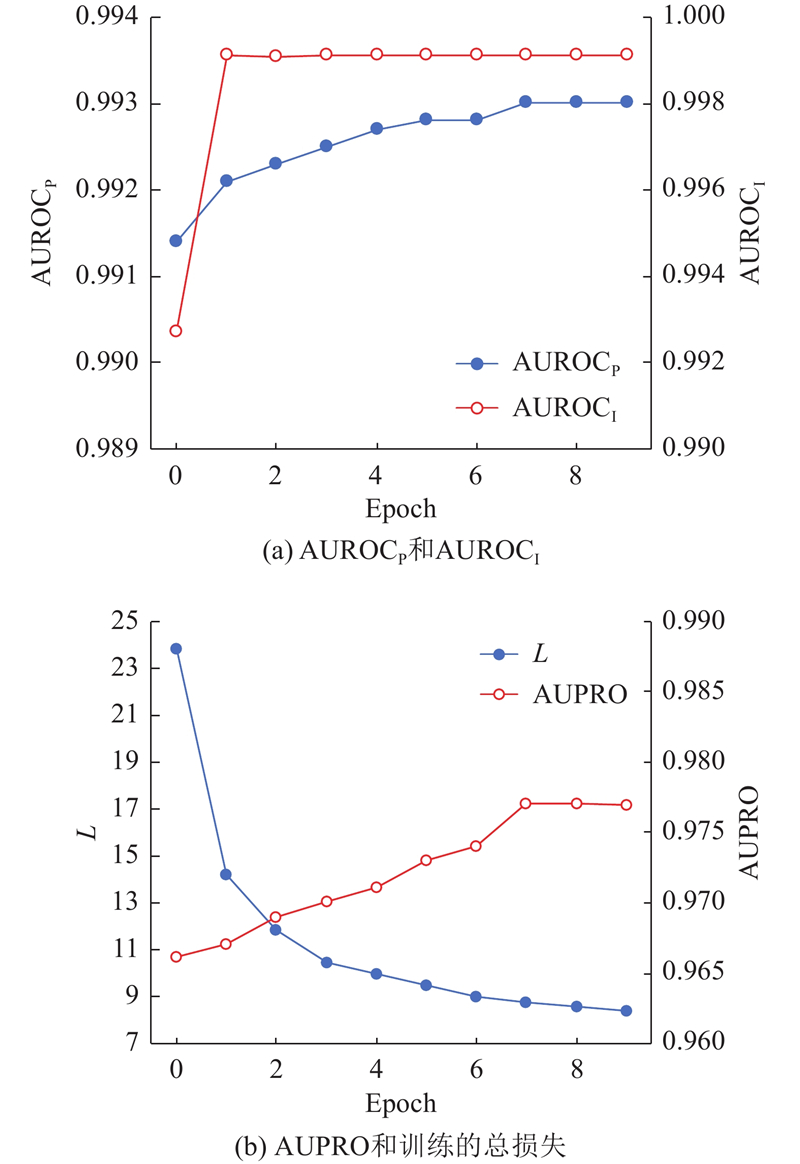
图 3   性能指标的收敛曲线

Fig.3   Convergence curves of performance metric


2.6. 可视化分析

如图4所示为不同异常合成方法生成的异常图像. 图4(c)为可控异常生成模块生成的图像,在异常特征的表现上与真实异常样本的相似性显著,在异常区域的形态轮廓、纹理细节以及分布上均高度复现了实际场景中真实异常的典型特征. 这一结果有力印证了可控异常生成模块的技术优势:通过对真实异常关键特征的深度挖掘,生成逼近真实的异常样本. 上述伪异常样本将助力模型在学习过程中精准捕获异常特征模式,提升模型对真实异常的检测与定位精度.

图 4

图 4   不同异常合成方法的图像对比

Fig.4   Image comparison of different anomaly synthesis methods


如图5所示为异常样本图像、模型生成的异常概率分布图谱和像素级真值标注组成的三级对比结构,直观展示了所提算法在MVTec数据集上的异常定位效果,对模型检测效果进行了验证. 该可视化图包含3个部分:首层选取如金属零部件和纤维制品的典型工业产品的异常样本,覆盖材料属性和形态特征的多样性;中间层呈现基于本研究的异常概率分布图谱,采用红-蓝渐变色阶表征区域异常程度;底层叠加实验数据集提供的像素级真值标注,通过二值化掩膜精确标定异常边界. 对比结果表明,本研究构建的异常检测模型能够准确定位孔洞、裂纹、形变等复杂异常形态,其热力分布图与标注真值具有高度空间一致性. 特别在跨品类适应性方面,模型对织物纹理异常与金属表面瑕疵均保持稳定检测能力,展现出优异的跨类别泛化性能. 综上,所提算法提升了对各数据类别异常区域的检测能力,体现出良好的泛化性与检测准确性.

图 5
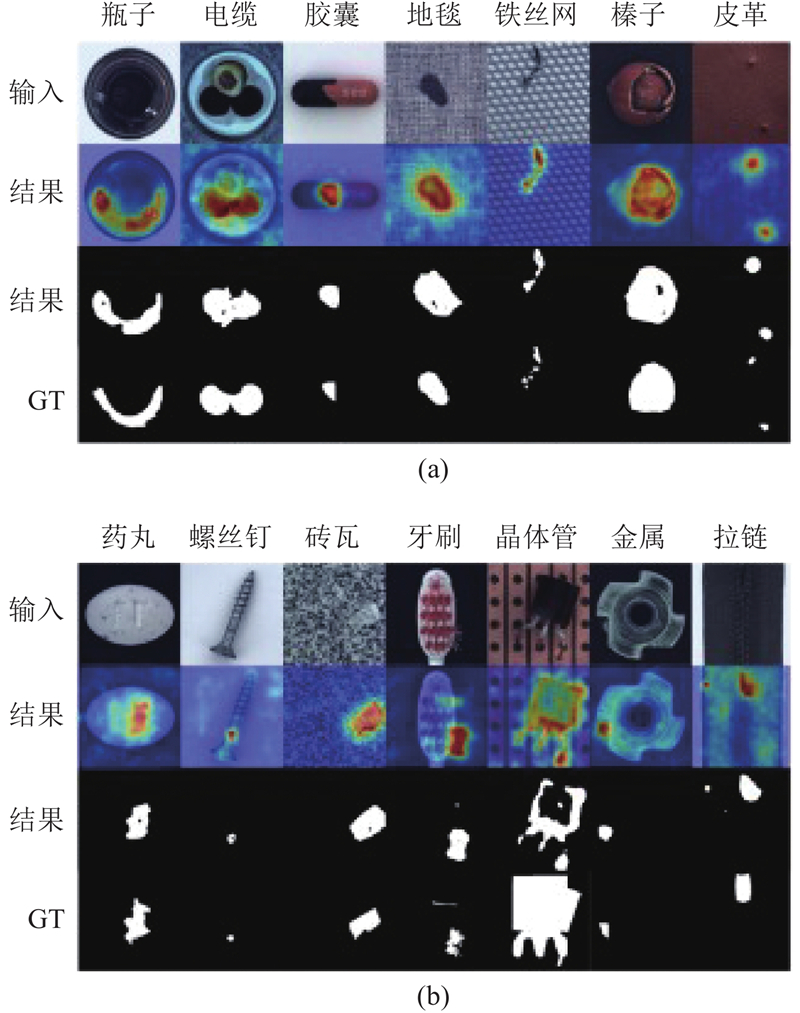
图 5   所提算法在MVTec数据集上的异常定位可视化结果

Fig.5   Anomaly localization visualization results of proposed algorithm on MVTec dataset


2.7. 消融实验

对训练组件的有效性展开探究,不同目标训练组合的性能表现如表5所示. 为了验证可控异常生成模块的有效性,设置与CutPaste异常合成策略的对比实验. 结果显示,AUROCI、AUROCP及AUPRO分别提高了0.4、0.3与0.4个百分点. 这说明可控异常生成模块生成的异常特征在全局分布上更贴近真实异常,减少了CutPaste因几何形变导致的干扰,同时在边界过渡上更平滑,避免了CutPaste策略中硬性粘贴导致的边缘伪影,使算法能够更准确地学习异常区域的局部纹理特征. 为了验证多任务对比约束模块和自适应融合重建模块(adaptive fusion and reconstruction nodule,AFRM)的有效性,将仅采用基础特征重建损失$ {L}_{\text{KD}} $训练的基础网络定义为基线模型. 在保持其余实验设置一致的条件下,依次对最优传输损失、异常相似度损失、异常敏感损失、AFRM进行联合训练. 实验结果表明,多任务联合训练在3项性能指标上均有提升. 在特征紧凑聚合任务中,投影层将正常特征紧密聚集,使其在嵌入空间中形成紧致的分布. 在异常抑制任务中,投影层从伪异常特征中恢复正常特征,强化对异常特征的抑制能力. 在异常敏感任务中,网络在特征提取与传递过程中聚焦异常敏感区域. 全任务联合训练在AUROCI、AUROCP与AUPRO上较基线分别提高了0.8、0.5与1.1个百分点,验证了多任务约束对异常与正常特征解耦的促进作用. 此外,AFRM利用多尺度特征增强和注意力机制优化特征表示,最终输出高质量重建特征来提升算法性能.

表 5   在MVTec数据集上不同训练目标组合的性能表现

Tab.5  Performance of different training objective combinations on MVTec dataset

目标训练组合AUROCI/%AUROCP/%AUPRO/%
可控异常生成策略99.398.395.0
CutPaste 异常合成策略98.998.094.6
基线98.497.793.8
基线$ +{L}_{\text{S}} $99.098.194.5
基线$ +{L}_{\text{S}}+{L}_{\text{C}} $99.198.194.6
基线$ +{L}_{\text{S}}+{L}_{\text{C}}+{L}_{\text{R}} $99.398.294.8
基线$ +{L}_{\text{S}}+{L}_{\text{C}}+{L}_{\text{R}}+\text{AFRM} $99.398.395.0

新窗口打开| 下载CSV


2.8. 复杂度实验

如表6所示为不同方法在推理时间ti、内存使用M及性能上的对比,反映模型复杂度与实际应用效率. 可以看出,所提算法的ti=0.22 s,显著低于对比算法,能够快速完成异常检测任务,满足实时性要求较高的应用场景需求. 在内存使用方面,所提算法仅需456 MB,远低于PaDiM与SPADE,降低了模型运行开销. 实验结果充分验证了所提算法在模型复杂度控制上的有效性,为其在视觉异常检测中的落地应用提供了坚实的性能支撑.

表 6   不同算法在MVTec数据集上的复杂度对比

Tab.6  Comparison of complexity among different algorithm on MVTec dataset

算法ti/sM/MBAUROCI/%AUROCP/%AUPRO/%
P-SVDD0.48—92.195.777.3
PaDiM0.95380095.597.592.1
SPADE1.40140085.596.591.7
本研究0.2245699.398.395.0

新窗口打开| 下载CSV


3. 结 语

本研究提出基于扩散模型构造训练样本的多任务对比约束视觉异常检测算法,利用正常样本合成具有可控异常强度的伪异常图像,在提取特征张量后引入各自对应的投影层,设计3项协同优化任务(特征紧凑聚合、异常敏感与异常特征抑制任务),有效实现了正常与异常特征在嵌入空间中的解耦. 在此基础上,结合自适应融合重建模块,实现了高精度的异常检测与定位. 实验结果表明,所提算法的性能优于现有的先进方法. 所提算法仍存在局限性:1)扩散模型生成的伪异常样本语义多样性与真实工业异常仍有差距,可能限制对复杂或结构性异常的泛化能力;2)尽管无需异常样本训练,模型性能仍依赖高质量的正常数据建模,当正常样本含噪声或类别混杂时,特征紧凑性易被破坏,影响检测精度. 未来工作将探索更高效的扩散引导机制与自适应对比约束策略,以增强模型在跨类别零样本场景下的泛化能力,并提升对未知异常的适应性与鲁棒性;将引入噪声鲁棒的特征学习机制,缓解正常样本污染对特征紧凑聚合任务的负面影响. 所提算法仅需正常样本进行训练,即可有效提升异常检测的判别能力与鲁棒性,其结合可控缺陷生成与多任务对比约束的设计思路,为后续面向复杂工业场景的异常检测研究奠定了基础.

参考文献

张鹏, 田子都, 王浩

基于改进生成对抗网络的飞参数据异常检测方法

[J]. 浙江大学学报: 工学版, 2022, 56 (10): 1967- 1976

DOI:10.3785/j.issn.1008-973X.2022.10.008      [本文引用: 1]

ZHANG Peng, TIAN Zidu, WANG Hao

Flight parameter data anomaly detection method based on improved generative adversarial network

[J]. Journal of Zhejiang University: Engineering Science, 2022, 56 (10): 1967- 1976

DOI:10.3785/j.issn.1008-973X.2022.10.008      [本文引用: 1]

YE F, HUANG C, CAO J, et al

Attribute restoration framework for anomaly detection

[J]. IEEE Transactions on Multimedia, 2022, 24: 116- 127

DOI:10.1109/TMM.2020.3046884      [本文引用: 2]

SALEHI M, EFTEKHAR A, SADJADI N, et al. Puzzle-AE: novelty detection in images through solving puzzles [EB/OL]. (2022–02–10)[2025–10–08]. https://arxiv.org/pdf/2008.12959.

[本文引用: 2]

LI C L, SOHN K, YOON J, et al. CutPaste: self-supervised learning for anomaly detection and localization [C]// Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. Nashville: IEEE, 2021: 9659–9669.

[本文引用: 1]

SCHLÜTER H M, TAN J, HOU B, et al. Self-supervised out-of-distribution detection and localization with natural synthetic anomalies (NSA) [EB/OL]. (2021–09–30)[2025–10–08]. https://arxiv.org/pdf/2109.15222v1.

[本文引用: 2]

ZAVRTANIK V, KRISTAN M, SKOČAJ D. DRÆM: a discriminatively trained reconstruction embedding for surface anomaly detection [C]// Proceedings of the IEEE/CVF International Conference on Computer Vision. Montreal: IEEE, 2022: 8310–8319.

[本文引用: 2]

ZHANG F, ZHU H, CEN Y, et al

Low-shot unsupervised visual anomaly detection via sparse feature representation

[J]. IEEE Transactions on Neural Networks and Learning Systems, 2025, 36 (5): 7903- 7917

DOI:10.1109/TNNLS.2024.3420818      [本文引用: 1]

CAI Y, LIANG D, LUO D, et al

A discrepancy aware framework for robust anomaly detection

[J]. IEEE Transactions on Industrial Informatics, 2024, 20 (3): 3986- 3995

DOI:10.1109/TII.2023.3318302      [本文引用: 1]

ZHANG F, KAN S, ZHANG D, et al

A graph model-based multiscale feature fitting method for unsupervised anomaly detection

[J]. Pattern Recognition, 2023, 138: 109373

DOI:10.1016/j.patcog.2023.109373      [本文引用: 1]

IULIANO A, LIÒ P, MANFREDI G, et al. Denoising probabilistic diffusion models for synthetic healthcare image generation [C]// Proceedings of the IEEE International Workshop on Metrology for Living Environment. Chania: IEEE, 2024: 415–420.

[本文引用: 1]

HO J, JAIN A, ABBEEL P. Denoising diffusion probabilistic models [EB/OL]. (2020–12–16)[2025–10–08]. https://arxiv.org/pdf/2006.11239.

[本文引用: 1]

ZAGORUYKO S, KOMODAKIS N. Wide residual networks [EB/OL]. (2017–06–14)[2025–10–08]. https://arxiv.org/pdf/1605.07146.

[本文引用: 1]

DEFARD T, SETKOV A, LOESCH A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization [C]// Pattern Recognition. ICPR International Workshops and Challenges. Cham: Springer, 2021: 475–489.

[本文引用: 2]

JOYCE J M. Kullback-Leibler divergence [M]// LOVRIC M. International encyclopedia of statistical science. [S.l.]: Springer, 2011: 720–722.

[本文引用: 1]

BERGMANN P, FAUSER M, SATTLEGGER D, et al. MVTec AD: a comprehensive real-world dataset for unsupervised anomaly detection [C]// Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. Long Beach: IEEE, 2020: 9584–9592.

[本文引用: 1]

MISHRA P, VERK R, FORNASIER D, et al. VT-ADL: a vision transformer network for image anomaly detection and localization [C]// Proceedings of the IEEE 30th International Symposium on Industrial Electronics. Kyoto: IEEE, 2021: 1–6.

[本文引用: 1]

YI J, YOON S. Patch SVDD: patch-level SVDD for anomaly detection and segmentation [C]// Computer Vision – ACCV 2020. Cham: Springer, 2021: 375–390.

[本文引用: 1]

ZAVRTANIK V, KRISTAN M, SKOČAJ D

Reconstruction by inpainting for visual anomaly detection

[J]. Pattern Recognition, 2021, 112: 107706

DOI:10.1016/j.patcog.2020.107706      [本文引用: 1]

COHEN N, HOSHEN Y. Sub-image anomaly detection with deep pyramid correspondences [EB/OL]. (2021–02–03)[2025–10–08]. https://arxiv.org/pdf/2005.02357.

[本文引用: 1]

DENG H, LI X. Anomaly detection via reverse distillation from one-class embedding [C]// Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. New Orleans: IEEE, 2022: 9727–9736.

[本文引用: 1]

XING P, SUN Y, ZENG D, et al

Normal image guided segmentation framework for unsupervised anomaly detection

[J]. IEEE Transactions on Circuits and Systems for Video Technology, 2024, 34 (6): 4639- 4652

DOI:10.1109/TCSVT.2023.3327448      [本文引用: 1]

ROTH K, PEMULA L, ZEPEDA J, et al. Towards total recall in industrial anomaly detection [C]// Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. New Orleans: IEEE, 2022: 14298–14308.

[本文引用: 1]

DE PAULA MONTEIRO R, LOZADA M C, MENDIETA D R C, et al

A hybrid prototype selection-based deep learning approach for anomaly detection in industrial machines

[J]. Expert Systems with Applications, 2022, 204: 117528

DOI:10.1016/j.eswa.2022.117528      [本文引用: 1]

ZHANG R, WANG H, FENG M, et al

Dual-constraint autoencoder and adaptive weighted similarity spatial attention for unsupervised anomaly detection

[J]. IEEE Transactions on Industrial Informatics, 2024, 20 (7): 9393- 9403

DOI:10.1109/TII.2024.3384583      [本文引用: 1]

/

〈 〉