



传统的PCB缺陷检测方法包括人工目检与机器视觉算法(如模板匹配、图像相减法),存在泛化能力弱、易受噪声干扰及难以适应复杂背景等局限[4]. 深度学习技术的崛起,特别是以CNN为核心的目标检测算法,如两阶段Faster R-CNN[5],到单阶段、实时性更优的YOLO系列[6-9],通过自动学习深层特征,在精度与鲁棒性上实现显著突破,已成为主流技术路线[10]. 为了进一步提升微小缺陷的检测精度,卞佰成等[11]使用K-means算法重新聚类生成锚框尺寸,提高了模型的目标检测精度;Li等[12]设计双域高频自适应池化方法,以保留对微小缺陷至关重要的高频信号;周著国等[13]引入重参数化技术,提高模型的轻量级与高效性. CNN架构固有的局部感受野限制了其对全局上下文的建模能力,这在区分复杂背景下的微小缺陷时尤为关键. 为此,具备全局注意力机制的Transformer架构[14]通过有效捕捉长程依赖关系,为突破CNN的局限提供了新思路. 在此基础上,端到端检测器DETR[15]因摒弃了非极大值抑制后处理而得到关注,获得可变形注意力(Deformable DETR[16])、动态锚框(DAB-DETR[17])及去噪(DN-DETR[18])等关键优化,并在如DINO[19]的算法中将性能推向新高. 在此基础上,实时检测算法RT-DETR[20]凭借高效的混合编码器与查询选择机制能够获得速度与精度间的平衡,为工业检测提供了新思路.
为了解决PCB缺陷因尺度多变导致多尺度特征融合困难,在深度网络中精细特征易丢失,以及在复杂电路背景干扰下现有算法难以兼顾检测精度与速度的问题,本研究提出改进的PCB缺陷检测算法DCFA-DETR,从特征提取、特征融合与损失函数层面系统性改进算法,开展以下核心工作:1)构建细节增强骨干网络,引入细节增强卷积[21](detail-enhanced convolution,DEConv)与小波池化[22](wavelet pooling,WP),在特征提取源头强化对高频边缘细节的捕获与保留,应对精细缺陷特征易丢失的问题;2)提出矩形上下文感知特征金字塔网络(rectangular context-aware feature pyramid network,RCAFPN),通过矩形自校准注意力与门控融合机制,实现跨尺度特征的深度交互与背景干扰的自适应抑制,解决多尺度融合困难与背景误判问题;3)设计高分辨率交叉注意力模块(high-resolution cross-attention modul,HRCAM),将骨干网络浅层的高分辨率特征P2与深层语义特征借助交叉注意力机制[23]进行动态融合,为深层特征注入精确空间线索,弥补深层网络对微小目标感知不足的问题;4)采用Wise-IoUv3[24]损失函数,通过动态非单调聚焦机制为不同质量样本智能分配梯度权重,优化边界框回归过程,进一步提升定位精度.
1. 改进RT-DETR目标检测算法
如图1所示,DCFA-DETR在RT-DETR-R18的基础上,通过对骨干网络、混合编码器以及损失函数的协同优化,旨在实现检测精度与效率的全面提升. 输入PCB图像经由细节增强骨干网络,该网络通过DEConv与WP模块提取出包含P2至P5的多尺度特征图. 其中,高分辨率特征图P2被送入HRCAM以保留精细的空间线索;语义信息更丰富的P3、P4、P5特征图共同进入金字塔上下文提取(pyramid context extraction,PCE)部分进行深度的跨尺度信息交互. 交互后的多尺度特征在RCAFPN中进行自顶向下与自底向上的双向特征融合. 融合过程中,来自HRCAM的高分辨率细节被动态注入,以提升对如毛刺和开路的微小目标的感知能力. 编码器输出的增强特征序列,经由WiseIoU感知查询选择机制筛选出高质量的对象查询. 这些查询在解码器与检测头中被解码,生成最终的边界框预测结果.
图 1
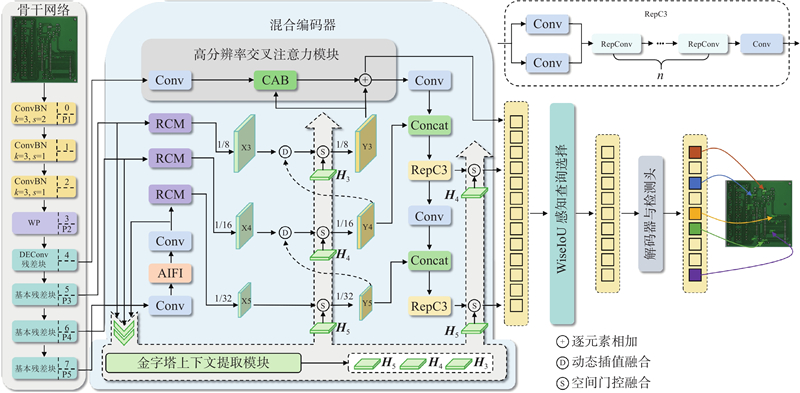
图 1 改进的PCB缺陷检测算法整体框架
Fig.1 Overall framework of improved algorithm for PCB defect detection
1.1. 细节增强骨干网络的构建
传统CNN骨干网络在通过逐层卷积与池化操作提取高级语义特征时,会不可避免地抑制图像中的高频信息. 对于PCB缺陷检测任务而言,精细缺陷(如开路和毛刺)的有效识别高度依赖于对高频细节(如电路边缘、角点)的精确捕捉. 为此,在骨干网络中引入DEConv与WP,分别在特征提取与下采样阶段强化对高频信息的捕捉与保留,提升对微小缺陷的表征能力.
DEConv的核心思想是利用结构重参数化技术[25],在训练阶段并行地从多个维度捕捉图像的细节,在推理阶段将这些并行的结构等效地融合成标准的卷积层. PCB缺陷的判别关键在于边缘特征,如图2所示,DEConv在训练时由5个并行的卷积分支协同工作:标准卷积(vanilla convolution,VC)用于提取常规特征,中心差分卷积(central difference convolution,CDC)通过近似二阶梯度来增强角点与边缘响应,水平和垂直差分卷积(horizontal difference convolution and vertical difference convolution,HDC,VDC)分别捕捉水平与垂直边缘,角度差分卷积(angular difference convolution,ADC)专用于提取旋转性角部特征. DEConv将输入特征
图 2
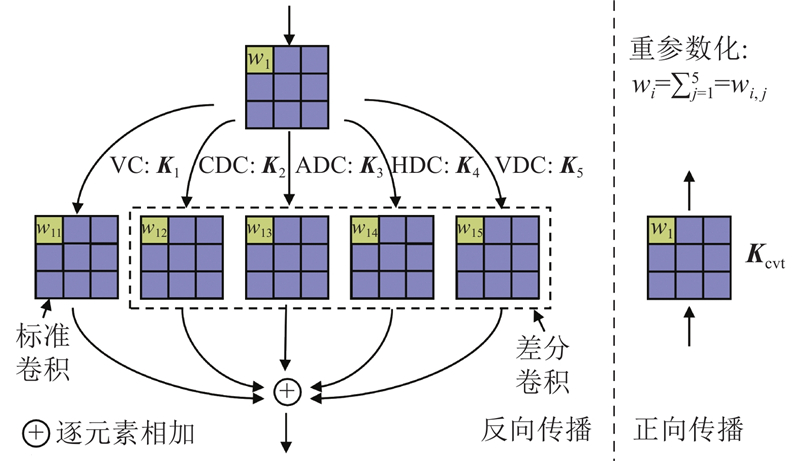
图 2 细节增强卷积的重参数技术流程
Fig.2 Re-parameterization process of detail-enhanced convolution
式中:
在下采样环节,为了缓解缺陷细节信息损失问题,采用基于二维离散小波变换(2D discrete wavelet transform,2D-DWT)的小波池化层,通过对输入的二维特征图X分别应用低通矩阵算子L和高通矩阵算子H,分解为4个下采样后的频率子带:
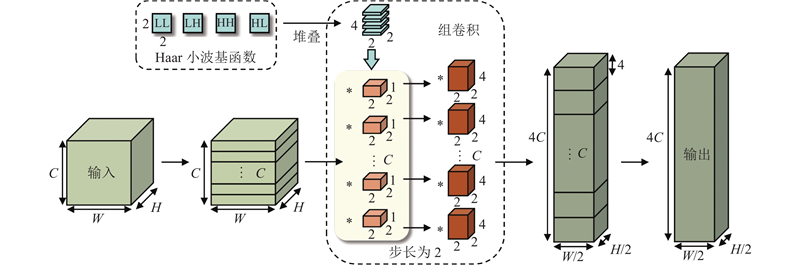
在2D-DWT的输出中,XLL是输入的低频成分,包含PCB缺陷的整体结构与轮廓信息;XLH、XHL和XHH是3个高频成分,分别保存输入X的水平、垂直和对角线的细节信息. 这些高频信息是识别微小开路、细微毛刺以及不规则边缘等多种PCB缺陷的关键特征. WP模块流程如图3所示,4个2×2 Haar小波基函数被预定义为滤波器,堆叠成一组不可学习的卷积核. 前向传播采用分组卷积机制,每个输入通道独立应用4个Haar滤波器,通过步长为2的分组卷积实现滤波时特征图空间尺寸的减半. C份独立的4通道结果(C为输入特征图的通道数),最终在通道维度进行拼接,输出特征图的通道数变为4C,空间尺寸为输入的一半. WP在实现下采样的同时,保留并传递了PCB缺陷的高频细节信息,确保在后续网络层中,即便尺寸缩小,细微缺陷的关键特征依然能够被充分利用,从而显著提升缺陷的定位度和分类性能.
图 3
1.2. 矩形上下文感知特征金字塔网络的构建
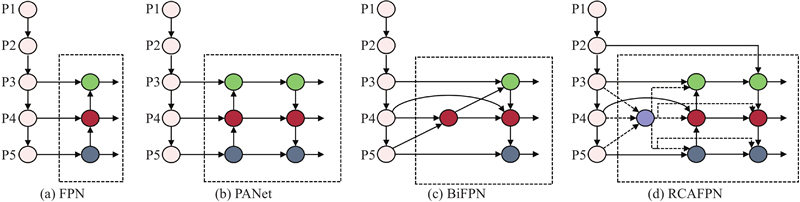
针对PCB缺陷检测中目标尺度差异巨大的难题,经典的FPN受限于单向信息流与简单叠加,导致特征交互浅且语义不对齐,后续的PANet和BiFPN工作引入双向信息流,却使参数与复杂度的增加. 如图4所示对比不同特征金字塔结构,本研究设计的RCAFPN通过“金字塔上下文提取—动态插值融合—门控融合”三级流程,在不显著增加计算复杂度的同时实现更深度的特征交互.
图 4
如图5所示,骨干网络输出的特征图P3、P4和P5先被送入PCE模块拼接并通过级联的矩形自校准模块(rectangular self-calibration module, RCM)进行共同精炼. RCM内部的关键是矩形自校准注意力(rectangular self-calibration attention,RCA),它由形状自校准函数
图 5
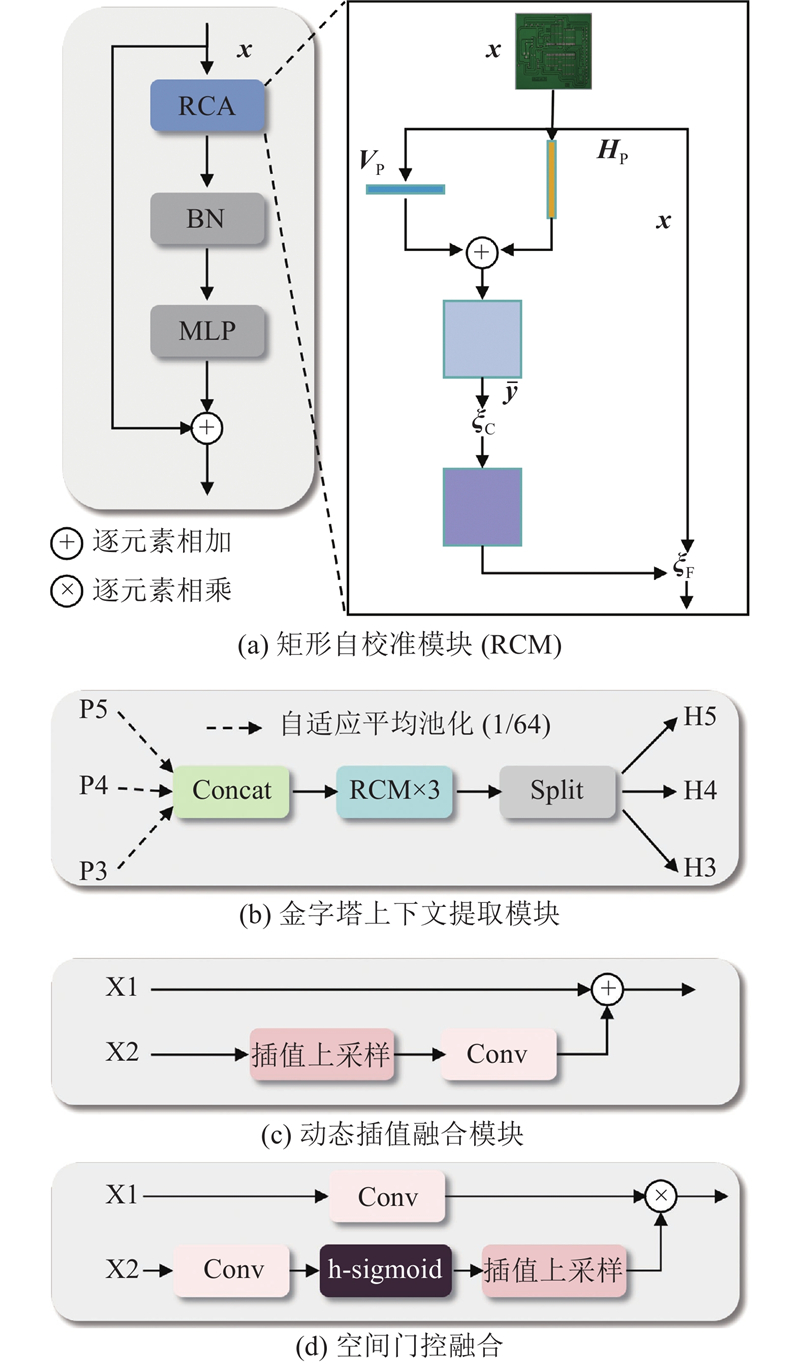
图 5 矩形上下文感知特征金字塔网络的组件结构
Fig.5 Structure of rectangular context-aware feature pyramid network components
式中:
式中:y为由
式中:
1.3. 高分辨率交叉注意力模块的构建
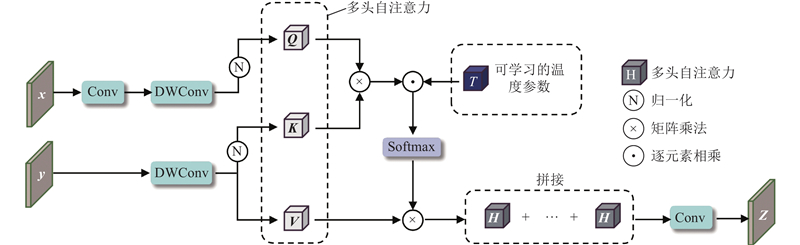
RCAFPN通过多尺度上下文融合有效整合了P3至P5层级的特征,但对于尺寸极小的缺陷,其关键的结构信息主要保存在语义层次较低而分辨率较高的浅层特征图P2中. 为了解决高分辨率信息难以被深层语义有效利用的问题,设计HRCAM,核心是交叉注意力模块(cross-attention block, CAB),输入包括来自RCAFPN中携带强语义信息的特征图Y3与骨干网络浅层、拥有最高分辨率和精细纹理的特征图P2. 如图6所示,在CAB中,语义信息更强的特征图Y3生成查询Q,作为缺陷类型与全局位置的语义引导. 下采样后的特征图P2被用作键K和值V,提供缺陷细节的空间位置线索,包含电路板上精细的走线、焊盘和间隙等信息. 考虑到传统注意力机制中线性投影可能导致空间结构丢失,为此在生成Q、K和V之前引入深度可分离卷积(depth-wise separable convolution,DWConv),在保持低参数量和低计算成本的同时,注入卷积特有的局部归纳偏置,使CAB能在注意力交互前有效编码像素邻域的微细纹理(如走线连续性和焊盘边缘),从而更好地区分缺陷与背景噪声. 生成的Q、K和V被送入标准的多头自注意力流程,Q与K的点积通过可学习的温度参数T进行缩放,经Softmax函数归一化以生成注意力权重作用于V,以动态聚合来自P2中的关键细节. 最终,各头的输出经过拼接与卷积投影得到融合特征,通过外部残差连接与原始Y3相加,避免了因信息融合不当导致的特征退化.
图 6
1.4. Wise-IoUv3损失函数
为了优化边界框的回归精度,应对PCB表面尺寸各异、形态多变的缺陷,引入Wise-IoUv3(WIoUv3)作为算法的回归损失函数,其核心是动态非单调聚焦机制,根据预测框的质量,智能地分配梯度权重. 定义动态的离群度指标β,衡量当前预测框的质量:
式中:
WIoUv3的动态非单调聚焦机制会自适应地抑制高质量(易学习)与极端低质量(离群)样本的梯度贡献,转而将优化资源聚焦于具有最大优化潜力的中等质量样本,即离群程度满足
2. 实验结果与分析
2.1. 实验环境和数据集预处理
实验的硬件平台配置包含NVIDIA GeForce RTX 3090 GPU和7核Intel(R) Xeon(R) E5-2680 v4@2.40GHz CPU. 所有实验均在Linux Ubuntu系统上完成,软件环境包括Python 3.10和Cuda 12.1. 实验用数据集基于北京大学发布的PKU-Market-PCB公开数据集,包含6种常见的PCB缺陷类型,分别为缺孔、鼠咬、断路、短路、毛刺以及残铜,如图7所示. 为了更全面地评估算法性能并提升其鲁棒性,通过将数据集旋转、缩放、平移和添加椒盐噪声扩展至4 000张图像,按照比例7∶1∶2划分训练集、验证集和测试集,单张图像中包含多个缺陷实例,每种缺陷类型的实例数量如表1所示.
图 7
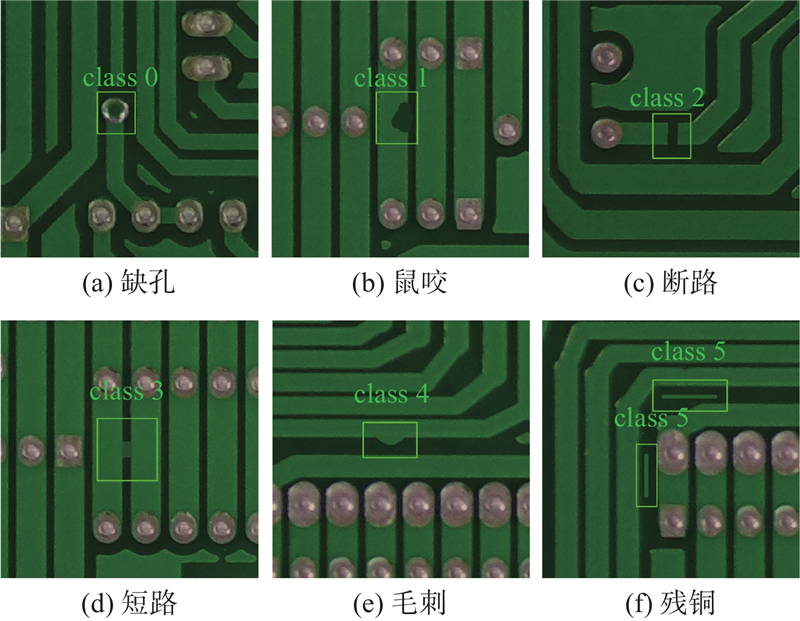
表 1 数据集中PCB缺陷类型的实例数量统计
Tab.1
| ID | 缺陷类别 | 实例数量 | |||
| 训练集 | 验证集 | 测试集 | 总计 | ||
| 0 | 缺孔 | 360 | 699 | ||
| 1 | 鼠咬 | 400 | 837 | ||
| 2 | 断路 | 351 | 697 | ||
| 3 | 短路 | 329 | 715 | ||
| 4 | 毛刺 | 347 | 676 | ||
| 5 | 残铜 | 318 | 683 | ||
2.2. 实验参数设置
为了保证实验的严谨性和科学性,实验过程中所有算法训练均未使用预训练权重,均采用相同实验环境与超参数,训练总周期epoch=300,设置20个周期的早停机制防止过拟合. 训练的批处理大小为4,加载数据的工作线程数为4,输入图像的尺寸统一调整为640像素×640像素. 优化器采用AdamW,初始学习率设置为0.000 1,动量为 0.937,其余参数均保持默认值.
2.3. 评估指标
为了全面评估算法的综合性能,实验中采用标准化的评价指标. 算法的检测精度主要通过精确率P与召回率R衡量,计算式分别为
式中:
均值平均精度mAP通过对所有类别的AP求平均来衡量算法的整体性能,计算式为
实验中分析IoU阈值为0.5时的mAP50以及在0.5至0.95区间平均的mAP50-95,后者能更鲁棒地评价算法的定位准确性. 在算法效率方面,通过总参数量NP和理论计算复杂度GFLOPs进行量化. 采用帧率RF评估算法的实际推理速度:
式中:
2.4. 细节增强卷积模块消融实验
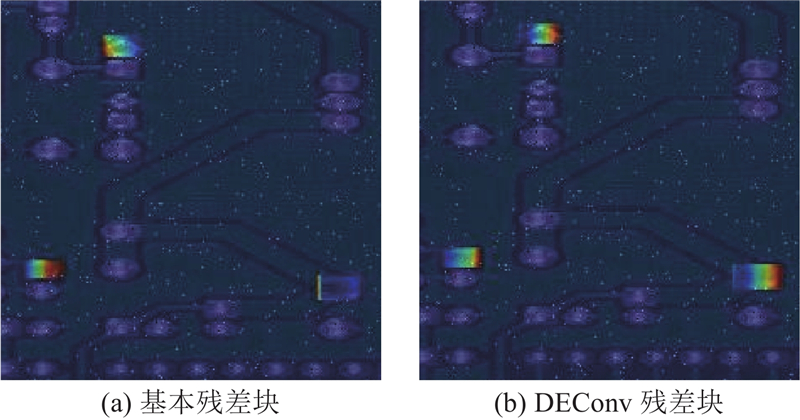
为了系统性地验证DEConv模块的有效性,探究其在骨干网络中的最优部署位置,进行消融实验. 通过在骨干网络中不同阶段将标准的基本模块替换为DEConv模块,评估其对算法整体性能的影响. DEConv模块对特征表征的增强效果通过热力图可视化得到直观验证. 如图8所示,与标准基本模块生成的较为弥散的特征响应相比,DEConv模块的激活区域明显更加聚焦,精准地突出了电路的关键边缘与细节,证明了DEConv在捕捉精细化、高区分度特征的能力.
图 8
如表2所示,将DEConv仅部署于骨干网络首个模块时性能最优,mAP50和mAP50-95分别达到97.0%和57.3%. 随着部署层级加深或采用多层组合策略,模型参数量增加但精度下滑,尤以mAP50-95衰退显著. 这表明DEConv的核心优势在于增强浅层细节特征,在深层强行应用会引入噪声,干扰高级语义构建. 因此,本研究采用仅在第一阶段部署的策略,以实现精细特征提取与语义学习的最佳平衡.
表 2 细节增强卷积的部署位置对骨干网络的影响
Tab.2
| DEConv位置 | mAP50/% | mAP50-95/% | NP | |||
| 第一阶段 | 第二阶段 | 第三阶段 | 第四阶段 | |||
| √ | — | — | — | 97.0 | 57.3 | 20 401 024 |
| — | √ | — | — | 96.5 | 57.1 | 20 401 280 |
| — | — | √ | — | 96.2 | 57.1 | 20 401 792 |
| — | — | — | √ | 95.4 | 54.9 | 20 402 816 |
| — | — | √ | √ | 95.4 | 56.4 | 20 403 840 |
| — | √ | √ | √ | 95.5 | 52.1 | 20 404 352 |
| √ | √ | √ | √ | 96.7 | 57.2 | 20 141 440 |
2.5. 高分辨率交叉注意力模块消融实验
为了验证HRCAM中特征编码策略的有效性,对比线性映射、标准卷积与DWConv性能,结果如表3所示. 当仅采用线性映射因缺乏局部空间归纳偏置,难以精准捕捉PCB微小缺陷的精细边缘,导致mAP50-95仅停留在55.8%. 卷积操作的引入显著弥补了短板并提升了各项指标. 尽管标准卷积凭借稠密连接使精度略有提升,但参数冗余严重;反观DWConv,仅以微小的参数代价便实现了同等量级的精度. 这种高性价比设计在消除冗余的同时,有效平衡了微小目标感知与算法轻量化需求.
表 3 深度可分离卷积的有效性分析
Tab.3
| 方法 | mAP50/% | mAP50-95/% | NP |
| 线性映射 | 96.7 | 55.8 | 20 393 344 |
| 标准卷积 | 97.1 | 57.4 | 23 343 232 |
| DWConv | 97.0 | 57.3 | 20 401 024 |
2.6. 核心组件消融实验
为了验证DCFA-DETR框架中各创新模块的独立贡献与协同效应,以RT-DETR-R18(mAP50=94.7%,mAP50-95=52.1%)作为基线算法,在此基础上逐一增量地集成各个核心组件,实验结果如表4所示. DEConv的引入使mAP50-95提升了4个百分点,证实了其在骨干网络浅层捕捉精细化特征的强大能力. RCAFPN的集成不仅将mAP50-95提升了3.3个百分点,还将计算复杂度从57.0×10⁹降至48.2×10⁹,展示了其在增强多尺度特征交互的同时优化计算效率的双重优势. HRCAM与WP的引入分别带来了3.0和2.9个百分点的mAP50-95增长. 结果证明无论是利用WP在骨干网络保留高分辨信息,还是通过HRCAM在颈部注入细节,为深度特征提供精确空间线索均是提升算法精细定位能力的关键. 在最优网络结构的基础上引入WIoU损失函数进行训练. 完整算法(DCFA-DETR)的mAP50=97.0%和mAP50-95=57.3%,其在mAP50-95上的提升幅度明显高于mAP50. 这是由于基线算法在mAP50阈值下性能已趋于饱和,单纯的目标召回率提升空间有限,改进模块聚焦于高频边缘信息的保留与重建,能够增强预测框在高IoU阈值下的回归精准度,从而大幅提升反映定位质量的mAP50-95指标,结合84.4 帧/s的推理速度,证明了DCFA-DETR在高精度工业检测中的优越性.
表 4 改进模块的消融实验结果
Tab.4
| 算法 | RCAFPN | HRCAM | WP | DEConv | WIoU | P/% | R/% | mAP50/% | mAP50-95/% | GFLOPs | RF/(帧·s−1) |
| 基线 | — | — | — | — | — | 96.3 | 91.9 | 94.7 | 52.1 | 57.0 | 70.8 |
| 2 | √ | — | — | — | — | 97.0 | 92.5 | 95.4 | 55.4 | 48.2 | 76.7 |
| 3 | — | √ | — | — | — | 96.9 | 92.8 | 95.7 | 55.1 | 62.3 | 82.8 |
| 4 | — | — | √ | — | — | 97.1 | 93.1 | 95.5 | 55.0 | 63.3 | 94.5 |
| 5 | — | — | — | √ | — | 97.2 | 92.7 | 95.6 | 56.1 | 57.0 | 95.0 |
| 6 | — | — | — | — | √ | 96.7 | 93.0 | 95.6 | 54.2 | 57.0 | 98.9 |
| 7 | √ | √ | — | — | — | 97.1 | 92.7 | 96.2 | 55.9 | 55.3 | 76.9 |
| 8 | √ | √ | √ | — | — | 96.7 | 92.8 | 96.1 | 56.6 | 61.6 | 84.3 |
| 9 | √ | √ | √ | √ | — | 97.2 | 93.4 | 96.6 | 57.1 | 61.6 | 84.3 |
| DCFA-DETR | √ | √ | √ | √ | √ | 97.8 | 94.3 | 97.0 | 57.3 | 61.6 | 84.4 |
图 9
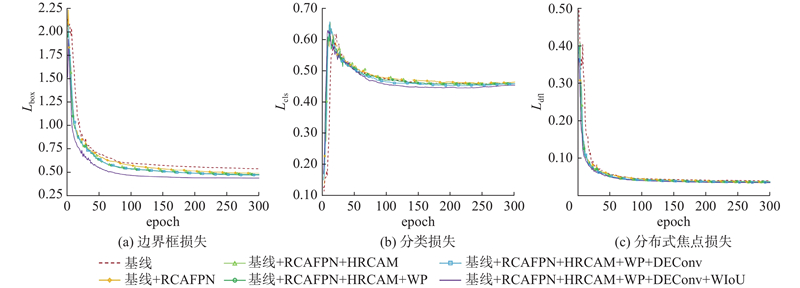
图 10
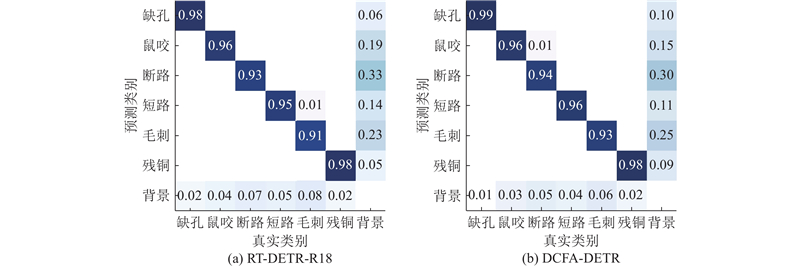
图 10 不同算法在测试集上的归一化混淆矩阵对比
Fig.10 Comparison of normalized confusion matrices of different algorithms on test set
2.7. 算法性能对比实验
为了评估DCFA-DETR的综合性能,选取Faster-RCNN、SSD、YOLO系列(v8m/v9m/v10m)及基线RT-DETR进行算法性能对比. 实验在统一硬件及超参数配置(输入图片分辨率为640×640)下重新训练所有模型以确保公平,结果如表5所示. 与YOLO系列相比,DCFA-DETR在参数量和计算复杂度相当的情况下,mAP50比表现最佳的YOLOv8m高出3.5个百分点,同时推理速度达到84.4帧/s,实现精度与速度的双重超越. 与基线RT-DETR-R18相比,DCFA-DETR仅以增加约2.5%的参数量和8% GFLOPs的微小代价,便换取了2.3个百分点的mAP50提升,证明所提算法在PCB缺陷检测中保证实时性的同时具有更高的检测精度,达到当前业界领先的水平. 由AP50细分数据中可以发现,性能提升最为显著的类别,恰恰是那些最具挑战性的、尺寸微小或结构精细的缺陷. 具体而言,对于毛刺、短路和断路,AP50分别提升3.9、3.3和2.9个百分点.
表 5 不同PCB缺陷检测算法的性能对比结果
Tab.5
| 算法 | NP | P/% | R/% | AP50/% | mAP50/% | GFLOPs | RF/(帧·s−1) | |||||
| 缺孔 | 鼠咬 | 断路 | 短路 | 毛刺 | 残铜 | |||||||
| Faster-RCNN | 136 851 734 | 88.3 | 81.6 | 93.0 | 81.4 | 82.4 | 91.9 | 80.4 | 85.3 | 85.7 | 271.4 | 21.7 |
| SSD | 26 275 485 | 79.2 | 71.8 | 85.6 | 71.1 | 75.6 | 81.2 | 65.4 | 79.0 | 76.3 | 62.7 | 90.2 |
| YOLOv8m | 25 843 234 | 95.7 | 88.2 | 99.4 | 92.3 | 90.6 | 97.8 | 84.0 | 96.6 | 93.5 | 78.7 | 79.8 |
| YOLOv9m | 20 159 266 | 95.3 | 86.8 | 99.3 | 89.7 | 87.7 | 97.0 | 84.2 | 94.6 | 92.1 | 77.0 | 80.2 |
| YOLOv10m | 15 316 642 | 94.4 | 86.7 | 99.3 | 89.4 | 87.1 | 96.5 | 83.4 | 94.7 | 91.7 | 58.9 | 83.1 |
| RT-DETR-l | 31 996 326 | 96.9 | 93.8 | 97.5 | 96.8 | 92.2 | 95.7 | 93.8 | 99.3 | 95.9 | 103.5 | 46.2 |
| RT-DETR-R18 | 19 879 464 | 96.3 | 91.9 | 96.5 | 96.1 | 91.7 | 93.6 | 91.5 | 98.8 | 94.7 | 57.0 | 70.8 |
| DCFA-DETR | 20 401 024 | 97.8 | 94.3 | 97.8 | 97.7 | 94.6 | 96.9 | 95.4 | 99.5 | 97.0 | 61.6 | 84.4 |
图 11
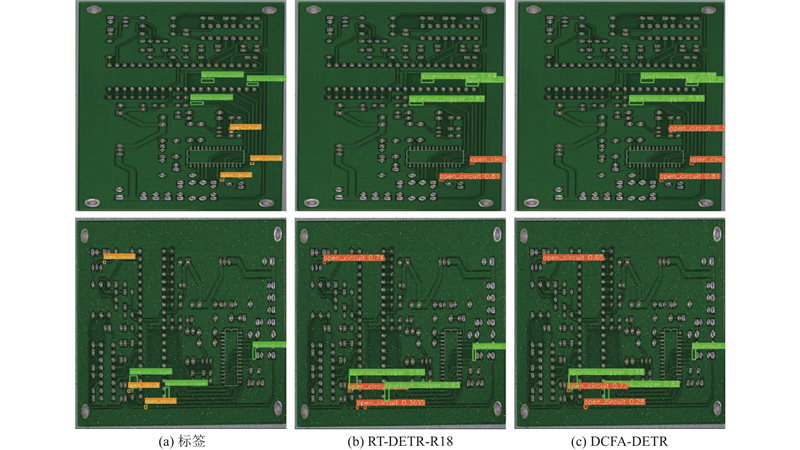
图 11 多场景下2种算法的检测效果可视化对比
Fig.11 Visual comparison of detection results between two algorithms in multiple scenarios
2.8. 算法泛化能力对比实验
为了评估DCFA-DETR框架的泛化能力,在DeepPCB数据集上进行对比实验. 相较于由富含环境干扰的真实图像构成的PKU-Market-PCB数据集而言,DeepPCB图像呈现二值化的高对比度黑白结构,极度依赖对线路边缘拓扑形状的精细感知,对算法的泛化边界构成了实质性挑战. DeepPCB包含1 500对经过对齐的PCB模板图与含缺陷图,专门用于工业检测场景下的缺陷定位研究. DeepPCB标注的缺陷共包含6个类别:开路、短路、鼠咬、毛刺、针孔和杂铜,按照比例7∶1∶2分割为训练集、验证集和测试集,以检验算法在新数据分布下的学习与迁移能力.
表 6 在DeepPCB数据集上的算法泛化能力对比实验结果
Tab.6
| 算法 | P | R | mAP50 | mAP50-95 |
| Faster R-CNN | 92.6 | 83.4 | 83.1 | 54.6 |
| YOLOv8m | 97.2 | 95.3 | 97.5 | 67.6 |
| YOLOv9m | 97.0 | 94.8 | 97.3 | 63.2 |
| YOLOv10m | 94.9 | 93.9 | 97.1 | 65.9 |
| RT-DETR-R18 | 96.2 | 93.5 | 97.7 | 65.3 |
| DCFA-DETR | 98.3 | 94.5 | 98.3 | 70.8 |
图 12
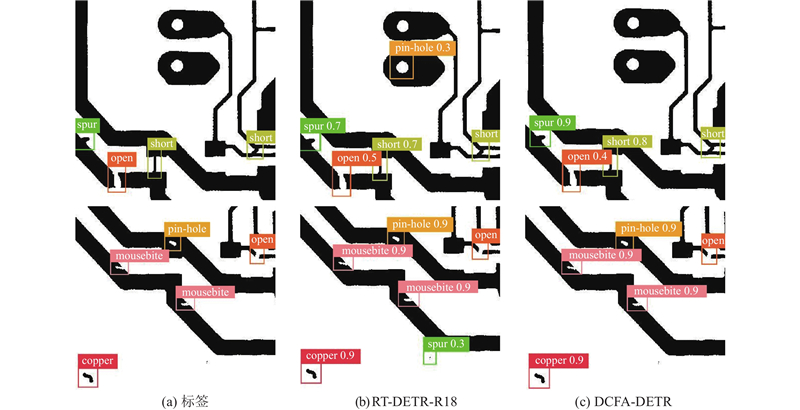
图 12 DeepPCB数据集上的算法泛化能力实验结果可视化对比
Fig.12 Visual comparison of generalization ability experimental results on DeepPCB dataset
3. 结 语
针对PCB表面多尺度、精细化缺陷检测面临的精度与效率挑战,本研究构建基于RT-DETR架构的 PCB缺陷检测改进算法. 通过在骨干特征提取阶段协同部署细节增强卷积与小波池化模块,强化浅层高频信息,使微小缺陷的感知能力增强;设计矩形上下文感知特征金字塔网络与高分辨率交叉注意力模块,通过矩形注意力与空间线索注入,对多尺度特征聚合和微小目标定位提升明显;Wise-IoUv3的动态聚焦机制兼顾了定位精度与训练稳定性,有效降低误检和漏检. 在PKU-Market-PCB和DeepPCB数据集上的实验结果证明,所提算法在精度与速度的权衡上优于现有的先进检测器. 所提算法的实际应用仍受限于对标注数据的强依赖,面对工业现场不可预见的未知缺陷类型时适应性稍显不足. 未来拟引入无监督学习分支,增强算法在工业环境中的自适应检测能力.
参考文献
Recent advances in surface defect inspection of industrial products using deep learning techniques
[J].DOI:10.1007/s00170-021-06592-8 [本文引用: 1]
Visual perception enabled industry intelligence: state of the art, challenges and prospects
[J].DOI:10.1109/TII.2020.2998818 [本文引用: 1]
A comprehensive review of deep learning-based PCB defect detection
[J].DOI:10.1109/ACCESS.2023.3339561 [本文引用: 1]
Faster R-CNN: towards real-time object detection with region proposal networks
[J].DOI:10.1109/TPAMI.2016.2577031 [本文引用: 1]
Defect detection methods for industrial products using deep learning techniques: a review
[J].DOI:10.3390/a16020095 [本文引用: 1]
基于改进YOLOv3的印刷电路板缺陷检测算法
[J].DOI:10.3785/j.issn.1008-973X.2023.04.011 [本文引用: 1]
Improved YOLOv3-based defect detection algorithm for printed circuit board
[J].DOI:10.3785/j.issn.1008-973X.2023.04.011 [本文引用: 1]
Pcb defect detection based on a novel dual-domain high-frequency adaptive enhanced pooling method
[J].DOI:10.1007/s10586-025-05438-2 [本文引用: 1]
基于改进YOLOv5s的印刷电路板缺陷检测算法
[J].DOI:10.3785/j.issn.1008-973X.2025.08.007 [本文引用: 1]
Improved YOLOv5s-based algorithm for printed circuit board defect detection
[J].DOI:10.3785/j.issn.1008-973X.2025.08.007 [本文引用: 1]
DEA-net: single image dehazing based on detail-enhanced convolution and content-guided attention
[J].DOI:10.1109/TIP.2024.3354108 [本文引用: 1]


