[1]
FARKAS A, KERTÉSZ G, LOVAS R. Parallel and distributed training of deep neural networks: a brief overview [C]// Proceedings of the IEEE 24th International Conference on Intelligent Engineering Systems . Reykjavík: IEEE, 2020: 165–170.
[本文引用: 1]
[2]
VERBRAEKEN J, WOLTING M, KATZY J, et al A survey on distributed machine learning
[J]. ACM Computing Surveys , 2021 , 53 (2 ): 1 - 33
[3]
卢凯, 赖志权, 李笙维, 等 并行智能训练技术: 挑战与发展
[J]. 中国科学: 信息科学 , 2023 , 53 (8 ): 1441 - 1468
DOI:10.1360/SSI-2023-0051
[本文引用: 1]
LU Kai, LAI Zhiquan, LI Shengwei, et al Parallel intelligent computing: development and challenges
[J]. Scientia Sinica: Informationis , 2023 , 53 (8 ): 1441 - 1468
DOI:10.1360/SSI-2023-0051
[本文引用: 1]
[4]
LI M, ANDERSEN D G, SMOLA A, et al. Communication efficient distributed machine learning with the parameter server [C]// Proceeding of the 28th International Conference on Neural Information Processing Systems: Volume 1 . Cambridge: MIT Press, 2014: 19–27.
[本文引用: 1]
[5]
LI S, ZHAO Y, VARMA R, et al. PyTorch distributed: experiences on accelerating data parallel training [EB/OL]. (2022−06−28)[2025−12−09]. https://arxiv.org/pdf/2006.15704.
[本文引用: 2]
[6]
NARAYANAN D, SHOEYBI M, CASPER J, et al. Efficient large-scale language model training on GPU clusters using megatron-LM [C]// Proceedings of the SC21: International Conference for High Performance Computing, Networking, Storage and Analysis . St. Louis: IEEE, 2022: 1–14.
[本文引用: 7]
[7]
HUANG Y, CHENG Y, BAPNA A, et al. GPipe: efficient training of giant neural networks using pipeline parallelism [EB/OL]. (2019−07−25)[2025−12−09]. https://arxiv.org/pdf/1811.06965.
[本文引用: 5]
[8]
NARAYANAN D, HARLAP A, PHANISHAYEE A, et al. PipeDream: generalized pipeline parallelism for DNN training [C]// Proceedings of the 27th ACM Symposium on Operating Systems Principles . Huntsville: ACM, 2019: 1–15.
[本文引用: 1]
[9]
KIM T, KIM H, YU G I, et al. BPIPE: memory-balanced pipeline parallelism for training large language models [C]// Proceedings of the 40th International Conference on Machine Learning . Honolulu: PMLR, 2023: 16639–16653.
[本文引用: 1]
[10]
ALISTARH D, GRUBIC D, LI J, et al. QSGD: communication-efficient SGD via gradient quantization and encoding [C]// Proceedings of the 31th Conference on Neural Information Processing Systems . Long Beach: [s.n.], 2017: 1–12.
[本文引用: 3]
[11]
GUO J, WU J, WANG Z, et al. Compressing large language models by joint sparsification and quantization [C]// Proceedings of the International Conference on Machine Learning . Vienna: PMLR, 2024: 1–13.
[本文引用: 2]
[12]
RENGGLI C, ASHKBOOS S, AGHAGOLZADEH M, et al. SparCML: high-performance sparse communication for machine learning [C]// Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis . Denver: ACM, 2019: 1–15.
[本文引用: 2]
[14]
CHEN T, XU B, ZHANG C, et al. Training deep nets with sublinear memory cost [EB/OL]. (2016−04−22)[2025−12−09]. https://arxiv.org/pdf/1604.06174.
[本文引用: 2]
[15]
BEAUMONT O, EYRAUD-DUBOIS L, SHILOVA A. Efficient combination of rematerialization and offloading for training DNNs [C]// Proceeding of the 35th International Conference on Neural Information Processing Systems . [S.l.]: Curran Associates Inc., 2021, 34: 23844–23857.
[本文引用: 2]
[16]
SHOEYBI M, PATWARY M, PURI R, et al. Megatron-LM: training multi-billion parameter language models using model parallelism [EB/OL]. (2020−03−13)[2025−12−09]. https://arxiv.org/pdf/1909.08053.
[本文引用: 1]
[17]
RASLEY J, RAJBHANDARI S, RUWASE O, et al. DeepSpeed: system optimizations enable training deep learning models with over 100 billion parameters [C]// Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining . [S.l.]: ACM, 2020: 3505–3506.
[本文引用: 1]
[18]
LANGER M, HE Z, RAHAYU W, et al Distributed training of deep learning models: a taxonomic perspective
[J]. IEEE Transactions on Parallel and Distributed Systems , 2020 , 31 (12 ): 2802 - 2818
DOI:10.1109/TPDS.2020.3003307
[本文引用: 1]
[19]
GUAN L, LI D S, LIANG J Y, et al Advances of pipeline model parallelism for deep learning training: an overview
[J]. Journal of Computer Science and Technology , 2024 , 39 (3 ): 567 - 584
DOI:10.1007/s11390-024-3872-3
[21]
YANG B, ZHANG J, LI J, et al. PipeMare: asynchronous pipeline parallel DNN training [C]// Proceedings of the 4th Machine Learning and Systems Conference . San Jose: PMLR, 2021, 3: 269–296.
[本文引用: 1]
[22]
NARAYANAN D, PHANISHAYEE A, SHI K, et al. Memory-efficient pipeline-parallel DNN training [C]// Proceedings of the 38th International Conference on Machine Learning . [S.l.]: PMLR, 2021: 7937–7947.
[本文引用: 1]
[23]
AJANTHAN T, RAMASINGHE S, ZUO Y, et al. Nesterov method for asynchronous pipeline parallel optimization [C]// Proceedings of the 42nd International Conference on Machine Learning . Vancouver: PMLR, 2025: 909–924.
[本文引用: 1]
[24]
FAN S, RONG Y, MENG C, et al. DAPPLE: a pipelined data parallel approach for training large models [C]// Proceedings of the 26th ACM SIGPLAN Symposium on Principles and Practice of Parallel Programming . [S.l.]: ACM, 2021: 431–445.
[本文引用: 5]
[25]
LAMY-POIRIER J. Breadth-first pipeline parallelism [C]// Proceedings of the 6th Machine Learning and Systems Conference . Miami: PMLR, 2023, 5: 48–67.
[本文引用: 1]
[26]
LIU Z, CHENG S, ZHOU H, et al. Hanayo: harnessing wave-like pipeline parallelism for enhanced large model training efficiency [C]// Proceedings of the SC23: International Conference for High Performance Computing, Networking, Storage and Analysis . Denver: IEEE, 2024: 1–13.
[27]
QI P, WAN X, HUANG G, et al. Zero bubble (almost) pipeline parallelism [C]// Proceedings of the International Conference on Learning Representations . Vienna: ICLR, 2024: 1–16.
[本文引用: 2]
[28]
JAIN A, AHMAD AWAN A, ALJUHANI A M, et al. GEMS: GPU-enabled memory-aware model-parallelism system for distributed DNN training [C]// Proceedings of the SC20: International Conference for High Performance Computing, Networking, Storage and Analysis . Atlanta: IEEE, 2021: 1–15.
[本文引用: 1]
[29]
LI S, HOEFLER T. Chimera: efficiently training large-scale neural networks with bidirectional pipelines [C]// Proceedings of the SC21: International Conference for High Performance Computing, Networking, Storage and Analysis . St. Louis: IEEE, 2022: 1–14.
[本文引用: 7]
[30]
ZHANG W, ZHOU B, TANG X, et al. MixPipe: efficient bidirectional pipeline parallelism for training large-scale models [C]// Proceedings of the 60th ACM/IEEE Design Automation Conference . San Francisco: IEEE, 2023: 1–6.
[本文引用: 7]
[31]
LIN J, LIU Z, YOU Y, et al. WeiPipe: weight pipeline parallelism for communication-effective long-context large model training [C]// Proceedings of the 30th ACM SIGPLAN Annual Symposium on Principles and Practice of Parallel Programming . Las Vegas: ACM, 2025: 225–238.
[本文引用: 1]
[32]
WU H, CHEN L. TawPipe: topology-aware weight pipeline parallelism for accelerating long-context large models training [C]// Proceedings of the AAAI Conference on Artificial Intelligence . Singapore: AAAI, 2026, 40(32): 26894–26902.
[本文引用: 1]
[33]
赵海燕, 易庆奥, 汤敬华, 等 分布式模型训练中的通信优化方法: 现状及展望
[J]. 小型微型计算机系统 , 2024 , 45 (12 ): 2964 - 2978
DOI:10.20009/j.cnki.21-1106/TP.2024-0123
[本文引用: 1]
ZHAO Haiyan, YI Qing’ao, TANG Jinghua, et al Communication optimization in distributed model training: current research and prospects
[J]. Journal of Chinese Computer Systems , 2024 , 45 (12 ): 2964 - 2978
DOI:10.20009/j.cnki.21-1106/TP.2024-0123
[本文引用: 1]
[34]
LIU W, LU K, LAI Z, et al AutoPipe-H: a heterogeneity-aware data-paralleled pipeline approach on commodity GPU servers
[J]. IEEE Transactions on Computers , 2025 , 74 (4 ): 1196 - 1209
DOI:10.1109/TC.2024.3517748
[本文引用: 1]
[35]
VASWANI A, SHAZEER N, PARMAR N, et al. Attention is all you need [C]// 31st Conference on Neural Information Processing Systems . Long Beach: Curran Associates Inc., 2017: 1–11.
[本文引用: 1]
[36]
DEVLIN J, CHANG M W, LEE K, et al. BERT: pre-training of deep bidirectional transformers for language understanding [C]// Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers) . Minneapolis: ACL, 2019: 4171–4186.
[本文引用: 2]
[37]
BROWN T B, MANN B, RYDER N, et al. Language models are few-shot learners [C]// Proceedings of the 34th International Conference on Neural Information Processing Systems . [S.l.]: Curran Associates Inc., 2020, 33: 1877–1901.
[本文引用: 1]
[38]
PETERSON J, MEYLAN S, BOURGIN D. Open clone of OpenAI’s unreleased webtext dataset scraper [EB/OL]. (2020−08−15)[2025−12−09]. https://github.com/jcpeterson/openwebtext.
[本文引用: 1]
[39]
SUN Z, CAO H, WANG Y, et al. AdaPipe: optimizing pipeline parallelism with adaptive recomputation and partitioning [C]// Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, Volume 3 . La Jolla: ACM, 2024: 86–100.
[本文引用: 1]
[40]
RAJBHANDARI S, RASLEY J, RUWASE O, et al. ZeRO: memory optimizations toward training trillion parameter models [C]// Proceedings of the SC20: International Conference for High Performance Computing, Networking, Storage and Analysis . Atlanta: IEEE, 2020: 1–16.
[本文引用: 1]
1
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
A survey on distributed machine learning
0
2021
并行智能训练技术: 挑战与发展
1
2023
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
1
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
2
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... 传统梯度同步通常在全部反向计算完成后统一执行all-reduce,易在同步过程中产生设备空闲,限制训练效率. 为此,BitPipe引入提前梯度同步策略[29 ] ,将通信与计算过程重叠. 如图4 (a)所示,若按常规方式在本地计算结束后再同步,中间阶段同步(如s6~s7与s2~s3)仅能与首尾阶段的少量计算重叠,重叠深度有限. BitPipe利用流水线调度中固有的空泡时隙提前触发all-reduce,如图4 (b)所示,将s5与s8的同步前移并与后续计算并行,端到端训练时间缩短. 由于每次训练迭代仅进行一次梯度同步,因此该机制理论上在同步频率较高时收益更明显,而在采用降低同步频次策略(如梯度累积[5 ] )时增益相对减弱. ...
7
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
... 传统的流水线并行方法通常将模型按层顺序划分为多个阶段,每个设备独立负责一个阶段. 为了进一步提高设备利用率,交错流水线并行方法(如1F1B-Int[6 ] )采用循环分配策略,将多个较小且非连续的阶段分配到同一设备上,随之而来的是较多的跨设备通信开销. 区别于上述循环划分方式,BitPipe引入V形交错划分策略[27 ] :在对模型阶段进行分配时,先将各阶段从前至后依次映射到各设备,再反向从后至前进行第2轮映射,构成“V”形分配路径. 如图1 所示为在2设备、4阶段、2微批次配置下,循环交错划分与V形交错划分的差异. 可以看出,在保持阶段计算顺序不变的前提下,V形划分将部分连续阶段分配至同一设备,使原本的跨设备通信转化为本地显存访问,理论上可获得不亚于甚至优于原循环划分的通信效率. ...
... Mechanism comparison of synchronous pipeline parallelism methods (number of micro-batches not less than pipeline depth)
Tab.2 流水线方法 模型划分 调度范式 设备映射 同步时机 关键约束 GPipe[7 ] 顺序 单向 顺序 计算后 无 DAPPLE[24 ] 顺序 单向 顺序 计算后 无 1F1B-Int[6 ] 循环 单向交错 顺序 计算后 无 Chimera[29 ] 顺序 双向 顺序 提前同步 $ D $ MixPipe[30 ] 顺序 双向 跨节点优化 提前同步 $ D $ BitPipe V形 双向交错 跨节点优化 提前同步 $ D $
图 3 几种同步流水线并行方法在模型划分与微批次调度上的对比(流水线深度和微批次数均为4) ...
... 统计图3 中各设备空闲时隙与流水线总运行时隙,得出BitPipe引入的空泡总量为$ {(3D-6)/4} $ $ {(D-2)/2} $ $ {(D-2)/4} $ . 基于流水线并行与大模型训练领域反向计算开销约为前向2倍的通用经验假设[6 ,29 -30 ] ,BitPipe的空泡率可进一步表述为$ (D-2)/ (3N+D-2) $ . 如表3 所示为5种同步流水线方法的空泡率,结果表明BitPipe在该指标上最优. 若采用中间空泡消除策略,空泡率可进一步降至$ (D-2)/ (4N+D-2) $ . ...
... Comparison on bubble ratio and memory consumption
Tab.3 流水线方法 空泡率 参数显存 激活值显存 GPipe[7 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ {N\times M}_{\text{a}} $ DAPPLE[24 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ [{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}] $ 1F1B-Int[6 ] $ \dfrac{{D}-1}{2{N}+{D}+1} $ $ {{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+1}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ Chimera[29 ] $ \dfrac{{D}-2}{3{N}/2+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+2}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ BitPipe $ \dfrac{{D}-2}{3{N}+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+3}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $
1.3.3. 显存开销 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
... 为了全面评估性能,将BitPipe与4种主流的同步流水线并行方法进行对比:1) 基于1F1B调度的DAPPLE[24 ] ,2) 采用交错式调度的1F1B-Int[6 ] ,3) 采用双向流水线架构的Chimera[29 ] ,4) 采用新型设备映射策略的双向流水线方法MixPipe[30 ] . BitPipe的实现基于Megatron-LM开源架构,重构了流水线调度器以支持双向交错策略. 所有对比方法均基于PyTorch实现,统一使用NCCL后端进行分布式通信,严格保持全局批大小、梯度累积、混合精度策略、优化器与学习率等设定一致,以确保实验的公平性. ...
5
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... Mechanism comparison of synchronous pipeline parallelism methods (number of micro-batches not less than pipeline depth)
Tab.2 流水线方法 模型划分 调度范式 设备映射 同步时机 关键约束 GPipe[7 ] 顺序 单向 顺序 计算后 无 DAPPLE[24 ] 顺序 单向 顺序 计算后 无 1F1B-Int[6 ] 循环 单向交错 顺序 计算后 无 Chimera[29 ] 顺序 双向 顺序 提前同步 $ D $ MixPipe[30 ] 顺序 双向 跨节点优化 提前同步 $ D $ BitPipe V形 双向交错 跨节点优化 提前同步 $ D $
图 3 几种同步流水线并行方法在模型划分与微批次调度上的对比(流水线深度和微批次数均为4) ...
... Comparison on bubble ratio and memory consumption
Tab.3 流水线方法 空泡率 参数显存 激活值显存 GPipe[7 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ {N\times M}_{\text{a}} $ DAPPLE[24 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ [{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}] $ 1F1B-Int[6 ] $ \dfrac{{D}-1}{2{N}+{D}+1} $ $ {{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+1}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ Chimera[29 ] $ \dfrac{{D}-2}{3{N}/2+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+2}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ BitPipe $ \dfrac{{D}-2}{3{N}+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+3}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $
1.3.3. 显存开销 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
... 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
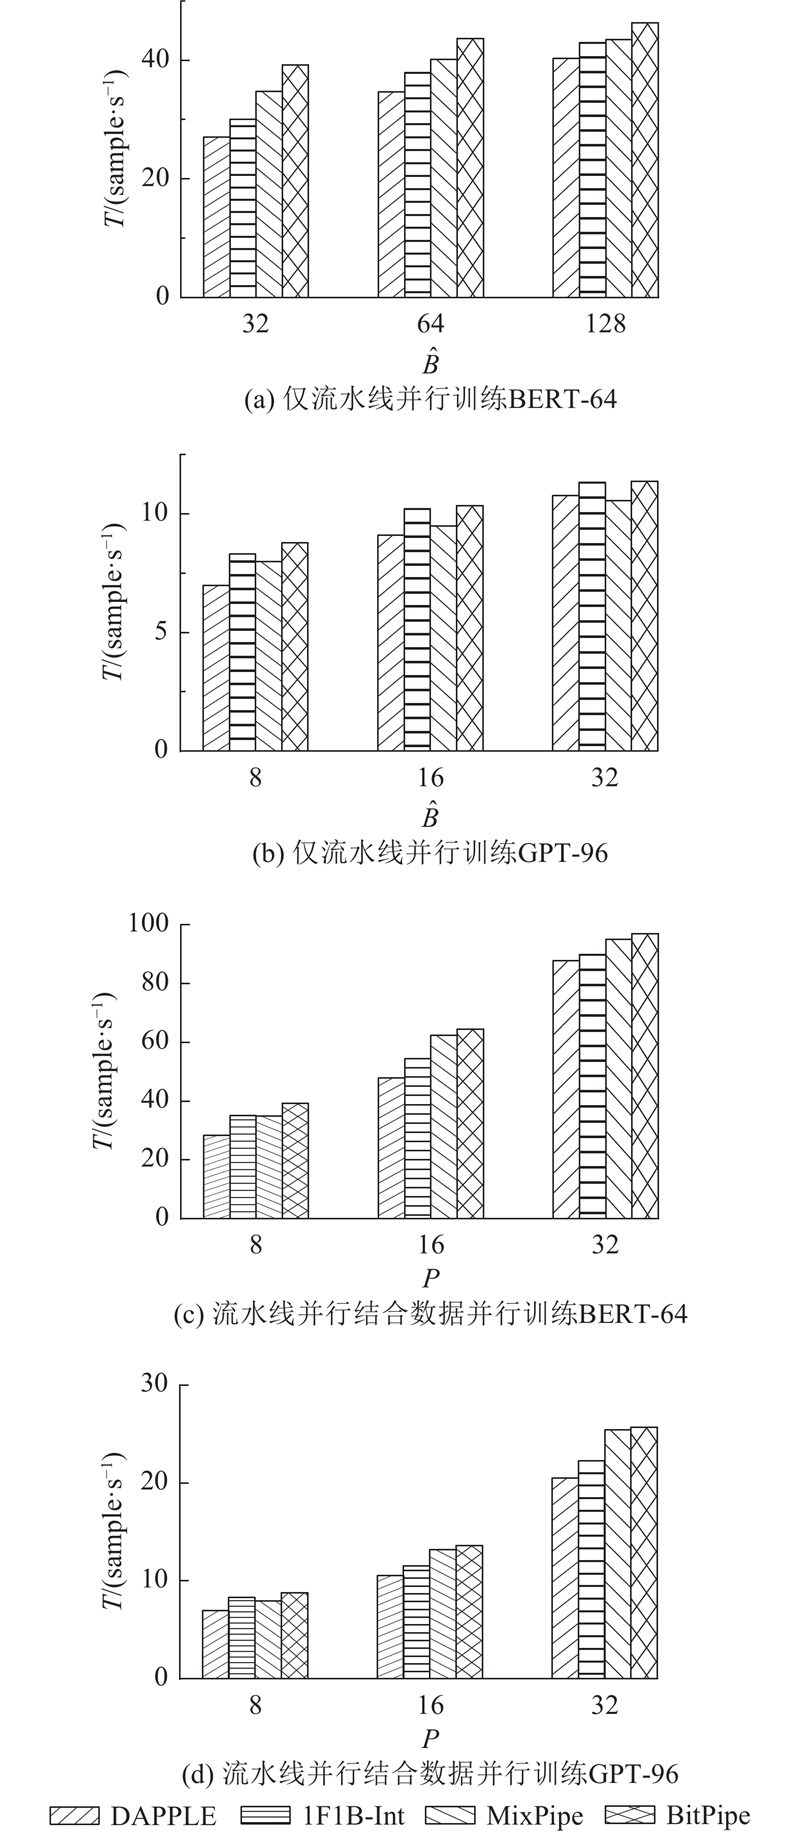
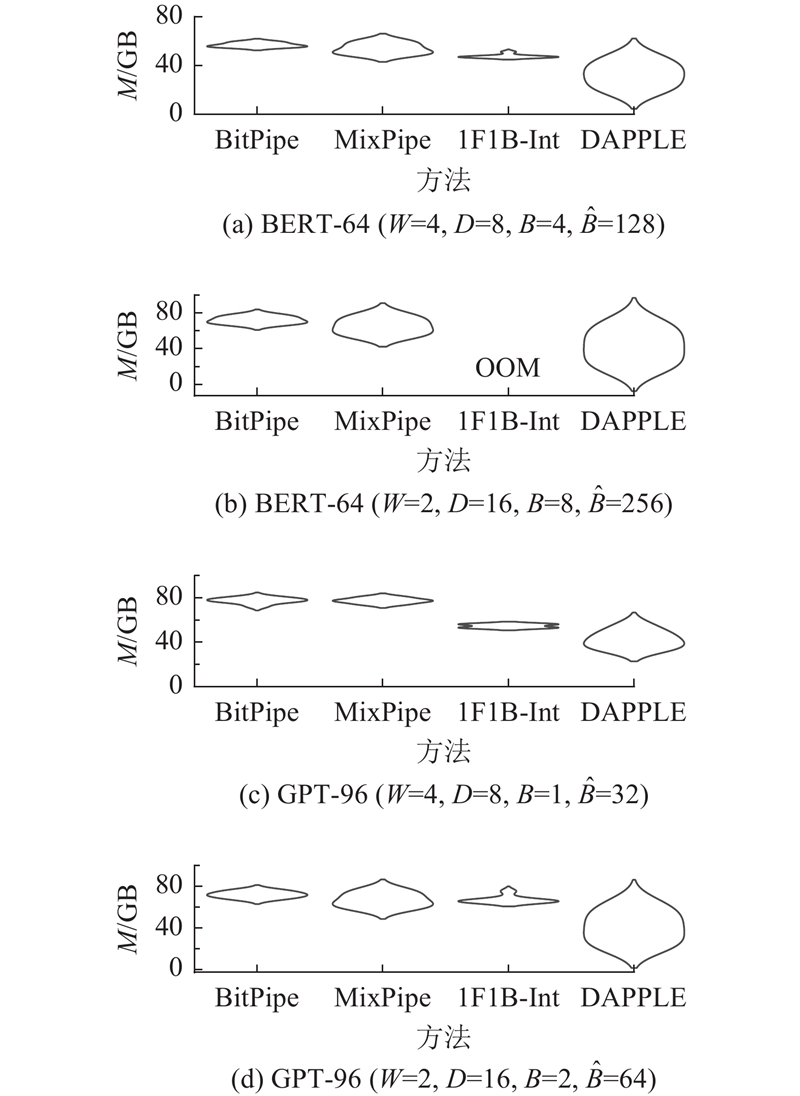
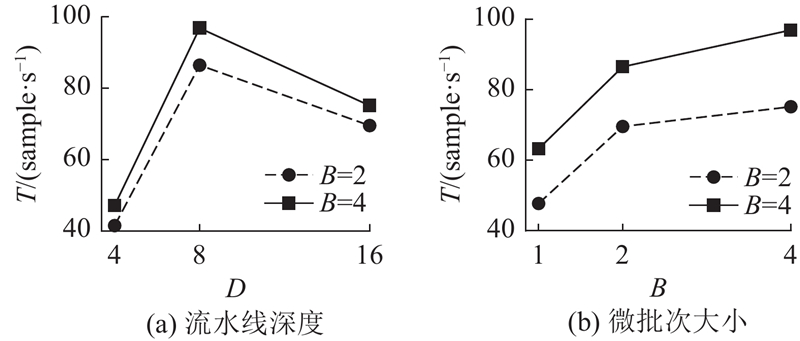
... 在8、16及32 GPU规模下,分别评估纯流水线并行性能以及与数据并行结合后的扩展性. 对每种配置均运行20次迭代,取最后2次迭代的平均运行时间作为结果,以避免流水线预热阶段的影响,反映稳定阶段的性能表现[7 -8 ,39 ] . 设计消融实验与超参数研究,深入分析BitPipe各关键组件的贡献及其对不同超参数配置的敏感性. ...
1
... 在8、16及32 GPU规模下,分别评估纯流水线并行性能以及与数据并行结合后的扩展性. 对每种配置均运行20次迭代,取最后2次迭代的平均运行时间作为结果,以避免流水线预热阶段的影响,反映稳定阶段的性能表现[7 -8 ,39 ] . 设计消融实验与超参数研究,深入分析BitPipe各关键组件的贡献及其对不同超参数配置的敏感性. ...
1
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
3
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... 实验模型基于经典的Transformer架构[35 ] ,选取BERT[36 ] 和GPT-3[37 ] 的2个代表性变体进行评测,具体模型配置如表4 所示. BERT类模型使用WikiPedia数据集[36 ] 进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
... 本研究针对同步流水线并行训练中空泡缩减与通信开销之间的权衡问题,提出双向交错流水线并行方法BitPipe. 在统一调度框架下协同融合双向流水线与交错流水线,通过双向执行结构提升设备并发度,结合V形交错式模型划分、设备映射与提前梯度同步等策略,在提高并行效率的同时有效控制通信开销,实现计算与通信的协同优化. 实验结果表明,在纯流水线并行及混合并行设置下,BitPipe相较于现有同步流水线方法在GPT和BERT类模型训练中均获得稳定的吞吐率提升,在性能与显存开销之间保持良好平衡,为大规模模型训练提供了高效可行的并行方案. 未来工作将从两个方面拓展:结合梯度量化[10 -11 ] 和通信稀疏化[12 ] 技术,进一步降低集合通信与细粒度调度带来的通信开销;引入激活重计算[14 -15 ] 与零冗余优化器[40 ] 缓解显存压力,以支持更大规模模型场景下的高效流水线并行训练. ...
2
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... 本研究针对同步流水线并行训练中空泡缩减与通信开销之间的权衡问题,提出双向交错流水线并行方法BitPipe. 在统一调度框架下协同融合双向流水线与交错流水线,通过双向执行结构提升设备并发度,结合V形交错式模型划分、设备映射与提前梯度同步等策略,在提高并行效率的同时有效控制通信开销,实现计算与通信的协同优化. 实验结果表明,在纯流水线并行及混合并行设置下,BitPipe相较于现有同步流水线方法在GPT和BERT类模型训练中均获得稳定的吞吐率提升,在性能与显存开销之间保持良好平衡,为大规模模型训练提供了高效可行的并行方案. 未来工作将从两个方面拓展:结合梯度量化[10 -11 ] 和通信稀疏化[12 ] 技术,进一步降低集合通信与细粒度调度带来的通信开销;引入激活重计算[14 -15 ] 与零冗余优化器[40 ] 缓解显存压力,以支持更大规模模型场景下的高效流水线并行训练. ...
降低分布式训练通信的梯度稀疏压缩方法
1
2021
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
2
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
... 本研究针对同步流水线并行训练中空泡缩减与通信开销之间的权衡问题,提出双向交错流水线并行方法BitPipe. 在统一调度框架下协同融合双向流水线与交错流水线,通过双向执行结构提升设备并发度,结合V形交错式模型划分、设备映射与提前梯度同步等策略,在提高并行效率的同时有效控制通信开销,实现计算与通信的协同优化. 实验结果表明,在纯流水线并行及混合并行设置下,BitPipe相较于现有同步流水线方法在GPT和BERT类模型训练中均获得稳定的吞吐率提升,在性能与显存开销之间保持良好平衡,为大规模模型训练提供了高效可行的并行方案. 未来工作将从两个方面拓展:结合梯度量化[10 -11 ] 和通信稀疏化[12 ] 技术,进一步降低集合通信与细粒度调度带来的通信开销;引入激活重计算[14 -15 ] 与零冗余优化器[40 ] 缓解显存压力,以支持更大规模模型场景下的高效流水线并行训练. ...
1
... 随着深度学习模型规模的持续扩大,受限于单个设备的显存容量与计算能力,传统单机训练方式已难以满足大模型训练需求,推动了分布式训练技术的快速发展[1 -3 ] . 围绕大模型高效训练,学术界与工业界提出数据并行[4 -5 ] 、张量并行[6 ] 与流水线并行[7 -9 ] 等多种并行范式,并结合梯度量化[10 -11 ] 、稀疏化[12 -13 ] 、重计算与参数卸载[14 -15 ] 等系统级优化技术,逐步形成以Megatron-LM[16 ] 和DeepSpeed[17 ] 为代表的成熟训练框架. 流水线并行通过将模型划分为多个阶段并映射至不同设备,结合微批次调度,在保持训练语义一致性的同时有效缓解单设备显存压力,已成为支持大规模模型训练的重要技术路径. ...
Distributed training of deep learning models: a taxonomic perspective
1
2020
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
Advances of pipeline model parallelism for deep learning training: an overview
0
2024
大模型训练的混合并行技术综述
1
2026
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
1
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
5
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
... Mechanism comparison of synchronous pipeline parallelism methods (number of micro-batches not less than pipeline depth)
Tab.2 流水线方法 模型划分 调度范式 设备映射 同步时机 关键约束 GPipe[7 ] 顺序 单向 顺序 计算后 无 DAPPLE[24 ] 顺序 单向 顺序 计算后 无 1F1B-Int[6 ] 循环 单向交错 顺序 计算后 无 Chimera[29 ] 顺序 双向 顺序 提前同步 $ D $ MixPipe[30 ] 顺序 双向 跨节点优化 提前同步 $ D $ BitPipe V形 双向交错 跨节点优化 提前同步 $ D $
图 3 几种同步流水线并行方法在模型划分与微批次调度上的对比(流水线深度和微批次数均为4) ...
... Comparison on bubble ratio and memory consumption
Tab.3 流水线方法 空泡率 参数显存 激活值显存 GPipe[7 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ {N\times M}_{\text{a}} $ DAPPLE[24 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ [{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}] $ 1F1B-Int[6 ] $ \dfrac{{D}-1}{2{N}+{D}+1} $ $ {{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+1}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ Chimera[29 ] $ \dfrac{{D}-2}{3{N}/2+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+2}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ BitPipe $ \dfrac{{D}-2}{3{N}+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+3}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $
1.3.3. 显存开销 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
... 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
... 为了全面评估性能,将BitPipe与4种主流的同步流水线并行方法进行对比:1) 基于1F1B调度的DAPPLE[24 ] ,2) 采用交错式调度的1F1B-Int[6 ] ,3) 采用双向流水线架构的Chimera[29 ] ,4) 采用新型设备映射策略的双向流水线方法MixPipe[30 ] . BitPipe的实现基于Megatron-LM开源架构,重构了流水线调度器以支持双向交错策略. 所有对比方法均基于PyTorch实现,统一使用NCCL后端进行分布式通信,严格保持全局批大小、梯度累积、混合精度策略、优化器与学习率等设定一致,以确保实验的公平性. ...
1
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
2
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
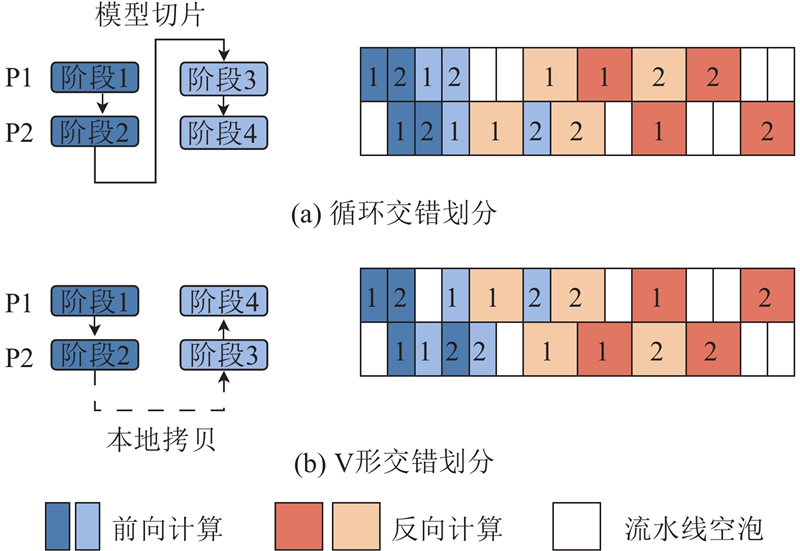
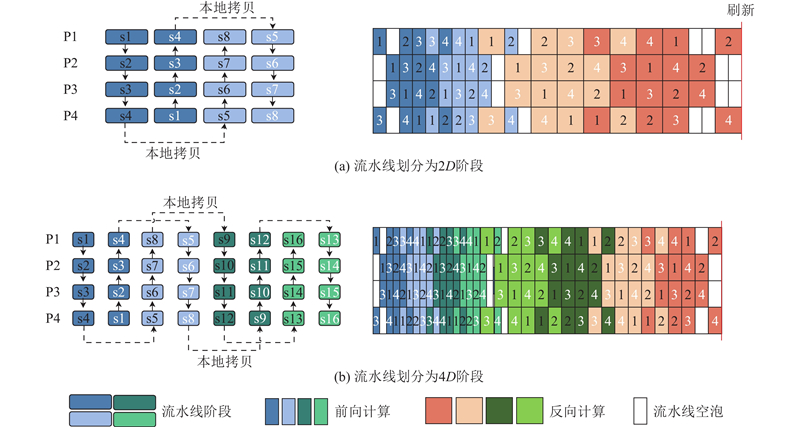
... 传统的流水线并行方法通常将模型按层顺序划分为多个阶段,每个设备独立负责一个阶段. 为了进一步提高设备利用率,交错流水线并行方法(如1F1B-Int[6 ] )采用循环分配策略,将多个较小且非连续的阶段分配到同一设备上,随之而来的是较多的跨设备通信开销. 区别于上述循环划分方式,BitPipe引入V形交错划分策略[27 ] :在对模型阶段进行分配时,先将各阶段从前至后依次映射到各设备,再反向从后至前进行第2轮映射,构成“V”形分配路径. 如图1 所示为在2设备、4阶段、2微批次配置下,循环交错划分与V形交错划分的差异. 可以看出,在保持阶段计算顺序不变的前提下,V形划分将部分连续阶段分配至同一设备,使原本的跨设备通信转化为本地显存访问,理论上可获得不亚于甚至优于原循环划分的通信效率. ...
1
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
7
... BitPipe旨在同步降低流水线空泡并控制通信开销,核心思想是将交错流水线组织为双向执行的2个并行分支,提高设备并发度并增强调度灵活性;同时通过V形交错式模型划分减少跨设备通信,结合设备映射与提前梯度同步对通信过程进行优化,实现计算与通信的有效重叠. 本研究使用的关键符号及含义如表1 所示;采用的约束(如微批数量与流水线深度均为偶数)用于保证双向调度在同步训练语义下无冲突执行,约束设定与既有双向流水线方法(如Chimera[29 ] 和MixPipe[30 ] )一致,有助于简化调度描述与理论分析. 在实际系统中,若不满足上述约束,可通过非对称的微批次分配或插入空微批次进行处理,BitPipe的调度机制仍然适用. ...
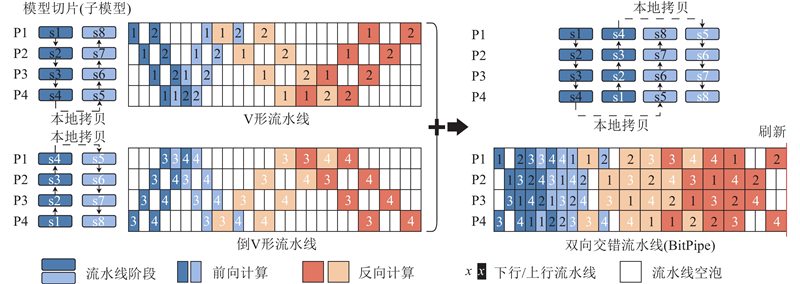
... BitPipe的核心思想是将2条方向相反的V形交错流水线融合到同一组设备上,构成双向执行的2个并行分支,如图2 所示. 为了方便分析,以流水线深度$ D=4 $ $ N/2 $ [29 -30 ] 一致. ...
... Mechanism comparison of synchronous pipeline parallelism methods (number of micro-batches not less than pipeline depth)
Tab.2 流水线方法 模型划分 调度范式 设备映射 同步时机 关键约束 GPipe[7 ] 顺序 单向 顺序 计算后 无 DAPPLE[24 ] 顺序 单向 顺序 计算后 无 1F1B-Int[6 ] 循环 单向交错 顺序 计算后 无 Chimera[29 ] 顺序 双向 顺序 提前同步 $ D $ MixPipe[30 ] 顺序 双向 跨节点优化 提前同步 $ D $ BitPipe V形 双向交错 跨节点优化 提前同步 $ D $
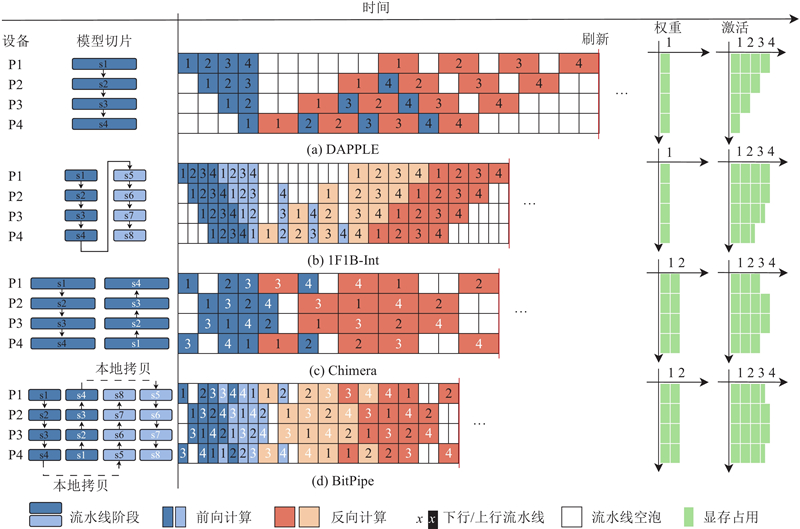
图 3 几种同步流水线并行方法在模型划分与微批次调度上的对比(流水线深度和微批次数均为4) ...
... 统计图3 中各设备空闲时隙与流水线总运行时隙,得出BitPipe引入的空泡总量为$ {(3D-6)/4} $ $ {(D-2)/2} $ $ {(D-2)/4} $ . 基于流水线并行与大模型训练领域反向计算开销约为前向2倍的通用经验假设[6 ,29 -30 ] ,BitPipe的空泡率可进一步表述为$ (D-2)/ (3N+D-2) $ . 如表3 所示为5种同步流水线方法的空泡率,结果表明BitPipe在该指标上最优. 若采用中间空泡消除策略,空泡率可进一步降至$ (D-2)/ (4N+D-2) $ . ...
... Comparison on bubble ratio and memory consumption
Tab.3 流水线方法 空泡率 参数显存 激活值显存 GPipe[7 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ {N\times M}_{\text{a}} $ DAPPLE[24 ] $ \dfrac{D-1}{N+D+1} $ $ {M}_{\text{θ}} $ $ [{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}] $ 1F1B-Int[6 ] $ \dfrac{{D}-1}{2{N}+{D}+1} $ $ {{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+1}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ Chimera[29 ] $ \dfrac{{D}-2}{3{N}/2+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+2}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $ BitPipe $ \dfrac{{D}-2}{3{N}+{D}-2} $ $ 2{{M}}_{\text{θ}} $ $ \left[\dfrac{{D}+3}{2}{{M}}_{\text{a}},{D}\times {{M}}_{\text{a}}\right] $
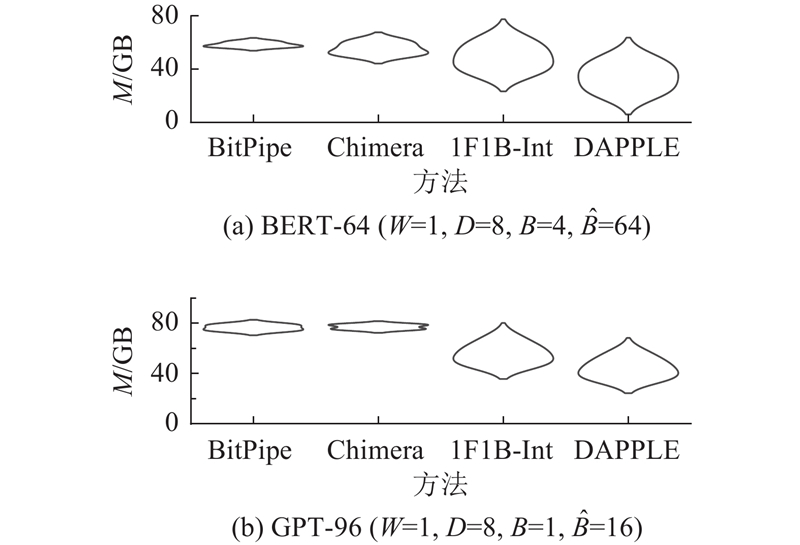
1.3.3. 显存开销 训练过程中的显存开销主要由模型参数和中间激活值构成. 表3 对比了各方法的显存占用情况. 在参数存储方面,GPipe[7 ] 、DAPPLE[24 ] 与1F1B-Int等方法在每个设备上须存储与其阶段对应的1份参数,Chimera与BitPipe因包含2条流水线分支而须存储对应的2份参数. 在激活值存储方面,GPipe由于同时将$ {N} $ $ {N}\geqslant{D} $ $ {N} $ $ {D} $ $ {D} $
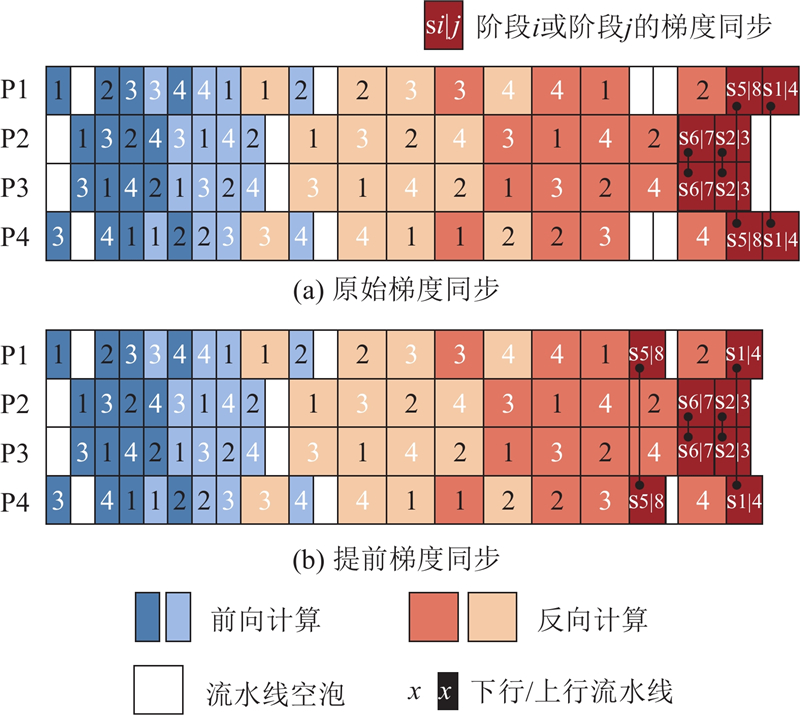
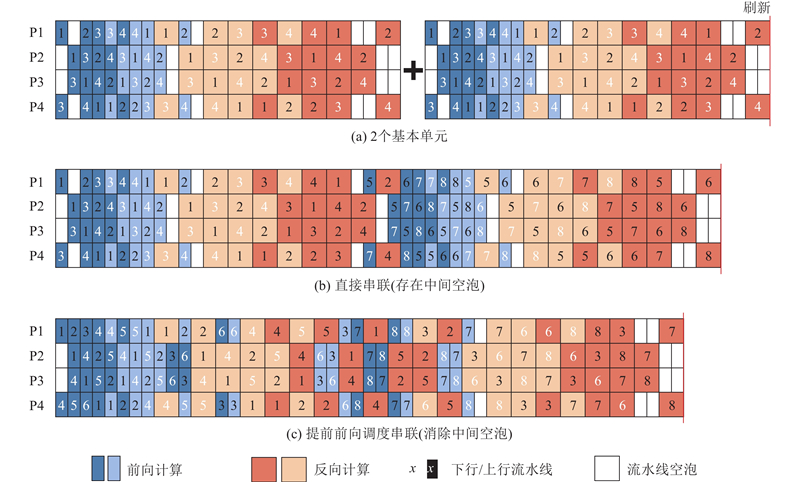
... 传统梯度同步通常在全部反向计算完成后统一执行all-reduce,易在同步过程中产生设备空闲,限制训练效率. 为此,BitPipe引入提前梯度同步策略[29 ] ,将通信与计算过程重叠. 如图4 (a)所示,若按常规方式在本地计算结束后再同步,中间阶段同步(如s6~s7与s2~s3)仅能与首尾阶段的少量计算重叠,重叠深度有限. BitPipe利用流水线调度中固有的空泡时隙提前触发all-reduce,如图4 (b)所示,将s5与s8的同步前移并与后续计算并行,端到端训练时间缩短. 由于每次训练迭代仅进行一次梯度同步,因此该机制理论上在同步频率较高时收益更明显,而在采用降低同步频次策略(如梯度累积[5 ] )时增益相对减弱. ...
... 为了全面评估性能,将BitPipe与4种主流的同步流水线并行方法进行对比:1) 基于1F1B调度的DAPPLE[24 ] ,2) 采用交错式调度的1F1B-Int[6 ] ,3) 采用双向流水线架构的Chimera[29 ] ,4) 采用新型设备映射策略的双向流水线方法MixPipe[30 ] . BitPipe的实现基于Megatron-LM开源架构,重构了流水线调度器以支持双向交错策略. 所有对比方法均基于PyTorch实现,统一使用NCCL后端进行分布式通信,严格保持全局批大小、梯度累积、混合精度策略、优化器与学习率等设定一致,以确保实验的公平性. ...
7
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
... BitPipe旨在同步降低流水线空泡并控制通信开销,核心思想是将交错流水线组织为双向执行的2个并行分支,提高设备并发度并增强调度灵活性;同时通过V形交错式模型划分减少跨设备通信,结合设备映射与提前梯度同步对通信过程进行优化,实现计算与通信的有效重叠. 本研究使用的关键符号及含义如表1 所示;采用的约束(如微批数量与流水线深度均为偶数)用于保证双向调度在同步训练语义下无冲突执行,约束设定与既有双向流水线方法(如Chimera[29 ] 和MixPipe[30 ] )一致,有助于简化调度描述与理论分析. 在实际系统中,若不满足上述约束,可通过非对称的微批次分配或插入空微批次进行处理,BitPipe的调度机制仍然适用. ...
... BitPipe的核心思想是将2条方向相反的V形交错流水线融合到同一组设备上,构成双向执行的2个并行分支,如图2 所示. 为了方便分析,以流水线深度$ D=4 $ $ N/2 $ [29 -30 ] 一致. ...
... Mechanism comparison of synchronous pipeline parallelism methods (number of micro-batches not less than pipeline depth)
Tab.2 流水线方法 模型划分 调度范式 设备映射 同步时机 关键约束 GPipe[7 ] 顺序 单向 顺序 计算后 无 DAPPLE[24 ] 顺序 单向 顺序 计算后 无 1F1B-Int[6 ] 循环 单向交错 顺序 计算后 无 Chimera[29 ] 顺序 双向 顺序 提前同步 $ D $ MixPipe[30 ] 顺序 双向 跨节点优化 提前同步 $ D $ BitPipe V形 双向交错 跨节点优化 提前同步 $ D $
图 3 几种同步流水线并行方法在模型划分与微批次调度上的对比(流水线深度和微批次数均为4) ...
... 统计图3 中各设备空闲时隙与流水线总运行时隙,得出BitPipe引入的空泡总量为$ {(3D-6)/4} $ $ {(D-2)/2} $ $ {(D-2)/4} $ . 基于流水线并行与大模型训练领域反向计算开销约为前向2倍的通用经验假设[6 ,29 -30 ] ,BitPipe的空泡率可进一步表述为$ (D-2)/ (3N+D-2) $ . 如表3 所示为5种同步流水线方法的空泡率,结果表明BitPipe在该指标上最优. 若采用中间空泡消除策略,空泡率可进一步降至$ (D-2)/ (4N+D-2) $ . ...
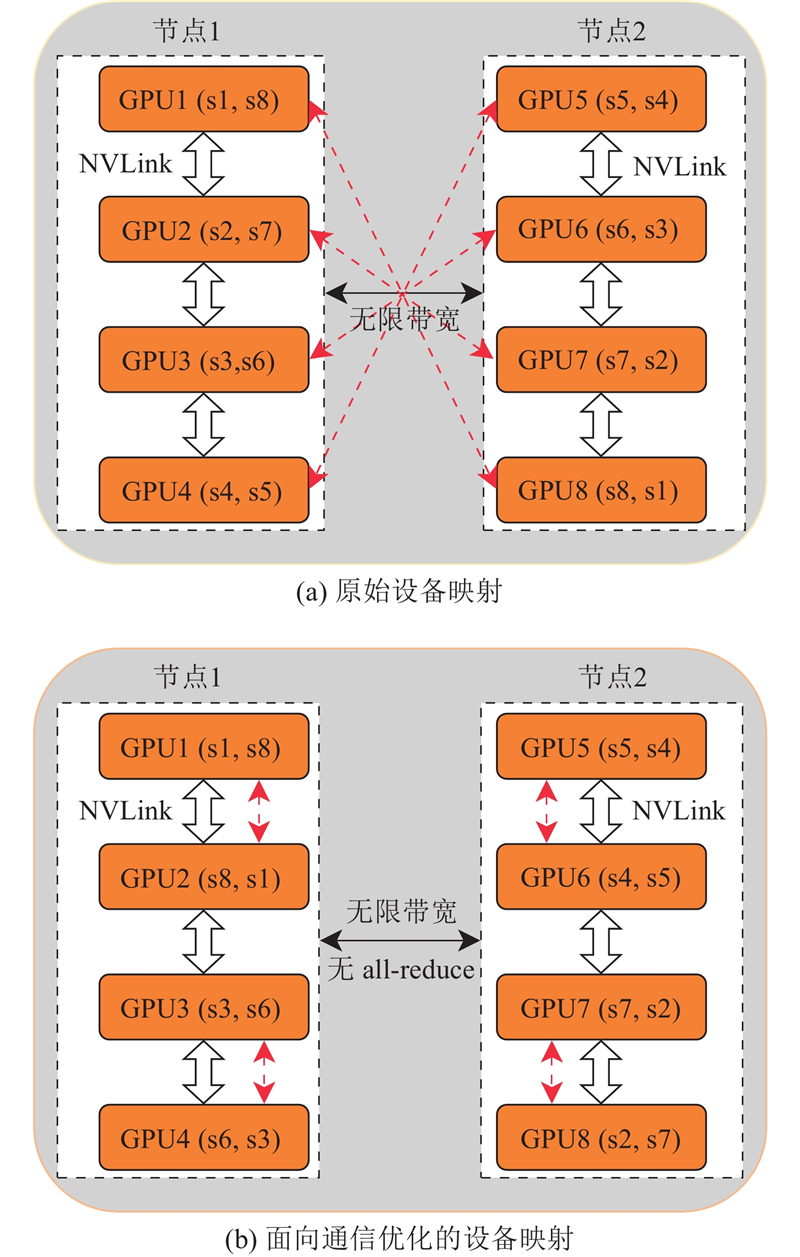
... 为了进一步提升通信效率,结合跨设备模型映射的相关思路[30 ,34 ] ,设计适用于双向交错流水线结构的设备映射策略. 该策略总体原则:将同一流水线阶段在数据并行组内及双向流水线中的副本优先映射至同一物理节点内的设备上. 如图5 所示,该设计使得重量级的梯度同步可利用节点内高速网络(如NVLink)完成,相对轻量级的激活值传递则经由节点间网络进行. 这种映射策略与BitPipe的双向交错调度方式相配合,使高开销集合通信尽量局部化、低开销P2P通信跨节点化,从而在不改变调度语义的前提下改善通信路径结构,缩短关键通信阶段的等待时间. ...
... 为了全面评估性能,将BitPipe与4种主流的同步流水线并行方法进行对比:1) 基于1F1B调度的DAPPLE[24 ] ,2) 采用交错式调度的1F1B-Int[6 ] ,3) 采用双向流水线架构的Chimera[29 ] ,4) 采用新型设备映射策略的双向流水线方法MixPipe[30 ] . BitPipe的实现基于Megatron-LM开源架构,重构了流水线调度器以支持双向交错策略. 所有对比方法均基于PyTorch实现,统一使用NCCL后端进行分布式通信,严格保持全局批大小、梯度累积、混合精度策略、优化器与学习率等设定一致,以确保实验的公平性. ...
1
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
分布式模型训练中的通信优化方法: 现状及展望
1
2024
... 现有流水线并行方法按梯度更新方式可大致分为同步与异步两类[18 -20 ] . 异步方法[21 -23 ] 可最大限度提升设备利用率,但引入梯度不一致问题,影响了模型收敛稳定性,因此主流研究多聚焦于同步流水线并行. 同步流水线方法受制于阶段间依赖与周期性同步需求,不可避免地引入流水线空泡,导致训练效率受限. 为此,研究者提出多种改进方案,包括基于1F1B(one-forward-one-backward)调度及时释放中间激活显存的流水线并行方法[22 ,24 ] ,通过细粒度阶段划分提升并发度的交错流水线方法[6 ,25 -27 ] ,利用设备内并行降低空泡的双向流水线方法[28 -30 ] 以及替换激活传输降低通信量的权重流水线方法[31 -32 ] . 尽管现有方法改善了流水线并行效率,但改进路径普遍受限于共性瓶颈:流水线空泡抑制机制与通信模式的内在矛盾. 具体而言,为压缩空泡引入的更高并发度设计(如交错流水线的细粒度阶段划分以及双向流水线的设备内并行执行),往往伴随着通信开销的显著增加. 交错流水线由于阶段分布更为离散,须频繁进行设备间协作,引入大量点对点(peer-to-peer,P2P)通信. 双向流水线为维持并行分支的独立执行,须维护额外的模型副本,进而增加集合通信(all-reduce)负担. 权重流水线在高带宽互联环境下,通信优化收益往往出现退化. 上述“空泡−通信”之间的权衡困境,已成为制约大规模模型训练可扩展性与实际吞吐率提升的关键因素. 如何在显著降低流水线空泡的同时,有效抑制由并行度提升所带来的通信开销[33 ] ,是本研究关注并试图解决的核心问题. ...
AutoPipe-H: a heterogeneity-aware data-paralleled pipeline approach on commodity GPU servers
1
2025
... 为了进一步提升通信效率,结合跨设备模型映射的相关思路[30 ,34 ] ,设计适用于双向交错流水线结构的设备映射策略. 该策略总体原则:将同一流水线阶段在数据并行组内及双向流水线中的副本优先映射至同一物理节点内的设备上. 如图5 所示,该设计使得重量级的梯度同步可利用节点内高速网络(如NVLink)完成,相对轻量级的激活值传递则经由节点间网络进行. 这种映射策略与BitPipe的双向交错调度方式相配合,使高开销集合通信尽量局部化、低开销P2P通信跨节点化,从而在不改变调度语义的前提下改善通信路径结构,缩短关键通信阶段的等待时间. ...
1
... 实验模型基于经典的Transformer架构[35 ] ,选取BERT[36 ] 和GPT-3[37 ] 的2个代表性变体进行评测,具体模型配置如表4 所示. BERT类模型使用WikiPedia数据集[36 ] 进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
2
... 实验模型基于经典的Transformer架构[35 ] ,选取BERT[36 ] 和GPT-3[37 ] 的2个代表性变体进行评测,具体模型配置如表4 所示. BERT类模型使用WikiPedia数据集[36 ] 进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
... [36 ]进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
1
... 实验模型基于经典的Transformer架构[35 ] ,选取BERT[36 ] 和GPT-3[37 ] 的2个代表性变体进行评测,具体模型配置如表4 所示. BERT类模型使用WikiPedia数据集[36 ] 进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
1
... 实验模型基于经典的Transformer架构[35 ] ,选取BERT[36 ] 和GPT-3[37 ] 的2个代表性变体进行评测,具体模型配置如表4 所示. BERT类模型使用WikiPedia数据集[36 ] 进行训练,GPT类模型则使用OpenWebText数据集[38 ] . 数据预处理流程与广泛采用的Megatron-LM项目[10 ] 保持一致,以确保对比的公平性与可复现性. ...
1
... 在8、16及32 GPU规模下,分别评估纯流水线并行性能以及与数据并行结合后的扩展性. 对每种配置均运行20次迭代,取最后2次迭代的平均运行时间作为结果,以避免流水线预热阶段的影响,反映稳定阶段的性能表现[7 -8 ,39 ] . 设计消融实验与超参数研究,深入分析BitPipe各关键组件的贡献及其对不同超参数配置的敏感性. ...
1
... 本研究针对同步流水线并行训练中空泡缩减与通信开销之间的权衡问题,提出双向交错流水线并行方法BitPipe. 在统一调度框架下协同融合双向流水线与交错流水线,通过双向执行结构提升设备并发度,结合V形交错式模型划分、设备映射与提前梯度同步等策略,在提高并行效率的同时有效控制通信开销,实现计算与通信的协同优化. 实验结果表明,在纯流水线并行及混合并行设置下,BitPipe相较于现有同步流水线方法在GPT和BERT类模型训练中均获得稳定的吞吐率提升,在性能与显存开销之间保持良好平衡,为大规模模型训练提供了高效可行的并行方案. 未来工作将从两个方面拓展:结合梯度量化[10 -11 ] 和通信稀疏化[12 ] 技术,进一步降低集合通信与细粒度调度带来的通信开销;引入激活重计算[14 -15 ] 与零冗余优化器[40 ] 缓解显存压力,以支持更大规模模型场景下的高效流水线并行训练. ...