



工时定额是企业生产管理和成本控制的核心依据,主要依赖人工估算,存在效率低、主观性强与准确性不足等问题,难以有效指导生产计划和科学报价,无法适配大规模定制的生产需求. 某特种车辆生产企业建立工时定额模型实现工时预测,但多工序工艺文件以非结构化的形式存储于Teamcenter (TC)平台,且工艺文本存在“语义相似但加工逻辑不同,差异化特征未有效区分工时”的问题,导致工时特征因素匹配困难,模型预测精度受限. 在此背景下,如何从这些非结构化的工艺文本数据中挖掘知识,对解决工艺特征匹配困难和提升模型预测精度具有重要研究意义.
机加文本分类技术从非结构化工艺文本中提取关键特征并归类到预定义工艺类别[1],可以为工时定额模型的特征匹配提供同类别数据,实现工时特征的正确匹配,提高工时预测精度[2-4]. 利用深度学习技术实现文本分类(如BERT-CNN[5]、BERT-BiLSTM[6]和ERNIE[7]等)已经成为主流,但工艺文本的描述常混杂参数、代号与自由文本,缺乏统一分隔规则,导致文本结构混乱,关键信息的边界模糊,增加了处理的难度. 有研究者尝试通过多模态特征融合提升分类性能:臧洁等[8]提出融合词向量和字符向量的双通道特征提取方法,用于改进中文短文本的情感分类任务;刘孝保等[9]提出基于多元神经网络融合的分布式资源空间文本分类方法,该方法结合卷积神经网络、双向门控循环单元和注意力机制,在分布式资源空间文本分类任务中实现较高的分类准确率;李嘉欣等[10]提出MiniRBT-BiLSTM-GAT文本分类模型,利用MiniRBT提取局部语义信息,双向长短期记忆网络(BiLSTM)[11]捕捉上下文序列依赖,图注意力网络(GAT)聚焦关键特征,通过标签平滑优化损失函数提高分类性能. 这些方法仍存在局限:1)模型设计多聚焦于局部上下文特征,忽视词性与句法结构对文本逻辑的约束;2)方法聚焦粗粒度的文本分类,无法实现工艺信息的细粒度挖掘. 为了挖掘工艺文本潜在信息,有研究者开始探索多标签分类方法:余明峰等[12]提出基于对比学习增强双注意力机制的多标签文本分类方法,融合自注意力和标签注意力来捕捉文本的结构特征和语义关联,通过多标签对比学习提高分类性能;陆佳丽[13]提出基于BERT-TextCNN的多标签分类方法,根据文本特点设置正则判断规则,分别对标题和正文进行局部语义处理,并将两部分的标签整理去重,确定文本类别; Liu等[14]改进BERT在多标签文本分类任务中的应用,结合标签嵌入和双向注意力机制使分类效果得到提升. 上述多标签方法实现了文本信息的深度挖掘,但构建的单层级分类框架无法解析面向“机加工种-几何特征”的细粒度语义结构. 同时,这类多标签分类方法[12-14]依赖静态标注数据集,在实际生产中,工艺文本随零件设计动态更新,标注成本高昂且模型易因数据分布变化导致泛化性能下降.
本研究提出融合多通道特征与词权聚类的机加工艺文本双层级分类方法. 旨在提升工时预测的精度与现有BERT-CNN和BERT-BiLSTM方法在专业术语识别、细粒度分类与动态数据等方面的适应性和准确度:1)采用多通道技术对输入工艺文本进行多通道的词向量转换与特征提取,搭建工种层级机加文本分类模型,实现以机加工种为标签的粗粒度分类. 2)在工种层级分类基础上,引入词权K-Means算法构建特征层级聚类模型,通过领域词库加权机制降低噪声干扰,实现无标注数据的自适应聚类. 3)建立面向“机加工种-几何特征”的分类词库体系,以标签化形式与原始文本关联,将工艺文本归类到预定义类别,在工时定额模型中实现同词库工时特征的正确匹配,提高工时预测精度.
1. 机加工艺文本特点与处理方法
1.1. 机加工艺文本特点分析
机加工艺文本主要以机加工艺规程为信息载体[3],机加工艺规程通常包含机加工艺过程卡片、刀具明细表以及工艺装置明细表等工艺文件. 本文针对机加工艺过程卡片中的工序内容、工艺参数、零件属性和设备刀具等多维度描述性信息进行文本识别与分类研究. 机加工艺文本特点[15]如下. 1) 词汇强专业性:文本中有大量机械制造领域的专业术语,部分术语语义相近但对应工艺差异显著,如“车平面”与“铣平面”虽表述相似,却分属不同加工工艺;“通孔”与“盲孔”文字表述接近,加工逻辑却截然不同. 同时,词汇具有特定的行业内涵,与日常语言中的通用词汇含义不同,且存在大量缩写,如“Ra”代表表面粗糙度参数,“DTV”代表厚薄差. 2) 表述结构高规范性:为了满足零件生产的技术指导与体系资料审核,工艺文本严格遵循行业标准或企业内部规范进行撰写,句子结构多为简洁的指令式或陈述式,如“粗车凸面”,“检验位置度、锥孔螺栓直径、周向与径向DTV、尺寸”. 3) 特征信息紧密关联性:各工序的加工内容、设备与刀具等工艺信息并非独立存在,如“工序名称与内容”中指定的加工方式,直接决定所需“设备”和“刀具”的类型,这些参数又共同影响“机加工时”的长短. 4)工艺数据的混合性:工艺文本包含如产品代号和工序号的结构化数字信息,也包含工序名称与内容中的非结构化文字描述,还涉及如材料属性和尺寸的半结构化参数,不同类型数据的融合使得文本解析难度大,须针对性设计多维度特征提取策略.
1.2. 机加工艺文本处理
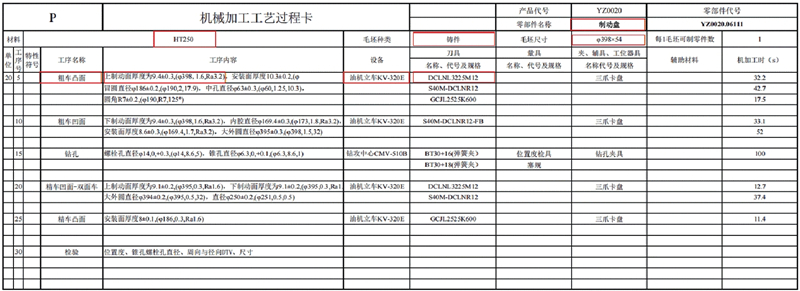
从企业 TC平台业务系统导出机加工艺过程卡片后,1)通过 pdfplumber 打开 PDF 并获取首页内容,从文本中提取材料、毛坯种类和尺寸等全局信息;利用 find_tables () 算子结合识别规则提取表格数据,手动指定 “工序号、加工动作、设备、刀具” 等关键信息的列索引,如图1 所示. 2)通过行解析逻辑关联同一工序的多行列数据,形成以工序为单位的文本序列,同时保留“加工动作-刀具-材料”的工艺关系. 3)构建领域词库,对如“9.4 ±0.3,(
图 1
2. 机加文本分类模型构建
根据机加工艺文本的特点构建多通道双层级机加文本分类模型,作为工时定额模型的数据管理层,解决工时定额模型中工时特征难以匹配与文本结构化整理的问题. 如图2所示,本研究所构建模型主要包括2个部分:多通道工种层级机加文本分类模块与词权特征层级机加文本聚类模块.
图 2
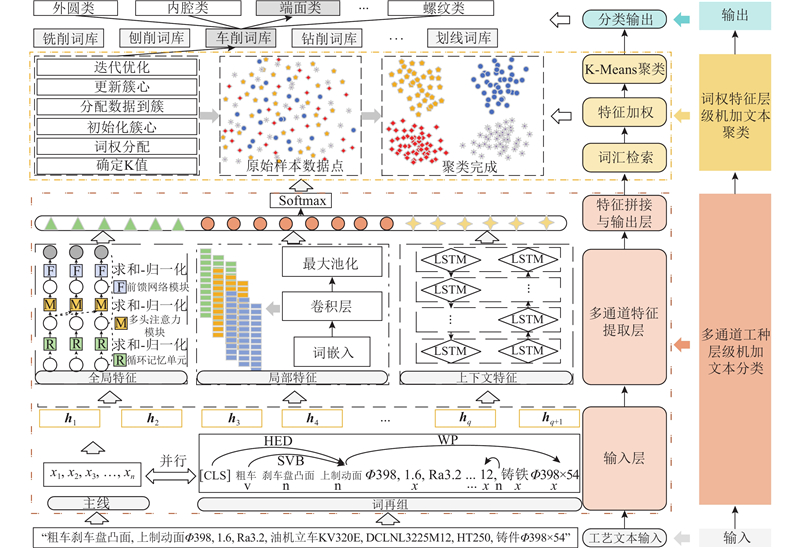
图 2 多通道双层级分类框架图
Fig.2 Multi-channel two-level classification framework diagram
2.1. 多通道工种层级机加文本分类
2.1.1. 输入层
传统方法[18]编码忽略了工艺文本中词性对语义的约束,考虑语义的完整与关键信息的强化,本研究设计主线与词再组的并联通道实现词向量转换,为后续特征提取提供输入,并联通道构建步骤如下. 1)主线通道:直接采用BERT模型对原始输入序列
2.1.2. 多通道特征提取层
设计多通道特征提取模块来捕捉工艺文本上下文信息、局部特征与全局关系. 利用 CNN 捕捉机加工艺文本中的“动词+名词”结构,R-Transformer解决长文本梯度消失问题,BiLSTM 建模工序参数的上下文依赖,三者通过特征拼接实现互补,对融合向量
式中:
(2)全局特征提取. 机加文本常包含长段落描述(如“工种-特征-工艺文本”的工步流程),CNN虽能捕捉局部特征,但对全局信息的捕捉能力有限. 为了增强全局特征提取能力,引入R-Transformer将
通过循环单元更新段间隐藏状态
(3)上下文特征提取. 考虑工序参数的语义理解依赖前后文信息,在局部与全局特征提取的基础上,引入BiLSTM模块捕捉序列的上下文依赖:将
2.1.3. 特征拼接与输出层
将上述特征向量拼接为最终的融合表示
式中:
2.2. 词权特征层级机加文本聚类
图 3
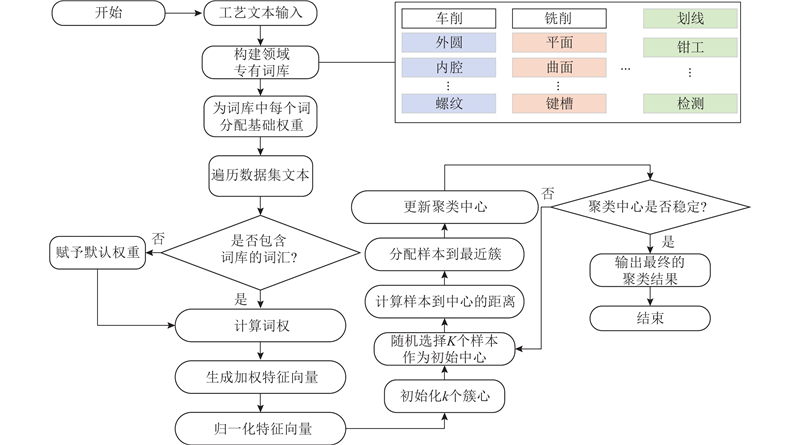
图 3 词权特征层级的机加文本聚类流程
Fig.3 Machining text clustering process at word-weighted feature level
(1) 对于机加文本数据集
(2) 从工艺文件、工时记录和技术手册等来源提取加工对象、几何特征、工艺参数符号、材料与设备共5类核心术语,构建专有词库
其中
(3) 样本数据归一化,将任意特征值转换成
(4)定义
(5) 通过遍历寻找每个样本点与聚类中心的最小距离,求出最小距离对应的聚类中心,将样本点划分为该聚类中心所对应的簇,得到
(6) 根据划分的簇,计算每个簇中样本点向量各维度间的平均值作为最新的聚类中心,更新
式中:
(7) 重复步骤(4)~(6),直到聚类中心不再改变,终止计算.
通过词权 K-Means 完成几何特征的无监督聚类后,模型将相同几何特征标签的工艺数据集整理归类,解决相同工种中,差异化的工时特征未带来工时明显区分的问题,使工时定额模型建立有效匹配规则,提高工时预测精度.
3. 机加文本分类实验
开展机加文本分类实验,包括多通道工种层级机加文本分类模型实验和词权特征层级机加文本聚类模型实验.
3.1. 实验数据
从TC平台的业务系统中抽取部分零件的机加文件作为本次实验数据,实验按“工种-特征”选取车、铣、刨、磨和钻等共计11个工种19类典型的机加工艺数据,数据集中各类别数据分布如表1所示. 为了探究机加文本分类模型在25 348条机加文本数据的分类效果,实验按照3∶1∶1将该数据集分为训练集、验证集和测试集.
表 1 零件机加文本的分类数据
Tab.1
| 标签 | 工种名称 | 样本总数 | 特征 | 样本数量 |
| 1 | 车削 | 2 678 | 外圆类 | 780 |
| 内腔类 | 727 | |||
| 端面类 | 598 | |||
| 螺纹类 | 573 | |||
| 2 | 铣削 | 2 246 | 平面类 | 489 |
| 斜角类 | 397 | |||
| 曲面类 | 438 | |||
| 攻螺纹类 | 484 | |||
| 键槽类 | 438 | |||
| 3 | 刨削 | 1 459 | 平面类 | 773 |
| 沟槽类 | 686 | |||
| 4 | 磨削 | 3 911 | 外圆类 | 2 011 |
| 平面类 | 1 900 | |||
| 5 | 钻削 | 3 945 | 孔类 | 3 945 |
| 6 | 镗削 | 2 090 | 孔类 | 2 090 |
| 7 | 拉削 | 1 607 | 内型面类 | 887 |
| 外型面类 | 720 | |||
| 8 | 倒角 | 1 652 | 标准倒 | 828 |
| 孔口倒 | 824 | |||
| 9 | 钳工 | 2 238 | — | — |
| 10 | 检测 | 1 490 | — | — |
| 11 | 划线 | 2 032 | — | — |
3.2. 实验设置
工种层级与特征层级模型中的参数配置会影响分类模型的性能与分类的准确率,本实验通过不断调整工种层级模型结构,遍历多种参数组合,采用交叉验证的方式确定工种层级分类模型的最佳模型参数:卷积核尺寸为(2,3,4),配置卷积核数量为256;隐藏层维度均设为256;词嵌入维度为768;批处理量为128;学习率为0.000 01;dropout为0.3.
在词权特征层级分类模型中,K 值与特征加权系数的选择直接影响工艺数据聚类的效果,本研究依据分类体系中几何特征的最大类别数,确定最优簇数量的最大值为5,确保覆盖所有工种特征;特征加权系数则按照式(4)的词权计算逻辑,经多组实验对比配置特征加权系数为10,解决核心术语整体权重占比低的问题.
实验环境:处理器为13th Gen Intel(R) Core(TM) i5-13400F,CPU频率为 2.50 GHz,RAM为16.00 GB,GPU为NVIDIA GeForce RTX 4060,操作系统为Windows 10(64位),程序设计语言为Python 3.8.20,深度学习框架为 PyTorch 2.4.1.
3.3. 实验结果与分析
3.3.1. 多通道工种层级分类模型
为了充分验证多通道工种层级机加文本分类模型(以下简称WE-GCL-MCTF)的有效性,在机加文本分类实验中分别采取准确率Acc、损失值rL、召回率R与F1值作为评估指标. 在相同的零件机加工艺数据集上,实验对比TextCNN[21]、ERNIE[22]和BERT[23]等单一模型,其他对比模型为相关研究模型,具体描述如下. TextCNN模型基于CNN,使用卷积层来捕捉文本中不同长度的关键信息. ERNIE是百度推出的基于知识增强的自然语言处理(NLP)模型系列,专注于中文文本理解与生成任务. BERT模型基于Transformer架构,通过掩码语言模型(MLM)和下一句预测(NSP)任务进行预训练,生成高质量的文本表示. WFDR_MGMCHNN[16]模型使用Word2vec 预训练字符与词级双粒度词向量,A3C 框架构 MDP,以损失负数为奖励,对词向量、融合特征双重强化,再经 TextCNN 提字符级局部特征,RCNN 提词级全局特征,BN 消除分布差异后融合,最终用全连接层+softmax 完成分类. MACNN[24]模型使用字符粒度与词粒度向量先分别输入各自对应的 BiLSTM 模型,再通过注意力机制对输出的特征进行权重分配,最后将多粒度词嵌入向量与经注意力加权后的特征向量一同输入CNN,实现特征提取与向量拼接融合. CNN-BiLSTM-Att [25]模型采用BERT进行词和标签表示后,输入CNN提取局部特征,再输入 BiLSTM 融合上下文特征,加入注意力机制为每个标签选择重要特征并加权.不同模型的分类结果如表2所示. 实验得到不同模型在测试集上的准确率、损失值与迭代次数NI的之间的关系分别如图4和图5所示. 实验结果表明,本研究提出的模型在机加工艺文本分类任务中显著优于对比模型.
表 2 分类模型的性能对比
Tab.2
| 分类模型 | Acc/% | rL | R/% | F1/% |
| TextCNN | 60.04 | 1.50 | 51.34 | 50.52 |
| ERNIE | 65.61 | 1.20 | 63.73 | 64.00 |
| BERT | 85.23 | 0.77 | 83.84 | 84.50 |
| WFDR_MGMCHNN | 86.74 | 0.77 | 85.27 | 85.82 |
| MACC | 87.24 | 0.69 | 85.90 | 86.41 |
| CNN-BiLSTM-Att | 87.14 | 0.71 | 85.79 | 86.33 |
| WE-GCL-MCTF | 89.44 | 0.59 | 88.33 | 88.90 |
图 4
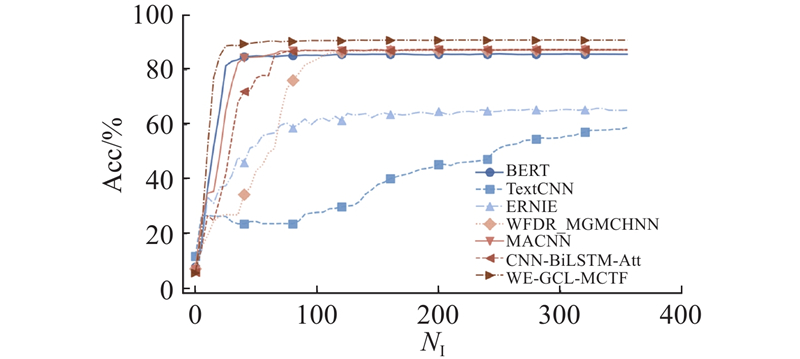
图 4 不同模型分类准确率随迭代次数的变化曲线
Fig.4 Classification accuracy curves of different models versus number of iterations
图 5
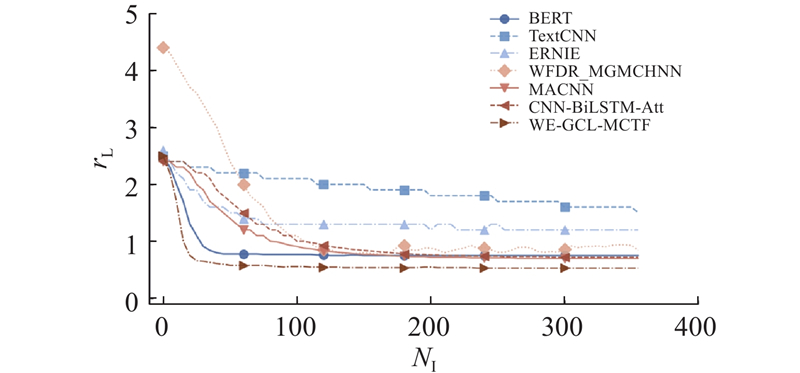
图 5 不同模型分类损失随迭代次数的变化曲线
Fig.5 Classification loss curves of different models versus number of iterations
(1)分类性能. 由表2可知,在相同数据上,相比TextCNN的准确率、召回率与F1值,ERNIE和BERT的对应指标都有显著提升. 原因在于TextCNN仅依赖卷积层捕捉局部特征,难以充分挖掘文本深层语义,ERNIE与BERT基于预训练的上下文感知模型,能够为工艺文本提供更优的语义表征基础. WFDR_MGMCHNN 模型结合 TextCNN、RCNN技术捕捉字符级局部与词级全局特征,准确率较 BERT 与ERNIE分别提升了1.51个百分点与21.13个百分点,证明模型多特征提取策略与模型联合优化方法,能够有效弥补单一特征表征的不足,有助于提升分类准确率. MACC与CNN-BiLSTM-Att模型准确率分别达到 87.24%和87.14%,较 WFDR_MGMCHNN 模型分别提升了0.5个百分点与0.4个百分点,且F1 值均超过86%,证明更优的语义表征基础与模型联合优化策略对提升工艺文本分类精度的可行性. 基于上述,WE-GCL-MCTF引入BERT预训练语义表征作为基础,根据文本结构增强专业术语快速理解,并通过式(1)捕捉局部短语,式(2)捕捉全局关系,式(3)捕捉上下文信息,使得模型的准确率、召回率、F1值较MACC 模型分别提升了2.2个百分点、2.43个百分点和2.49个百分点.
3.3.2. 词权特征层级聚类模型
为了评估词权特征层级聚类模型(以下简称W-KM)的性能,引入轮廓分数与CH Score. 轮廓分数的取值范围为
表 3 词权特征层级聚类结果
Tab.3
| 模型 | 轮廓分数 | CH Score |
| K-Means | 0.44 | 278.30 |
| W-KM | 0.89 | 1 631.64 |
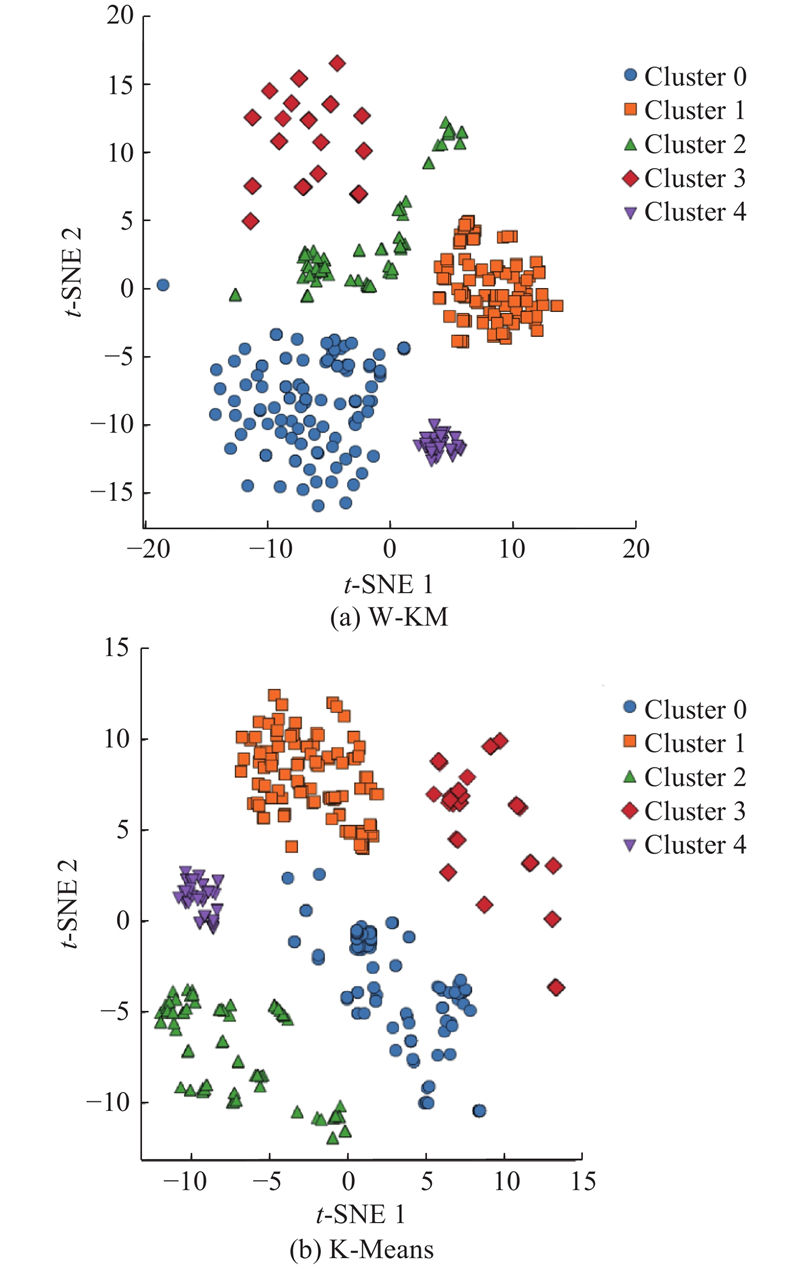
保留数据点之间的局部相似性,将高维数据映射到二维空间,并与K-Means进行比较,结果如图6所示. W-KM的5个簇在二维空间中边界清晰、分布规整,仅少数样本位于簇边缘;K-Means簇间交叠明显、边界模糊,证明W-KM能更准确地保留数据点间的局部相似性,聚类效果优于K-Means.
图 6
3.4. 消融实验
3.4.1. 多通道工种层级机加文本分类模型
在机加工艺数据集下,对WE-GCL-MCTF进行消融实验. 使用相同的预训练模型分别对在单通道、双通道和三通道情况下,逐个改变模块对模型的影响程度,实验结果如表4所示. 在单通道中,CNN 在捕捉“动词+名词”局部短语时表现较好,但因缺乏上下文依赖而对长工序描述的适应性不足;BiLSTM 通过双向建模提升参数关联性,但全局流程建模能力有限; R-Transformer 凭借分段自注意力机制在长文本分类任务中表现最优. 在双通道中,CNN 与 BiLSTM 的融合使准确度提升至 87.22%,验证了加工动作与参数依赖联合建模的重要性. 三通道融合模型,即WE-GCL-MCTF通过整合局部、上下文与全局特征,准确度达到 89.44%,较最优双通道模型提升了 2.22个百分点,证明了特征融合策略的协同增效作用.
表 4 工种层级分类模型消融实验数据
Tab.4
| 预训练 模型 | 通道类型 | 通道模型 | Acc/% | rL | R/% | F1/% |
| BERT | 单通道 | CNN | 85.05 | 0.78 | 83.65 | 84.31 |
| BiLSTM | 85.09 | 0.91 | 83.69 | 84.38 | ||
| R-Transformer | 85.57 | 0.76 | 84.12 | 84.82 | ||
| 双通道 | CNN-BiLSTM | 87.22 | 0.71 | 85.86 | 86.40 | |
| CNN-R-Transformer | 87.08 | 0.71 | 85.73 | 86.26 | ||
| BiLSTM-R-Transformer | 87.14 | 0.69 | 85.79 | 86.30 | ||
| 三通道 | WE-GCL-MCTF | 89.44 | 0.59 | 88.33 | 88.90 |
3.4.2. 词权特征层级机加文本聚类模型
在机加车削工艺数据集下,对W-KM进行消融实验. 使用相同的评估指标分别对比传统K-Means、无词权K-Means与W-KM,逐个改变模块判断对模型的影响程度,实验结果如表5所示. 传统 K-Means 因未考虑领域术语的重要性,聚类结果受通用词汇干扰严重,导致簇内混杂,轮廓分数为0.44. 无词权 K-Means 通过特征向量降维提升了聚类效果,但因缺乏权重分配,仍无法区分核心特征. W-KM 通过领域词库加权,显著强化了关键术语的区分度,轮廓分数提升至 0.89,CH Score 提升至
表 5 特征层级聚类模型消融实验数据
Tab.5
| 模型 | 轮廓分数 | CH Score |
| 传统 K-Means | 0.44 | 278.30 |
| 无词权 K-Means | 0.63 | 892.15 |
| W-KM | 0.89 |
4. 工程应用
将融合多通道特征与词权聚类的机加工艺文本层级分类方法进行服务封装,开发零件机加文本分类系统,作为工时定额模型的数据管理层. 系统依托TC平台,主要以PyCharm作为集成开发环境,利用JSON与TXT文件构建工艺文本数据库,集成采用Python、PyTorch和Scikit-learn等框架开发文本层级分类服务组件. 如图7所示,通过零件机加文本分类系统,从非结构化工艺文本中提取关键特征,并归类到预定义工艺类别,可以为工时定额模型的特征匹配提供同类别数据,解决机加工艺文本语义相似但加工逻辑不同和差异化特征未有效区分工时的问题,使工时定额模型建立有效匹配规则.
图 7

将该分类系统与工时定额模型进行集成测试,结果如图8所示,其中NS为样本数量,RE为相对误差. 在相同实验环境与设置下,工时定额模型通过同类别数据匹配,工时预测平均相对误差从42.70%降低到38.11%,提高了工时预测精度.
图 8
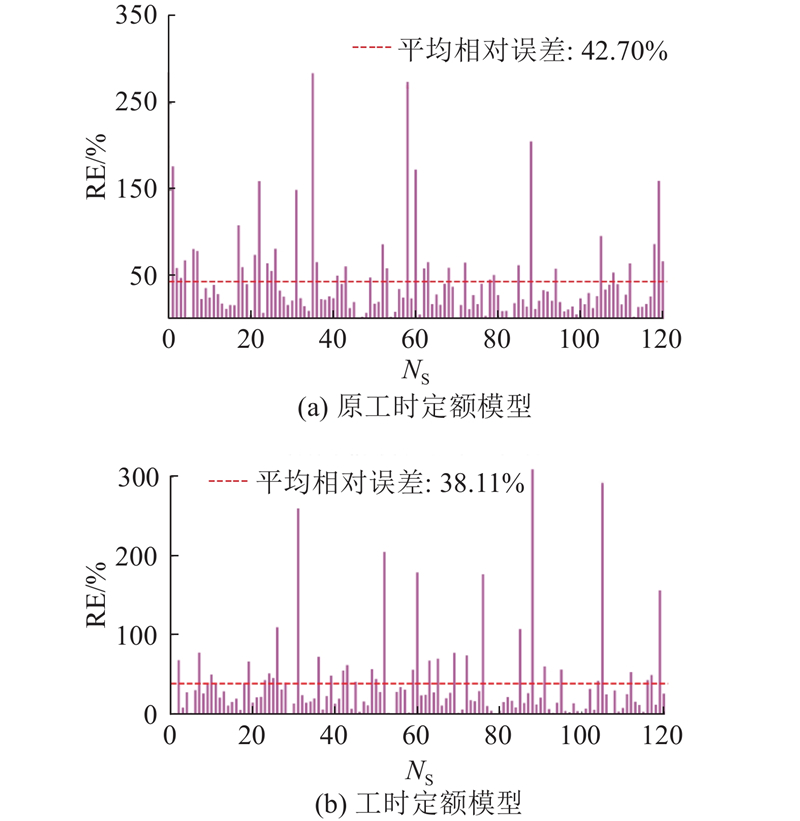
图 8 不同工时定额模型的工时预测效果对比
Fig.8 Comparison of man-hour prediction performance of different man-hour quota models
5. 结 语
本研究1)针对工时预测任务中工时特征匹配问题,提出融合多通道特征与词权聚类的机加工艺文本层级分类方法. 构建工种层级分类模型,解决工艺文本语义相似但加工逻辑不同的问题;构建特征层级聚类模型,解决相同工种中,差异化的工时特征未带来工时明显区分的问题,使工时定额模型建立有效匹配规则,提高工时预测精度. 2)开展机加文本分类实验,实验结果显示,工种层级分类模型在分类性能与收敛速度上优于对比模型;特征层级聚类模型在多个指标上优于传统模型,成功实现面向“工种-特征”的细粒度分类;在工程应用中,所提方法使工时预测平均相对误差降低了4.59个百分点,有效提升了预测精度. 现有模型局限于文本模态,且性能依赖数据的领域规范性. 未来将融入领域知识嵌入与模型微调技术以提升模型的泛化能力;探索视觉信息(如工艺图纸)的融合利用,构建多模态工时预测模型,拓展方法在制造场景的适用范围.
参考文献
基于知识增强的图卷积神经网络的文本分类
[J].
Knowledge-enhanced graph convolutional neural networks for text classification
[J].
基于特征聚类的结构件数控加工工时预测方法
[J].DOI:10.3901/JME.2023.15.232 [本文引用: 2]
Working-hours prediction method of CNC machining of structural parts based on feature clustering
[J].DOI:10.3901/JME.2023.15.232 [本文引用: 2]
基于文本挖掘与神经网络的复杂产品装配工时估算方法
[J].DOI:10.3901/JME.2021.15.199 [本文引用: 1]
Assembly time estimation method for complex products based on text mining and neural network
[J].DOI:10.3901/JME.2021.15.199 [本文引用: 1]
基于知识挖掘的航天产品装配工时定额和管理系统
[J].DOI:10.13196/j.cims.2021.06.006 [本文引用: 1]
Man-hour quota and management system of aerospace product assembly process based on knowledge mining
[J].DOI:10.13196/j.cims.2021.06.006 [本文引用: 1]
A multi-label text classifier at publication level based on “PubMedBERT+TextRNN” for cancer literature
[J].
Utilizing AI to manage rapport: ERNIE Bot’s interpersonal strategies to respond to negative hotel reviews
[J].DOI:10.1016/j.lingua.2024.103874 [本文引用: 1]
融合双通道特征的中文短文本情感分类模型
[J].DOI:10.3778/j.issn.1002-8331.2310-0020 [本文引用: 1]
Chinese short text sentiment classification model integrating dual-channel features
[J].DOI:10.3778/j.issn.1002-8331.2310-0020 [本文引用: 1]
基于多元神经网络融合的分布式资源空间文本分类研究
[J].DOI:10.13196/j.cims.2020.01.017 [本文引用: 1]
Distributed resource spatial text classification based on multivariate neural network fusion
[J].DOI:10.13196/j.cims.2020.01.017 [本文引用: 1]
基于MiniRBT-LSTM-GAT与标签平滑的台区电力工单分类
[J].DOI:10.11772/j.issn.1001-9081.2024040533 [本文引用: 1]
Power work order classification in substation area based on MiniRBT-LSTM-GAT and label smoothing
[J].DOI:10.11772/j.issn.1001-9081.2024040533 [本文引用: 1]
Hybrid RNN based text classification model for unstructured data
[J].DOI:10.1007/s42979-024-03091-x [本文引用: 1]
基于对比学习增强双注意力机制的多标签文本分类方法
[J].DOI:10.11772/j.issn.1001-9081.2024070909 [本文引用: 2]
Multi-label text classification method based on contrastive learning enhanced dual-attention mechanism
[J].DOI:10.11772/j.issn.1001-9081.2024070909 [本文引用: 2]
基于Bert-TextCNN的开源威胁情报文本的多标签分类方法
[J].DOI:10.12379/j.issn.2096-1057.2024.08.10 [本文引用: 1]
Multi-label classification method of open source threat intelligence text based on Bert-TextCNN
[J].DOI:10.12379/j.issn.2096-1057.2024.08.10 [本文引用: 1]
Label-embedding bi-directional attentive model for multi-label text classification
[J].DOI:10.1007/s11063-020-10411-8 [本文引用: 2]
面向机加工艺规程文本的实体识别模型
[J].DOI:10.3724/SP.J.1089.2024.19732 [本文引用: 1]
Named entity recognition method for process planning text
[J].DOI:10.3724/SP.J.1089.2024.19732 [本文引用: 1]
基于多粒度通道和双重强化的文本分类
[J].DOI:10.13245/j.hust.240402 [本文引用: 2]
Text classification based on multi-granularity channels and double reinforcement
[J].DOI:10.13245/j.hust.240402 [本文引用: 2]
基于特征融合动态图网络的多标签文本分类算法
[J].DOI:10.13328/j.cnki.jos.007229 [本文引用: 1]
Multi-label text classification algorithm based on feature-fused dynamic graph network
[J].DOI:10.13328/j.cnki.jos.007229 [本文引用: 1]
Text classification by CEFR levels using machine learning methods and the BERT language model
[J].DOI:10.3103/S0146411624700329 [本文引用: 1]
Research on public service request text classification based on BERT-BiLSTM-CNN feature fusion
[J].DOI:10.3390/app14146282 [本文引用: 1]
Hierarchical text classification: fine-tuned GPT-2 vs BERT-BiLSTM
[J].DOI:10.2478/acss-2025-0005 [本文引用: 1]
基于深度学习的录音文本分类方法
[J].
Method with recording text classification based on deep learning
[J].
Improved Chinese short text classification method based on ERNIE_BiGRU model
[J].DOI:10.1088/1742-6596/1993/1/012038 [本文引用: 1]
A complex history browsing text categorization method with improved BERT embedding layer
[J].DOI:10.1007/s10489-025-06298-4 [本文引用: 1]
Chinese short text classification with mutual-attention convolutional neural networks
[J].
CNN-BiLSTM-Attention: a multi-label neural classifier for short texts with a small set of labels
[J].DOI:10.1016/j.ipm.2023.103320 [本文引用: 1]


